国内首个国产卡训推万亿大模型美团LongCat-2.0开源!(在新窗口打开)
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
共 94 篇
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
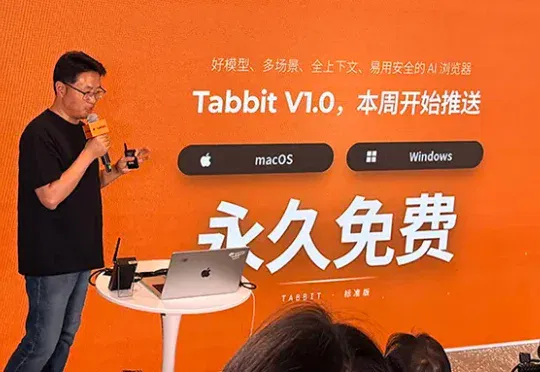
今日,美团GN06(原光年之外)团队正式发布AI浏览器Tabbit V1.0,并承诺核心功能将永久免费开放。Tabbit自3月2日开放公测至今,正好是100天,每周迭代,共迭代12个版本,收获了大量用户好评,比如“Windows上最好看的浏览器”、“特别务实的工具产品”、“低门槛且安全稳定地用到头部模型的方式”等等。
Mindverse 完成由美团领投的 A 轮融资,元禾璞华、韶音、变量资本和老股东追加跟投。Mindverse (心洲科技) 是少数把赌注押在模型「内部」的一家创企,它在通用大模型的基础上,用强化学习让它从复杂、多步骤的真实任务中学会如何把事做成,让模型从「知道很多」变为「能办好事」。
就在今天,美团龙猫大模型团队突然开源了商用级数字人视频生成模型 LongCat-Video-Avatar 1.5。在权威评测中,它的用户偏好胜率全面超越 Kling Avatar 2.0、OmniHuman-1.5 和 HeyGen 这三个头部玩家,并且直接以 MIT 协议开放,连商用限制都懒得设。
一边是 DeepSeek。2026 年 4 月 24 日,正式发布新一代模型DeepSeek-V4 系列预览版,并同步开源。另一边,美团闷声干了件大事——用全国产算力集群,训练出了万亿参数大模型 LongCat-2.0 系列预览版( LongCat-2.0-Preview )。
前华为自动驾驶CTO、天才少年创办。 智东西4月16日报道,今天,上海具身智能创企它石智航宣布完成超4.5亿美元(约合人民币30.69亿元)Pre-A轮融资,创下中国具身智能有史以来最高单轮融资纪录。 本轮融资的投资机构涵盖了四大维度: 财务投资者:高瓴创投、红杉中国联合领投,美团龙珠、中金资本、凯联资本、东方富海、钧山投资等知名财务基金跟投;战略投资者:美团战投作为该公司重要的基石战略股东重额加注并继续联合领投,同时启明创投、线性资本、蓝驰创投、襄禾资本、洪泰基金等老股东也进行了战略投资加注;产业投资者:TCL产投、孚腾资本、首程控股(0697.HK)、建发新兴投资、恒旭资本、国汽投资参投;
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
当所有人盯着大模型时,美团看到了什么? 「为了保持企业有 Day1 的活力,你必须快速做出好的决策。这对初创企业来说或许很容易,但对大型组织来说却极具挑战。」2016 年,亚马逊创始人贝索斯在股东大会上回应转型难题时说道。 很多时候,当一个新时代的轮廓开始清晰时,那些真正可能影响企业的关键决定,可能早在几年前就已经做完了。 贝索斯选择用云计算、物流等基础设施完成了亚马逊从互联网零售时代到数字基建时代的转身。库克选择用一个超级硬件入口为起点,搭建独立的生态,让苹果完成了消费电子到移动互联时代的转型。 能跨越时代周期的巨头都是幸运的。毕竟,总有些巨头高调转型但迷失了方向,有些老大哥们固守阵地最后被
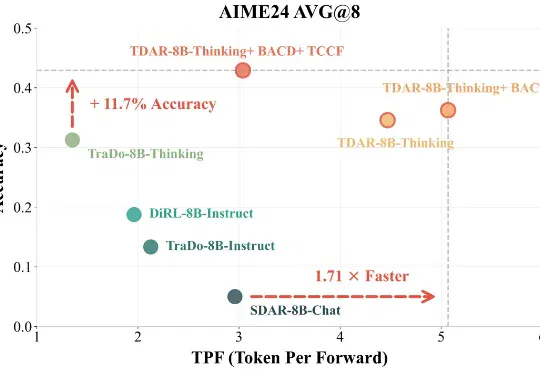
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
Tabbit 背后的团队,是美团的光年之外 对,就是那个最早由王慧文老师创办,后来并入美团的那个光年之外