别只盯着DeepSeek:上海推出“能调三维地图的AI”,政务大模型有了新答案(在新窗口打开)
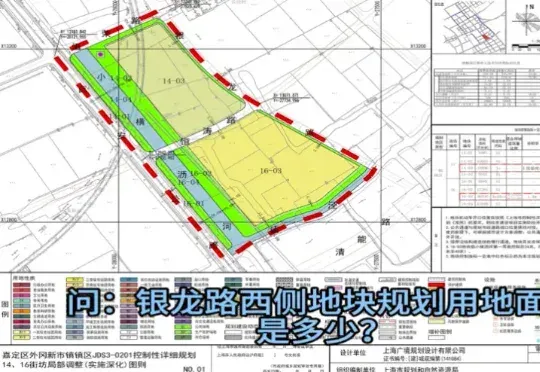
近日,由上海市规划资源局与商汤大装置联合打造的全国规划资源领域首个基础大模型“云宇星空大模型”(专业版)上线。这并非一个简单的对话机器人,而是一个6000亿参数、深度嵌入规资全业务系统的行业大模型:它能调取地图、做统计,能理解规划图纸、会写报告,覆盖从知识检索、空间分析到决策支撑的完整工作闭环。
共 1517 篇
近日,由上海市规划资源局与商汤大装置联合打造的全国规划资源领域首个基础大模型“云宇星空大模型”(专业版)上线。这并非一个简单的对话机器人,而是一个6000亿参数、深度嵌入规资全业务系统的行业大模型:它能调取地图、做统计,能理解规划图纸、会写报告,覆盖从知识检索、空间分析到决策支撑的完整工作闭环。
为什么大模型,在执行长时任务时容易翻车?这让一些专家,开始质疑大模型的推理能力,认为它们是否只是提供了「思考的幻觉」。近日,剑桥大学等机构的一项研究证明:问题不是出现在推理上,而是出在大模型的执行能力上。
近日,全球权威咨询机构IDC发布《IDC MarketScape: 中国工业大模型及智能体解决方案 2025年厂商评估》。报告选取了中国市场18家工业大模型及智能体解决方案的典型服务商进行重点研究,从现有能力和未来战略两个层面对厂商进行评估,为工业企业选择大模型、智能体服务提供了参考。
全新一代 video-SALMONN 2/2+、首个开源推理增强型音视频理解大模型 video-SALMONN-o1(ICML 2025)、首个高帧率视频理解大模型 F-16(ICML 2025),以及无文本泄漏基准测试 AVUT(EMNLP 2025) 正式发布。新阵容在视频理解能力与评测体系全线突破,全面巩固 SALMONN 家族在开源音视频理解大模型赛道的领先地位。
豆包深度思考大模型,跨界上车了。 这说不上出人意料,毕竟AI正在从内到外全链路重塑汽车,尤其是AI智舱给用户带来了全新体验,深度思考带来了强大的智能和便捷,这背后离不开大模型的赋能。 豆包的深度思考和推理能力,正是当下许多主机厂所急需的智能底座。 然而让许多人意外的是,首发豆包大模型的是上汽荣威,车企巨头与互联网大厂携手,将AI智舱推向新阶段。 没有深度思考,谈何AI智舱? AI正在全面重塑汽车,让车辆不只限于出行工具,还可以是移动的出行空间,在这个空间里,用户希望AI能提供智能便捷的服务,而且最好“千人千面”。 为了迎合用户的需求,AI智舱的概念开始出现,各种各样的座舱功能涌现,一时间鱼龙混
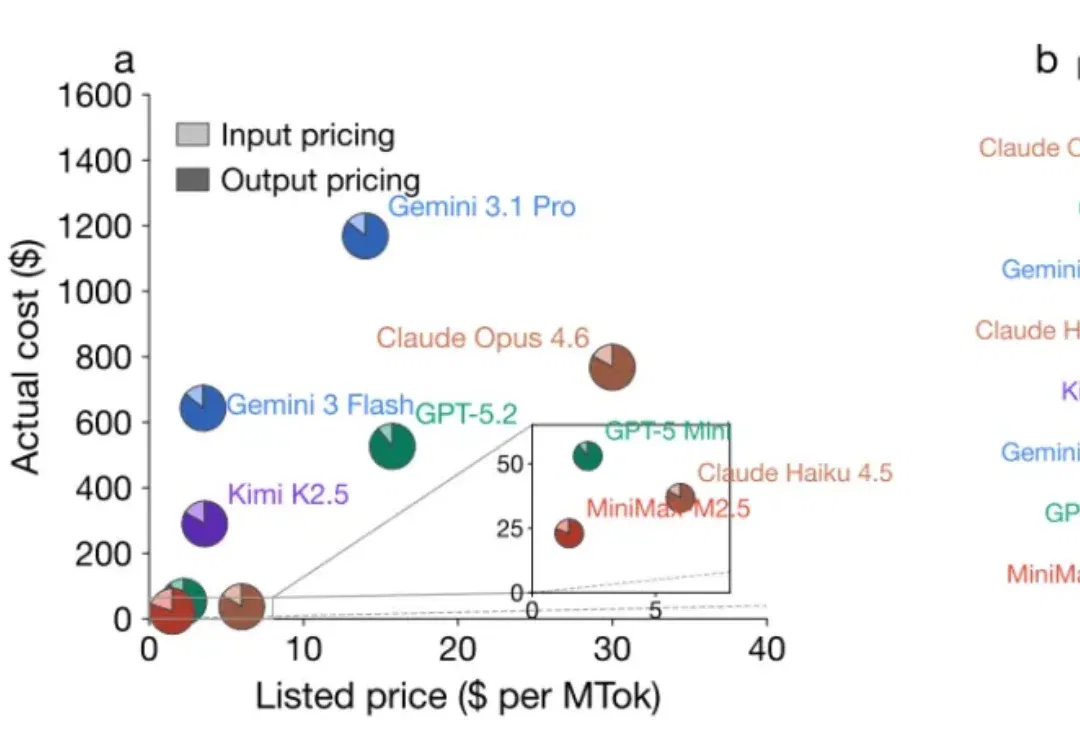
在选择使用大模型 (LLM) 时,除了模型性能强弱,价格也是一个重要指标。人们通常会用大模型的 API 定价更贵或更便宜,来比较模型的价格高低。但事实上,定价低的模型真的比定价高的模型使用起来更便宜吗?
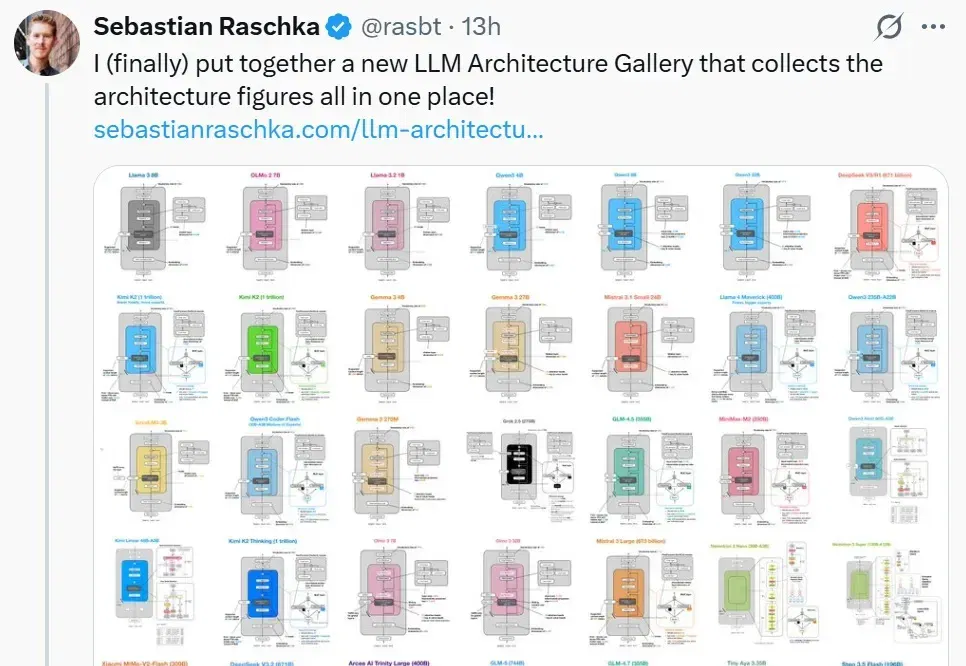
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
「抓紧转型世界模型」 「同志们朋友们,版本回调了! 搞AI应用的家人们没活了。胜利女神的天平又一次倾向了大模型公司一边。有鉴于此,我们将复刻致敬葬AI一年前的系列——把模型公司挨个写一遍。 之前已经写过了Kimi、智谱、豆包、千问和百度,发现一个问题是二线模型写少了,于是紧急加入美团、小米、腾讯等一众转型中的公司,更多模型公司敬请期待😘」 理论上不该写美团的,因为如果美团是大模型公司,那显然股价不会被一直按在地上摩擦。 不过既然美团LongCat 2.0发布,且大炒特炒了一番,甚至都有人说美团LongCat 2.0是「国芯国模的张雪时刻」。典型的拼词组拼麻了,那我就去认真复盘下美团都搞了哪些
今天,“港股AGI第一股”云知声发布其最新通用大语言模型U2,该模型是由云知声自研的、基于快慢思考融合的MoE(混合专家)范式构建的通用大语言模型。U2跳出了传统大模型盲目堆参数、堆Token的内卷路径,实现了“小参数强能力、少Token高产出、低算力低成本”的进化。
7×24,AI也吃不消。 卡内基梅隆大学和马里兰大学发了篇论文,《Language Models Need Sleep》—— 大模型处理长上下文的时候,硬撑着不休息,真的会累傻。 这项研究的灵感源自人脑运作机制。 人睡觉的时候海马体会把白天的短期记忆一遍遍回放,巩固进皮层突触,变成长期知识。 研究团队认为模型也可以这样,设计了一个睡眠机制,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。 测试发现,合理增加“睡眠”迭代轮次,能明显提升模型在深度推理类任务上的表现。 尤其是那些需要一步接一步推导的难题,越复杂,模型越需要多睡一会儿。