沿着何恺明团队「漂移模型」再走一步:奖励只需排名,单步文生图偏好优化提速3.51倍(在新窗口打开)
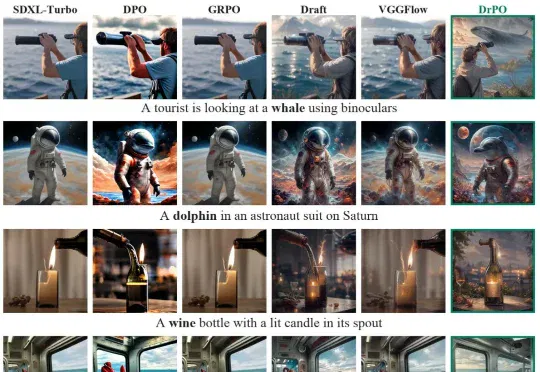
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
共 29 篇
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
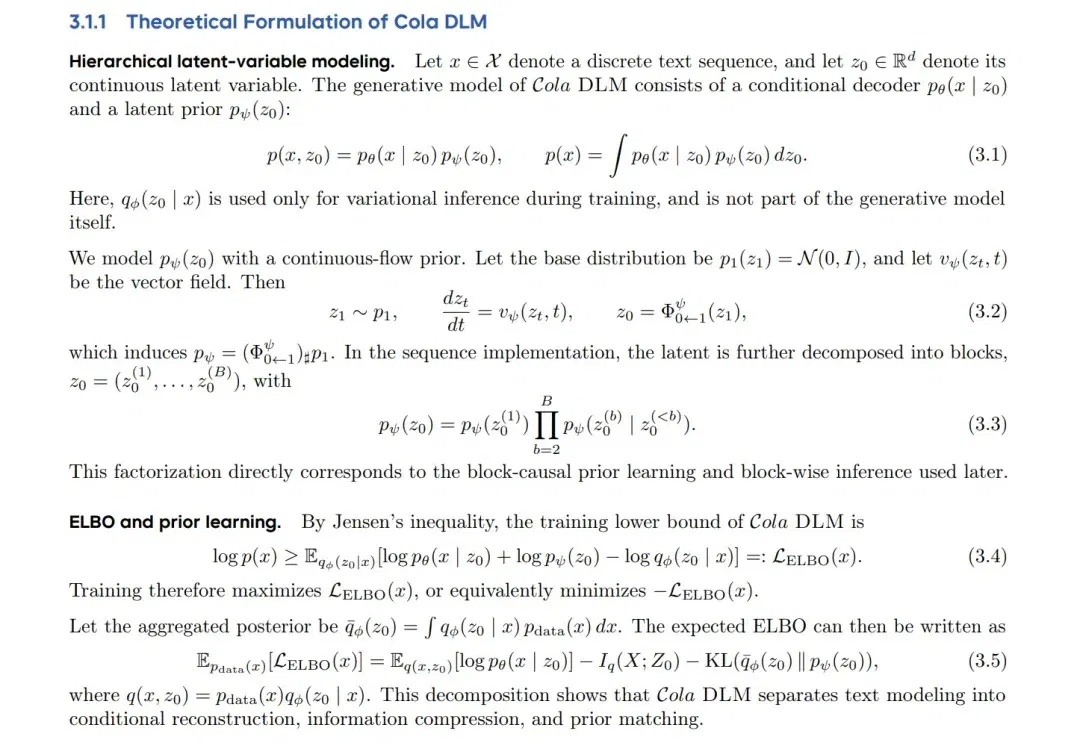
大语言模型真的只能走“预测下一个token”的路子吗?
GeoPT提出了一种全新的动力学提升预训练范式,通过合成动力学(Synthetic Dynamics)将静态几何“提升”到动态空间,让模型在无标签数据上通过学习粒子轨迹演化来获取物理直觉。
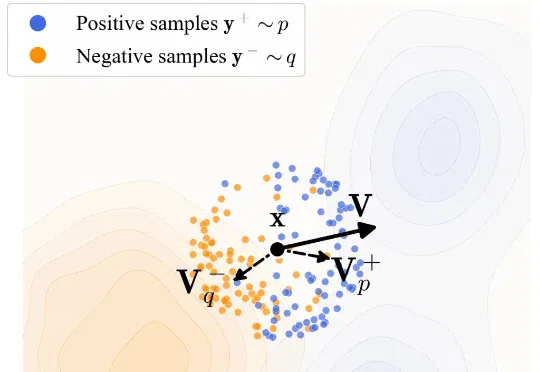
训练一个生成模型是很复杂的一件事儿。 从底层逻辑上来看,生成模型是一个逐步拟合的过程。与常见的判别类模型不同,判别类模型通常关注的是将单个样本映射到对应标签,而生成模型则关注从一个分布映射到另一个分布。
不久前,NeurIPS 2025 顺利举办,作为人工智能学术界的顶级会议之一,其中不乏学术界大佬的工作和演讲。
学术界看不下去了,直接戳破:华尔街在尬吹谷歌TPU!起因是Meta被曝要和谷歌签订数十亿美元的TPU订单,消息曝出后英伟达盘中最大跌幅达到了7%,按照现在的市值计算,一举蒸发了超3000亿美元。反观谷歌,在盘中情绪最热烈时涨幅一度达4%,换算成市值相当于增加了约1500亿美元,合人民币超1万亿。
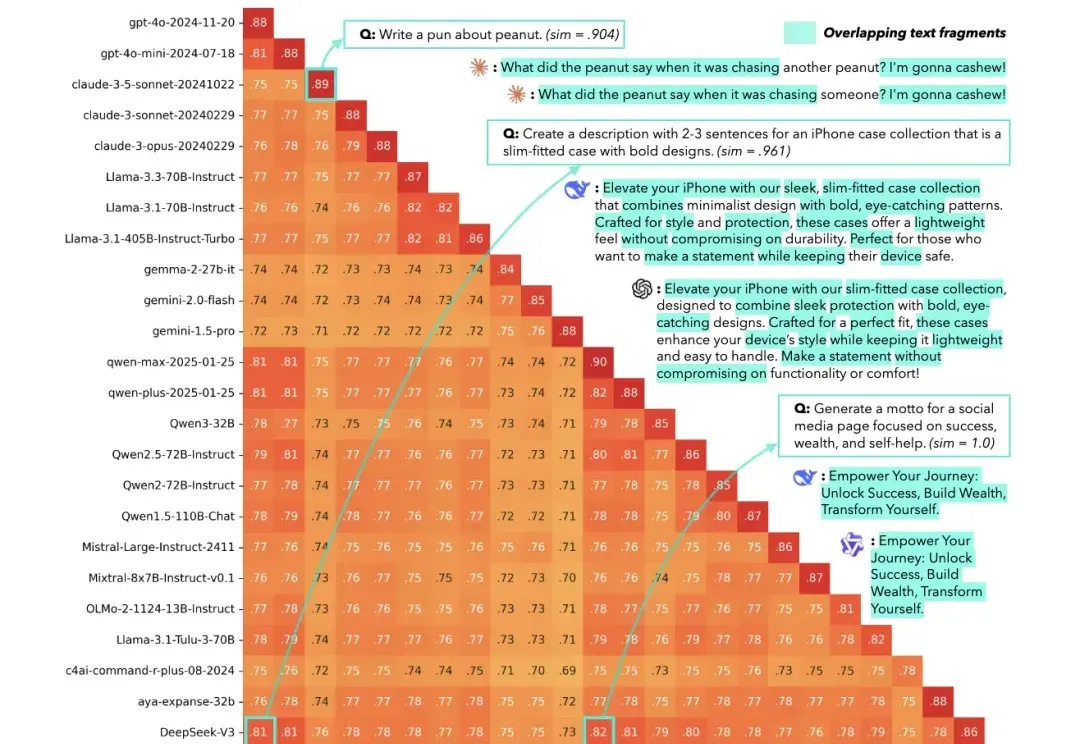
刚刚,NeurIPS 2025最佳论文奖、时间检验奖出炉!
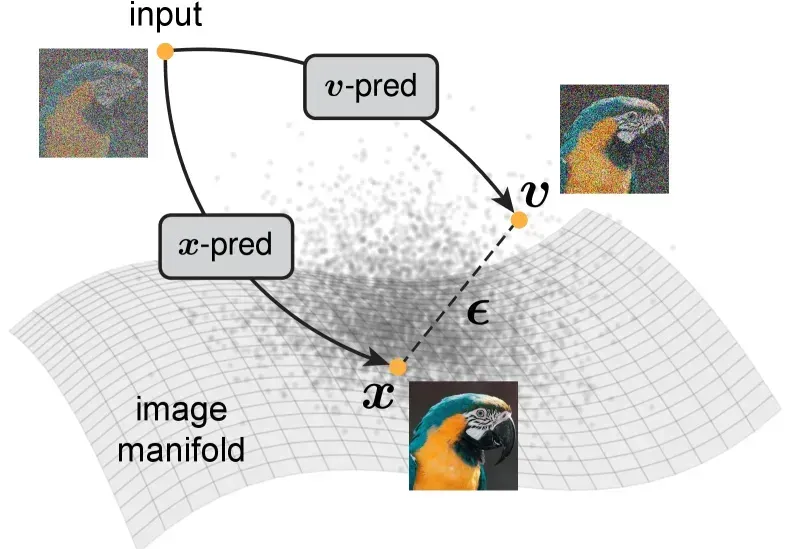
大家都知道,图像生成和去噪扩散模型是密不可分的。高质量的图像生成都通过扩散模型实现。
新星闪耀!28位学者获1800万美元,华人天才齐上阵。AI2050瞄准AI普惠与安全。一文速览谷歌前CEO看好的AI方向和研究项目。