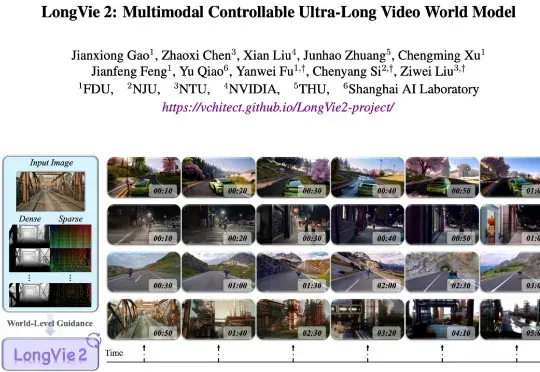
「视频世界模型」新突破:AI连续生成5分钟,画面也不崩(在新窗口打开)
围绕这一挑战,上海人工智能实验室联合复旦大学、南京大学、南洋理工大学 S-Lab 等单位提出了 LongVie 2—— 一个能够生成长达 5 分钟高保真、可控视频的世界模型框架。
共 28 篇
围绕这一挑战,上海人工智能实验室联合复旦大学、南京大学、南洋理工大学 S-Lab 等单位提出了 LongVie 2—— 一个能够生成长达 5 分钟高保真、可控视频的世界模型框架。
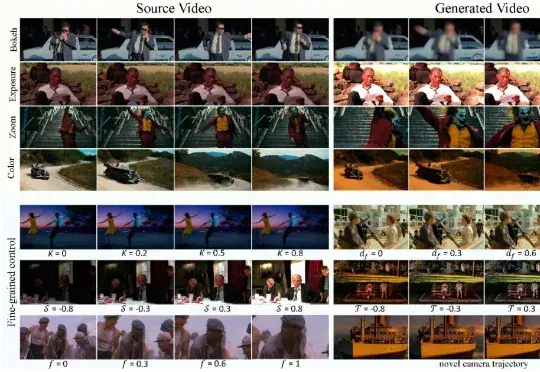
现有视频生成模型往往难以兼顾「运镜」与「摄影美学」的精确控制。为此,华中科技大学、南洋理工大学、商汤科技和上海人工智能实验室团队推出了 CineCtrl。作为首个统一的视频摄影控制 V2V 框架,CineCtrl 通过解耦交叉注意力机制,摆脱了多控制信号共同控制的效果耦合问题,实现了对视频相机外参轨迹与摄影效果的独立、精细、协调控制。
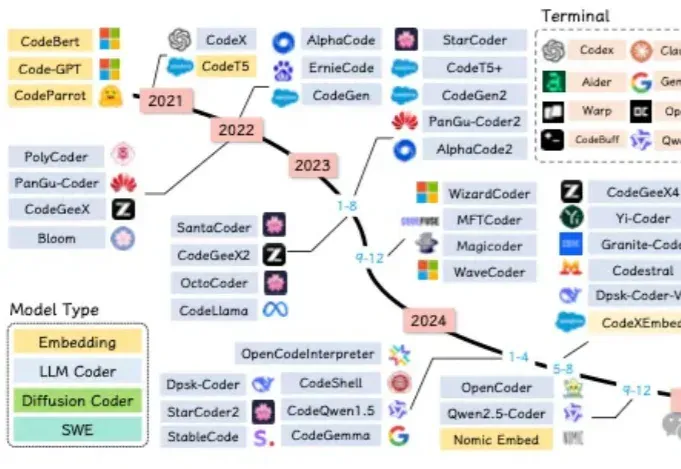
这篇论文由北京航空航天大学、阿里巴巴、字节跳动、上海人工智能实验室等几十家顶尖机构联合撰写,全文长达303页,是对当前“代码大模型(Code LLMs)”领域最详尽的百科全书式指南。
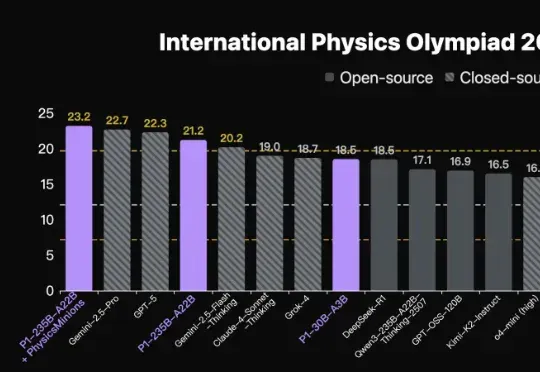
首个拿下国际物理奥林匹克竞赛IPhO 2025理论考试金牌的开源模型,出自国产。上海人工智能实验室团队推出新模型家族,代号P1。在IPhO 2025理论考试中,P1-235B-A22B取得21.2/30分,成为首个达到该金牌线的开源模型,仅次于Gemini-2.5-Pro与GPT-5。
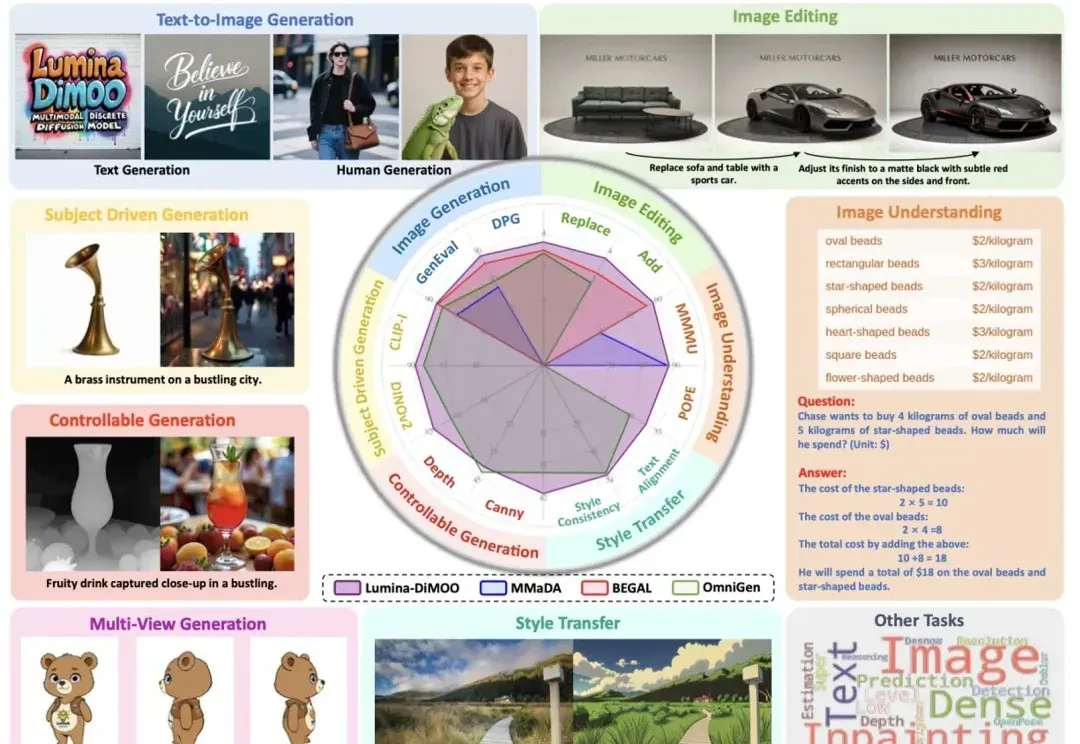
上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。
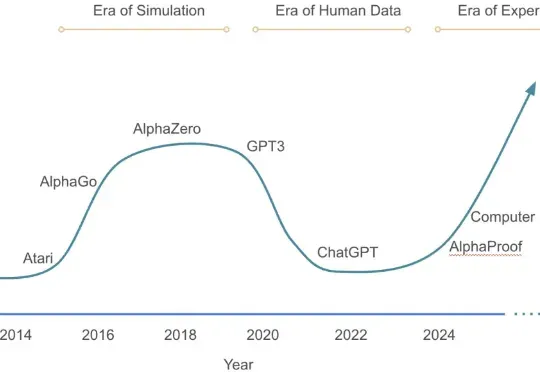
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
来自牛津大学、新加坡国立大学、伊利诺伊大学厄巴纳-香槟分校,伦敦大学学院、帝国理工学院、上海人工智能实验室等等全球 16 家顶尖研究机构的学者,共同撰写并发布了长达百页的综述:《The Landscape of Agentic Reinforcement Learning for LLMs: A Survey》。
AI生成第三视角视频已经驾轻就熟,但第一视角生成却仍然“不熟”。为此,新加坡国立大学、南洋理工大学、香港科技大学与上海人工智能实验室联合发布EgoTwin ,首次实现了第一视角视频与人体动作的联合生成。