李飞飞的World Labs联手光轮智能,具身智能进入评测驱动时代!(在新窗口打开)
最火世界模型,最火具身智能基建,联手了!
共 362 篇
最火世界模型,最火具身智能基建,联手了!
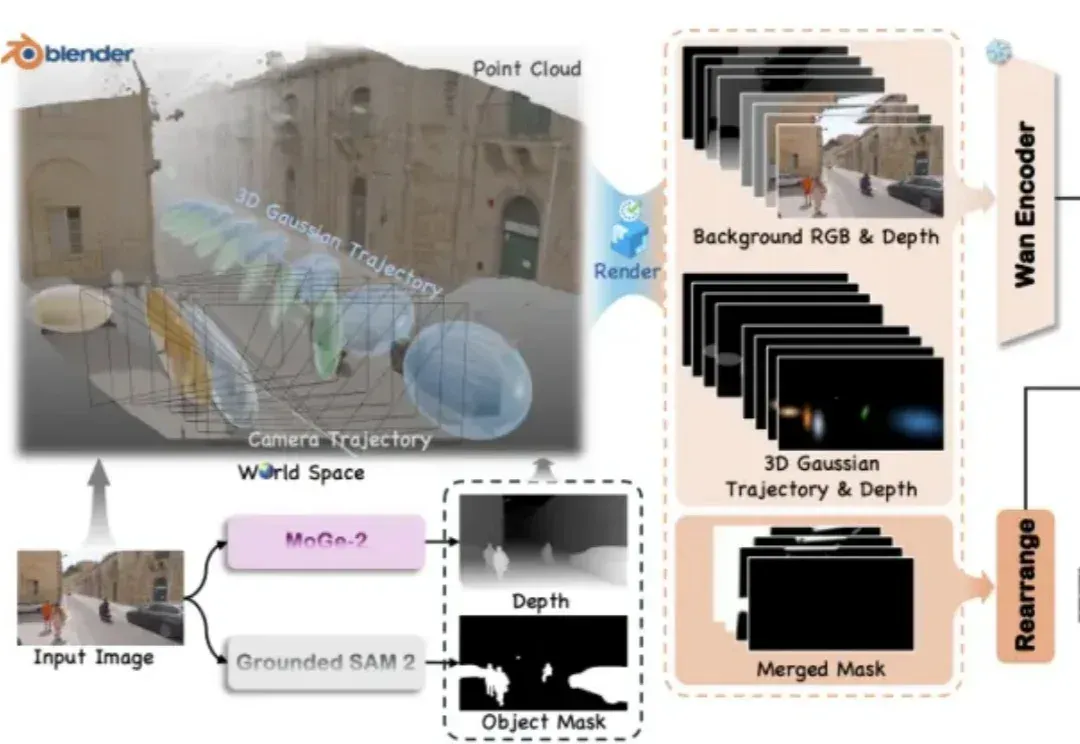
视频世界模型领域又迎来了新的突破! 复旦大学与腾讯 PCG ARC Lab 等机构的研究者们提出了 VerseCrafter,这是一个通过显式 4D 几何控制(4D Geometric Control)实现的动态逼真视频世界模型。它不仅能像「导演」一样精准控制运镜,还能同时指挥场景中多个物体的 3D 运动轨迹,为视频生成引入了物理世界维度。 自 Sora 问世以来,视频世界模型(Video World Models)成为了 AI 领域最热门的研究方向之一。我们希望 AI 不仅能生成视频,更能理解和模拟真实的物理世界。然而,现有的视频模型往往面临一个核心困境:视频是在 2D 平面上播放的,但真实
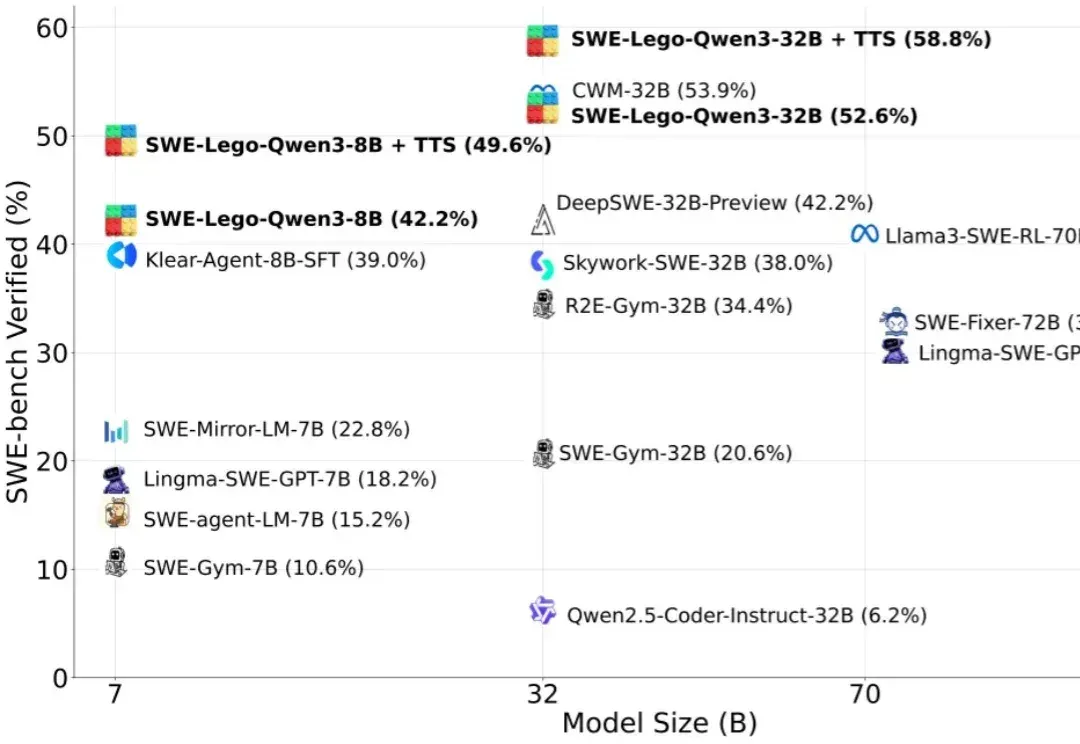
“软工任务要改多文件、多轮工具调用,模型怎么学透?高质量训练数据稀缺,又怕轨迹含噪声作弊?复杂 RL 训练成本高,中小团队望而却步?”
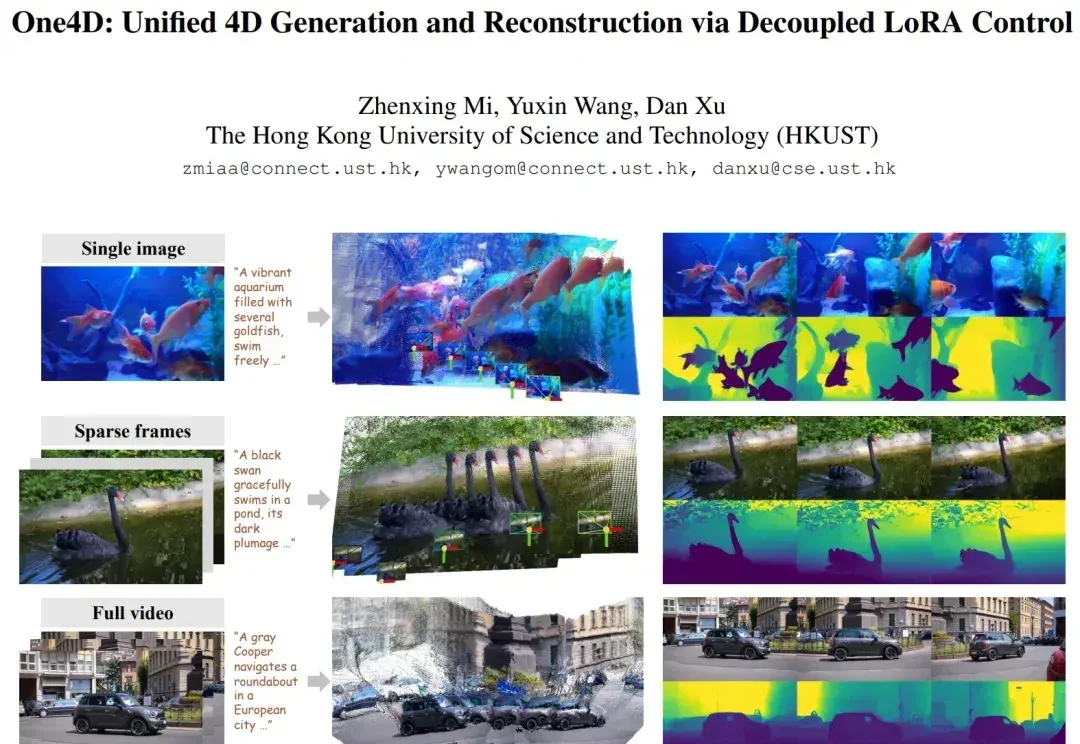
近年来,视频扩散模型在 “真实感、动态性、可控性” 上进展飞快,但它们大多仍停留在纯 RGB 空间。模型能生成好看的视频,却缺少对三维几何的显式建模。这让许多世界模型(world model)导向的应用(空间推理、具身智能、机器人、自动驾驶仿真等)难以落地,因为这些任务不仅需要像素,还需要完整地模拟 4D 世界。
当大模型竞争转向后训练,继续为闲置显卡烧钱无异于「慢性自杀」。如今,按Token计费的Serverless模式,彻底终结了算力租赁的暴利时代,让算法工程师真正拥有了定义物理世界的权利。
她是当代人工智能界最具象征意义的女性科学家之一。提到人工智能领域,李飞飞(Fei-Fei Li)无疑是最醒目的那一个。1976年出生的她,早年在美求学,1999年以物理学荣誉学士毕业于普林斯顿大学,随后在加州理工学院获得电气工程博士学位。
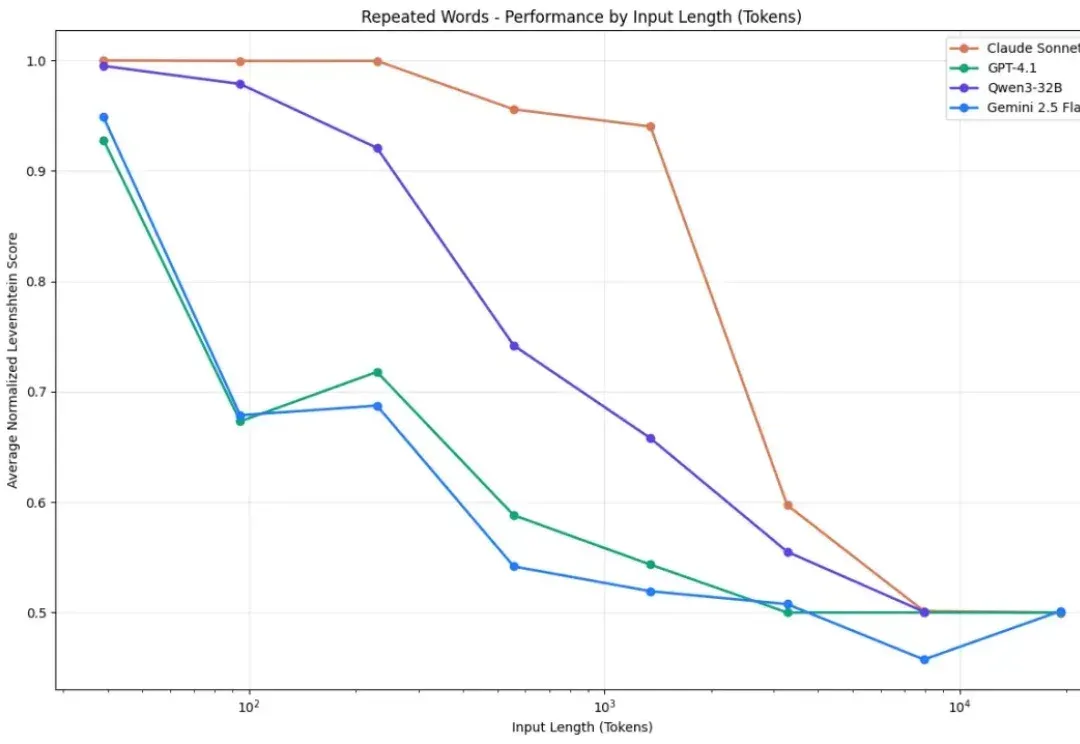
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
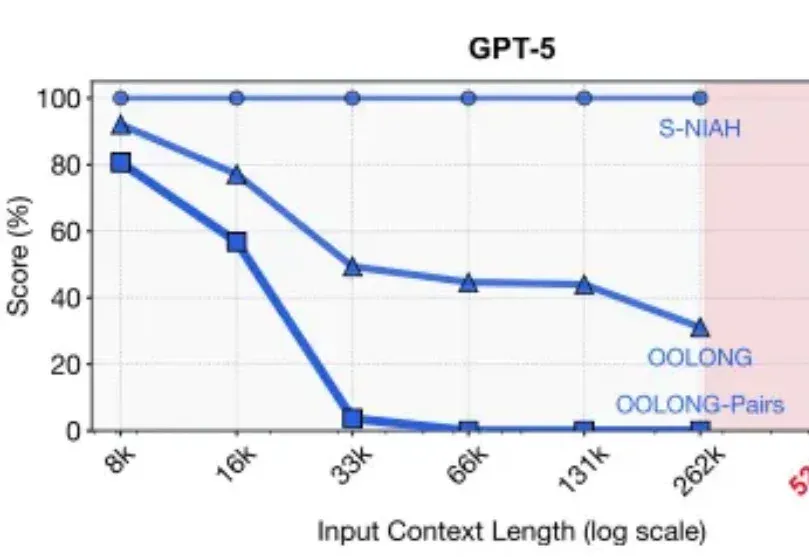
2025年的最后一天, MIT CSAIL提交了一份具有分量的工作。当整个业界都在疯狂卷模型上下文窗口(Context Window),试图将窗口拉长到100万甚至1000万token时,这篇论文却冷静地指出了一个被忽视的真相:这就好比试图通过背诵整本百科全书来回答一个复杂问题,既昂贵又低效。
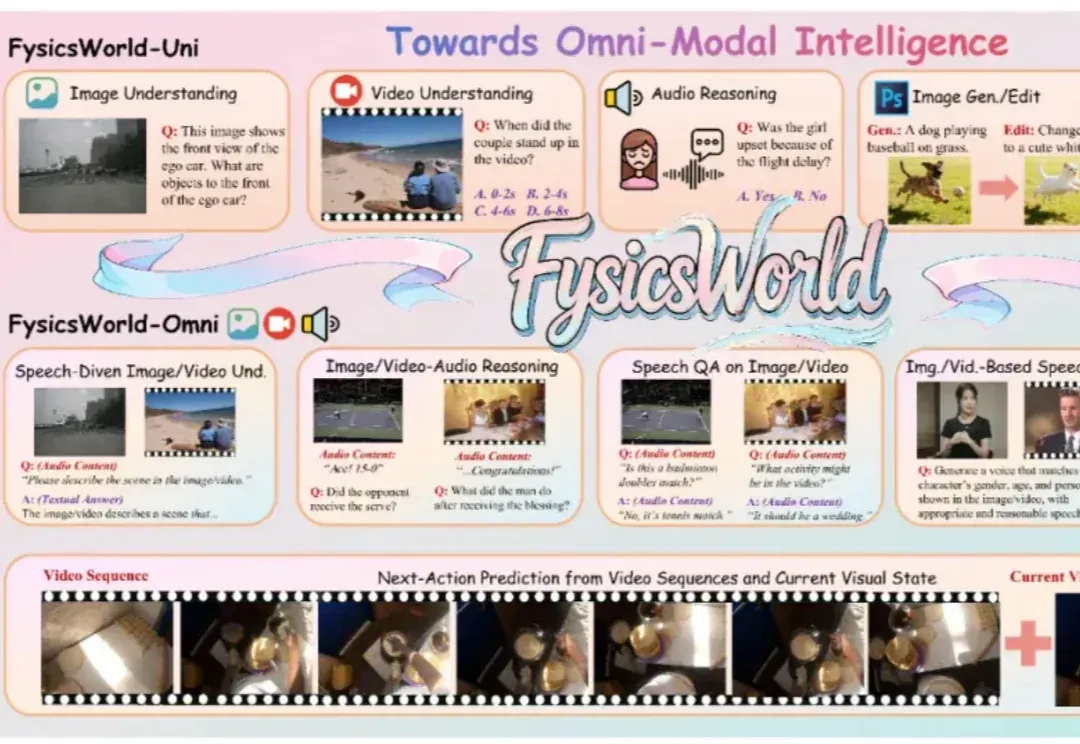
近年来,多模态大语言模型正在经历一场快速的范式转变,新兴研究聚焦于构建能够联合处理和生成跨语言、视觉、音频以及其他潜在感官模态信息的统一全模态大模型。此类模型的目标不仅是感知全模态内容,还要将视觉理解和生成整合到统一架构中,从而实现模态间的协同交互。
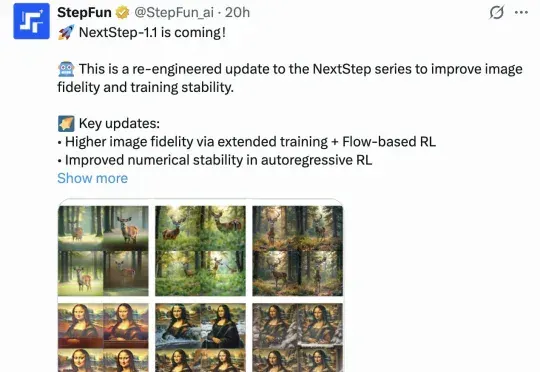
直到刚刚,用最新的图像模型NextStep-1.1,扳回一球。总体来看,这次开源的NextStep-1.1解决了之前NextStep-1中出现的可视化失败(visualization failures )问题。其通过扩展训练和基于流的强化学习(RL)后训练范式,大幅提升了图像质量。