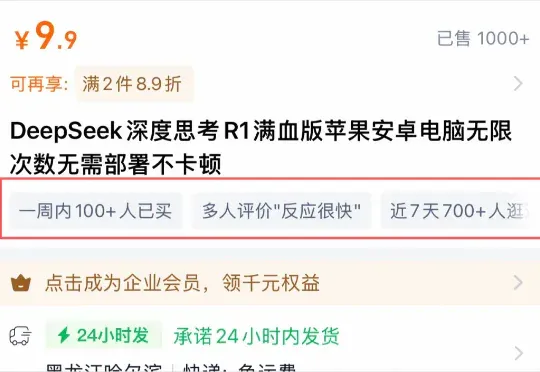
淘宝上卖9块9的DeepSeek,让我看到了被折叠的魔幻世界。(在新窗口打开)
这个世界,终于魔幻到我看不懂的程度了。故事是这样的。我最近刷淘宝挺多,然后昨天,鬼使神差的,在淘宝上,搜了一下DeepSeek。没有特定的理由,就是心血来潮,就是单纯的,想看看现在的生态。
共 530 篇
这个世界,终于魔幻到我看不懂的程度了。故事是这样的。我最近刷淘宝挺多,然后昨天,鬼使神差的,在淘宝上,搜了一下DeepSeek。没有特定的理由,就是心血来潮,就是单纯的,想看看现在的生态。
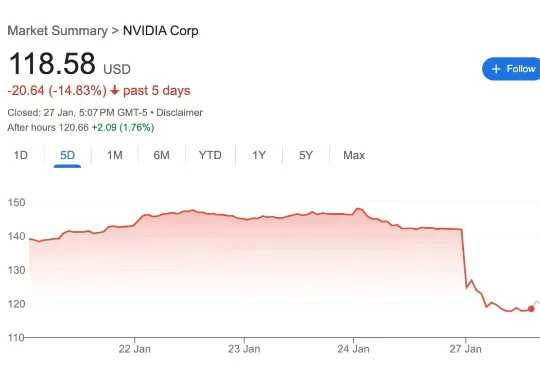
随着DeepSeek R1、Kimi K2和DeepSeek V3.1混合专家(MoE)模型的相继发布,它们已成为智能前沿领域大语言模型(LLM)的领先架构。由于其庞大的规模(1万亿参数及以上)和稀疏计算模式(每个token仅激活部分参数而非整个模型),MoE式LLM对推理工作负载提出了重大挑战,显著改变了底层的推理经济学。
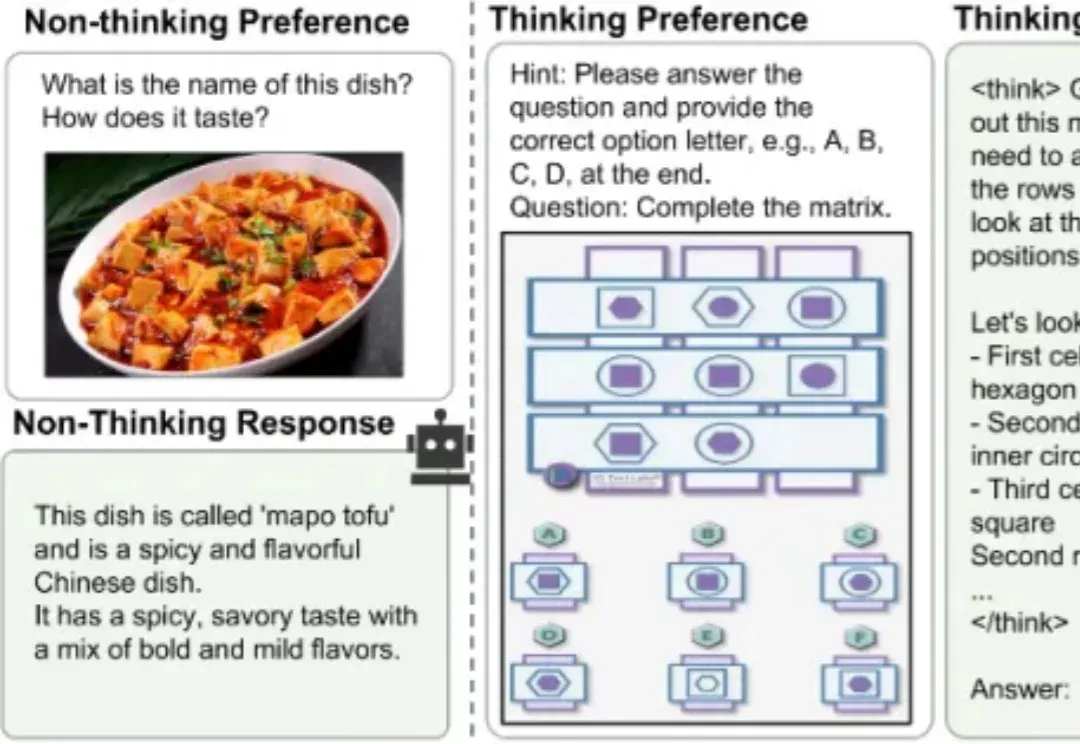
当前,业界顶尖的大模型正竞相挑战“过度思考”的难题,即无论问题简单与否,它们都采用 “always-on thinking” 的详细推理模式。无论是像 DeepSeek-V3.1 这种依赖混合推理架构提供需用户“手动”介入的快慢思考切换,还是如 GPT-5 那样通过依赖庞大而高成本的“专家路由”机制提供的自适应思考切换。
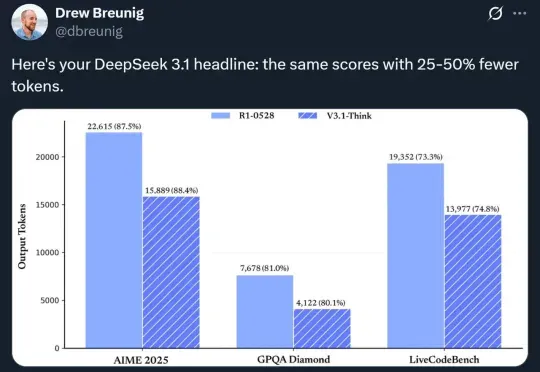
在最近的一档脱口秀节目中,演员张俊调侃 DeepSeek 是一款非常「内耗」的 AI,连个「1 加 1 等于几」都要斟酌半天。
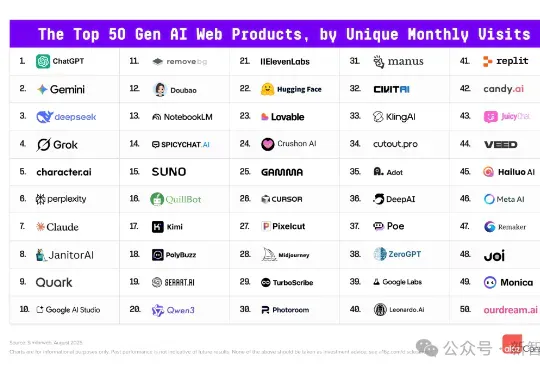
a16z最新发布「全球Top100消费级GenAI应用榜单」,AI竞争格局逐渐稳定,中国力量全面崛起,DeepSeek、豆包、夸克等多款产品跻身前十。ChatGPT依旧领跑,谷歌Gemini紧随其后,Grok高速逆袭。整体来看,全球AI正进入多极化竞争的新阶段。
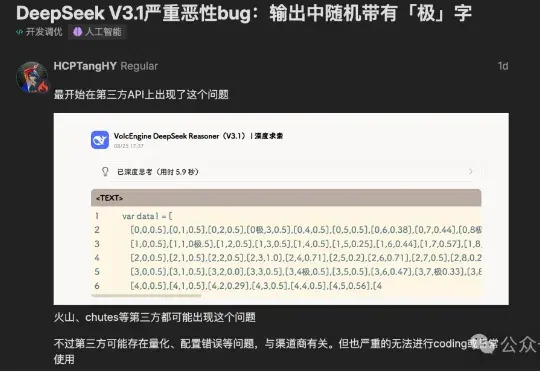
DeepSeek V3.1上演的bug大秀“极你太美”,可谓是让全网热议了一波。 简单来说呢,就是陆续有开发者们发现,当他们在调用API进行代码开发的过程中,输出结果里会时不时蹦出来“极”字。
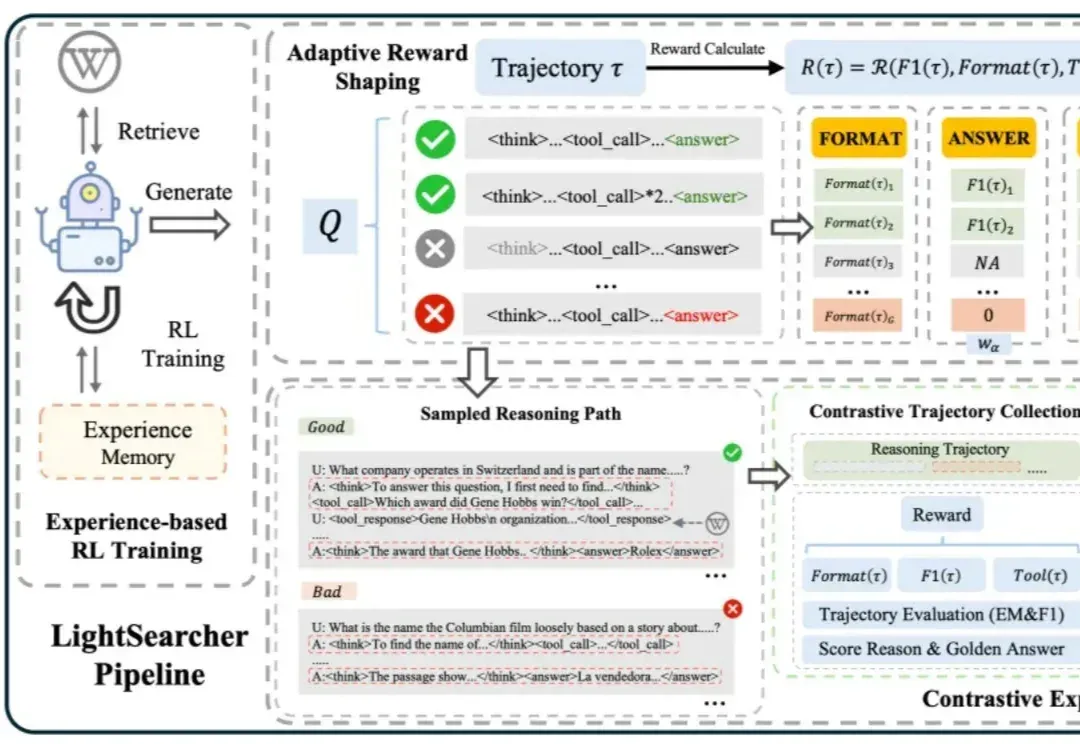
如今,以 DeepSeek-R1 为代表的深度思考大模型能够处理复杂的推理任务,而DeepSearch 作为深度思考大模型的核心搜索器,在推理过程中通过迭代调用外部搜索工具,访问参数边界之外的最新、领域特定知识,从而提升推理的深度和事实可靠性。
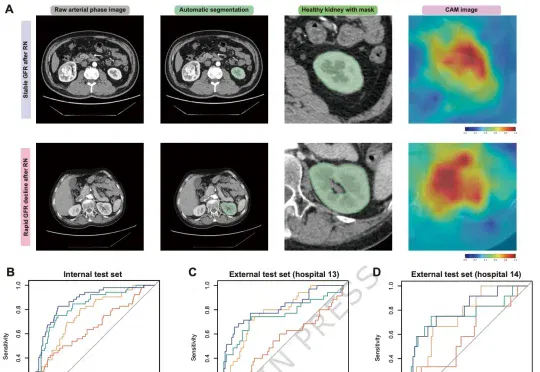
2026年5月28日,Nature通讯发表了题为 《Multimodal deep learning model for AI-based functional prognostic risk stratification in patients undergoing radical nephrectomy》 的论文。
5个月迭代4款模型,下一步还要开源。 智东西9月3日消息,今日,Meta发布新一代最强旗舰模型Muse Spark 1.3。在Artificial Analysis的AI分析指数榜上,新模型分数仅次于Claude Fable 5.1、Claude Opus 5。 Meta联合创始人、CEO马克·扎克伯格(Mark Zuckerberg)在社交平台X上称,Muse Spark 1.3的性能超乎想象。 Meta超级智能实验室负责人、首席AI官汪滔(Alexander Wang)称,该模型成本低到几乎可以忽略不计,智能体、编程能力以及易用性大幅提升。并且Muse Spark 1.3搭配Muse Co
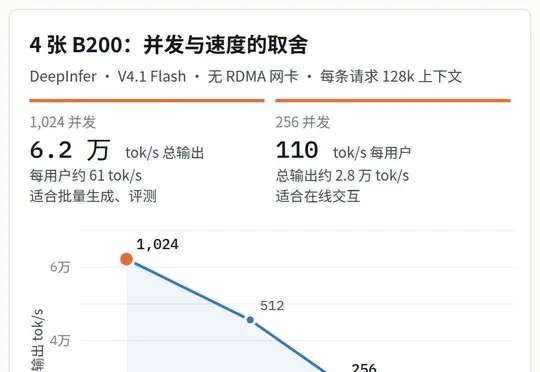
DeepSeek 开源的推理框架 DeepInfer 经 PCIe 本机取数改造后,可在无 RDMA 网卡的 4 张 B200 上以 128k 上下文承载 1024 并发,总输出约 6.2 万 token/s。