单个LLM已不够?华盛顿大学开源多模型协同框架MoCo(在新窗口打开)
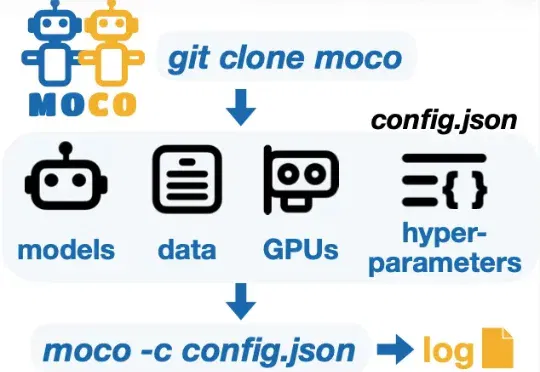
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
共 404 篇
为了支持多模型协同研究并加速这一未来愿景的实现,华盛顿大学 (University of Washington) 冯尚彬团队联合斯坦福大学、哈佛大学等研究人员提出 MoCo—— 一个针对多模型协同研究的 Python 框架。MoCo 支持 26 种在不同层级实现多模型交互的算法,研究者可以灵活自定义数据集、模型以及硬件配置,比较不同算法,优化自身算法,以此构建组合式人工智能系统。MoCo 为设计、
2026 开年至今,人工智能圈子最火的是一只小龙虾 Clawdbot 。
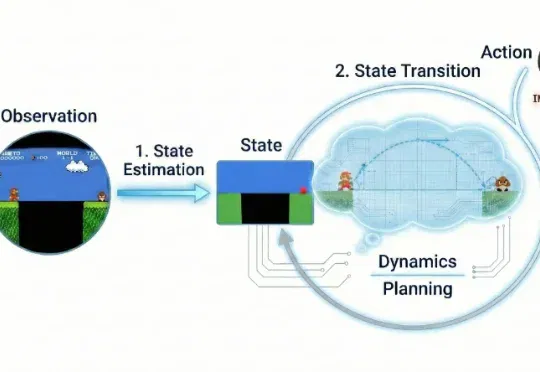
近年来,视频生成(Video Generation)与世界模型(World Models)已跃升为人工智能领域最炙手可热的焦点。从 Sora 到可灵(Kling),视频生成模型在运动连续性、物体交互与部分物理先验上逐渐表现出更强的「世界一致性」,让人们开始认真讨论:能否把视频生成从「逼真短片」推进到可用于推理、规划与控制的「通用世界模拟器」。
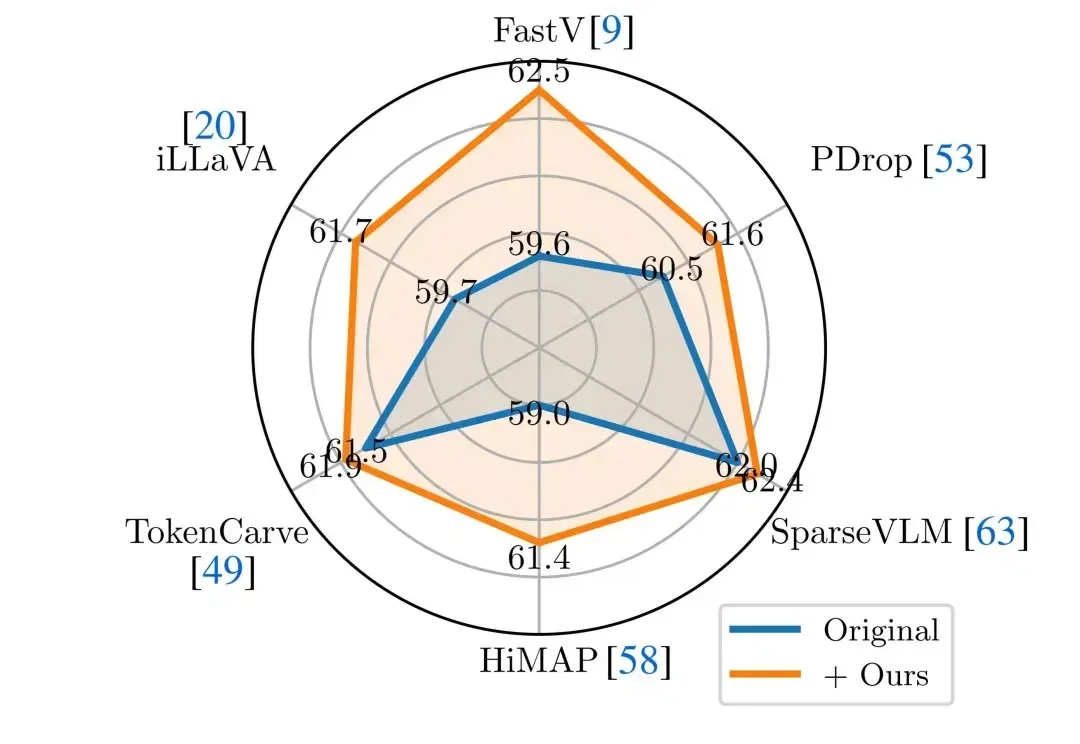
近年来,Vision-Language Models(视觉 — 语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。然而,这类模型在实际应用中往往面临推理开销大、效率受限的问题,研究者通常依赖 visual token pruning 等策略降低计算成本,其中 attention 机制被广泛视为衡量视觉信息重要性的关键依据。
找准PMF,比创意更重要 欧洲今年AI赛道最大的融资出现了。 近日,伦敦人工智能公司Synthesia宣布完成2亿美元E轮融资,估值达40亿美元。 与多数追逐通用大模型的初创公司不同,Synthesia专注企业级AI视频生成,帮助全球组织将文本知识高效转化为多语言培训与沟通视频。 从早期被近百家风投拒绝,到如今成为欧洲AI应用层的标杆,Synthesia的路径印证了一个趋势:在AI狂热中,真正赢得市场的,不是最炫的技术,而是最深的场景扎根。 完美PMF跑出的独角兽 2026年初,欧洲AI赛道迎来一个标志性时刻:总部位于伦敦的AI视频公司Synthesia宣布完成2亿美元融资,投后估值高达40亿
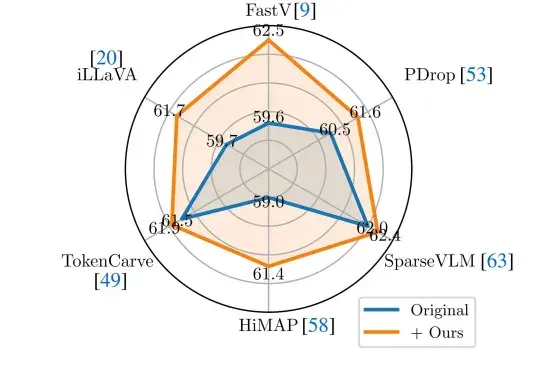
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
随着无需向云端发送敏感数据、以隐私为先的企业级人工智能需求日益增长,SpotDraft 已从高通风险投资公司获得 800 万美元战略 B 轮扩展融资,以扩展其面向受监管法律工作流程的端侧合同审评技术。
提供软件支撑OpenAI 等公司语音、视频及实体 AI 模型的初创企业 LiveKit,在一轮融资中筹集了 1 亿美元,公司估值达 10 亿美元。LiveKit 的软件和网络运行着利用语音、视频以及所谓物理 AI(应用于机器人技术等任务)的人工智能模型。
中国铁电材料研究获重大突破,为下一代人工智能器件奠定了全新物理基础!中科院物理研究所的最新成果,揭开了萤石结构氧化锆中原子级“一维带电畴壁”的神秘面纱,论文登上了最新一期Science。
近日,中国科学技术大学(USTC)联合新疆师范大学、中关村人工智能研究院、香港理工大学,在数据驱动的多功能双连通多尺度结构逆向设计领域取得重要突破。