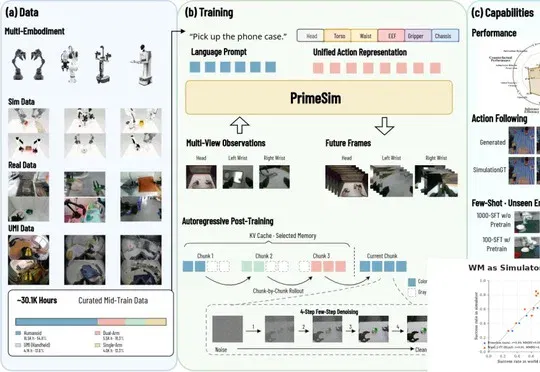
启元发布 PrimeSim,探索面向机器人操作的世界模型仿真器(在新窗口打开)
PrimeSim 将预训练视频模型经中训练与后训练改造为动作条件仿真器,关注跨视角一致性、长程状态和生成速度。团队报告了仿真基准及在模型内训练后向传统仿真迁移的结果;这仍不同于已验证真实机器人泛化,权重与代码在报道时属于即将开放。
共 388 篇
PrimeSim 将预训练视频模型经中训练与后训练改造为动作条件仿真器,关注跨视角一致性、长程状态和生成速度。团队报告了仿真基准及在模型内训练后向传统仿真迁移的结果;这仍不同于已验证真实机器人泛化,权重与代码在报道时属于即将开放。
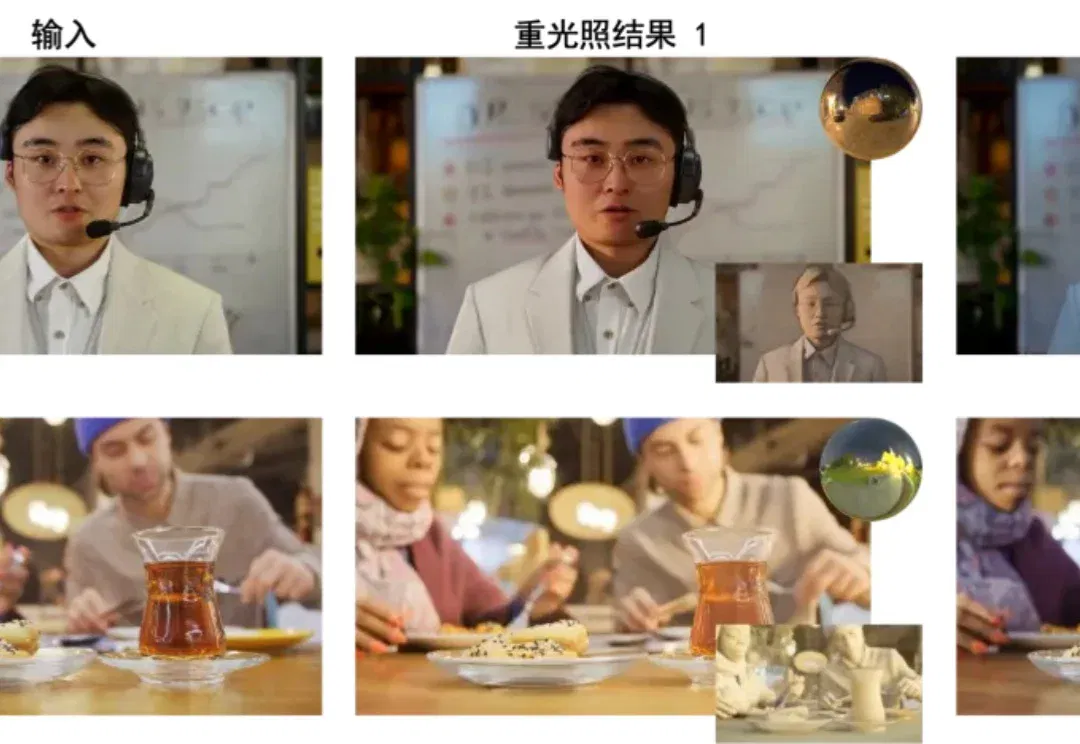
世界模型希望让机器理解环境如何变化,并预测干预后的结果,支持智能体学习、仿真与内容创作。这要求视频模型在场景变化时仍保持物理关系的一致性。光照是其中关键的一环:当光源移动,人物、物体与阴影应协同响应。可控重光照由此成为探索视频模型物理表达能力的切入点。
两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。
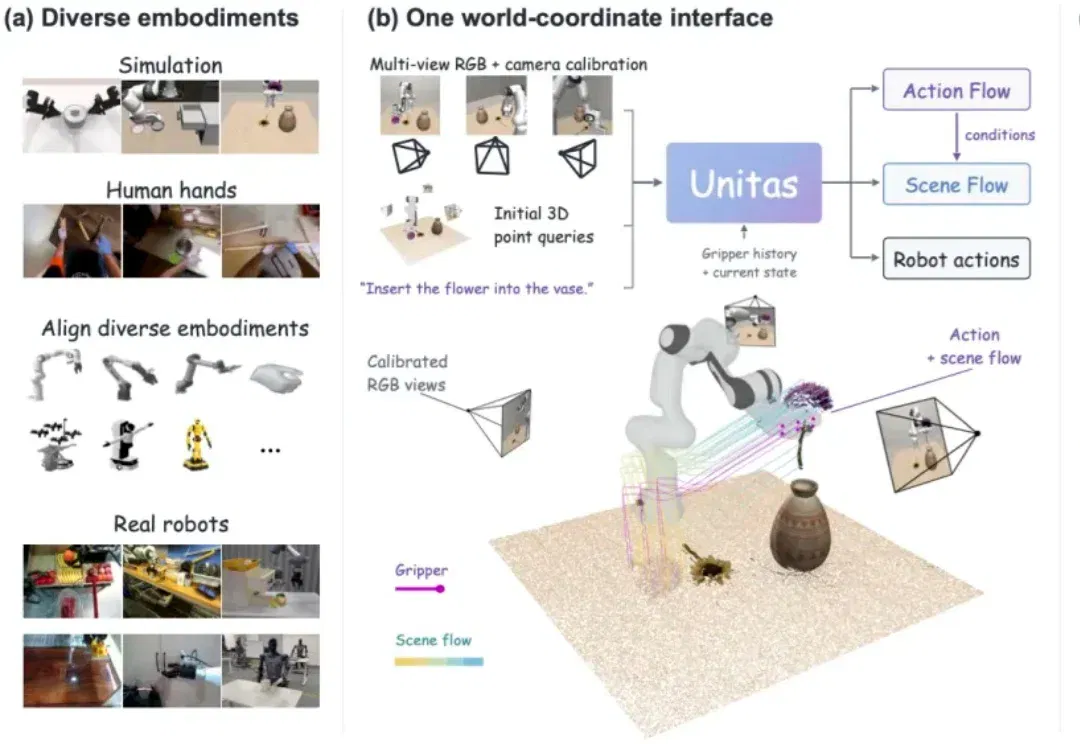
大语言模型为什么能 scale?一个重要基础是,海量来源各异的知识,被统一进了同一种输入输出空间 —— 文本。输入是文本,输出也是文本,主干模型在这个统一空间中学习、组合与迁移知识。那么,具身智能要获得类似的泛化能力,通往 Physical AGI,它的 “原生统一空间” 是什么?

「麻烦你,帮我看一下。」 一副 AI 眼镜的价值,可能就藏在少说一次这样的话里。 到了陌生的地方,视障用户最需要的不是一个什么都能聊的 AI,而是一个能告诉他周围有什么、该注意什么的帮手。该提醒时及时提醒,没必要时就安静,别在耳边说个不停。 京东在本次 JDD 上展示的 AI 眼镜,瞄准的正是这个需求:接入 JoyAI-VL-Interaction 模型,通过第一视角持续理解周围环境,为全盲及低视力人群提供辅助,减少「必须问人」的时刻。 这是一副充满爱与希望的智能眼镜。它也是观察京东 AI 路线的一个小切口。 JDD 期间,京东发布并开源JoyAI-Echo WM 实时可交互世界模型,并带来一
独家获悉,近期,腾讯混元多模态理解负责人胡瀚提出了离职。此前,他曾担任微软亚洲研究院视觉计算组首席研究员。2025年初加入腾讯后,负责视觉大模型的研究。在后续的调整中,他加入大语言模型部旗下的“Frontier”前沿技术研究组,负责多模态理解的相关研究,汇报给姚顺雨。
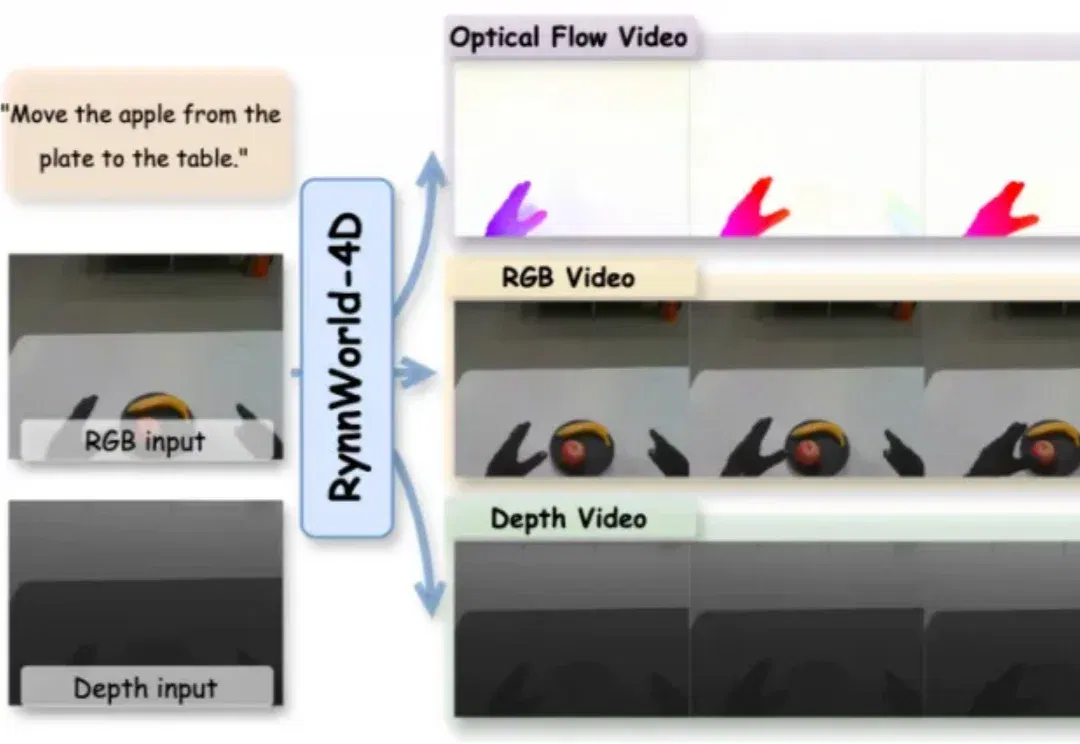
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
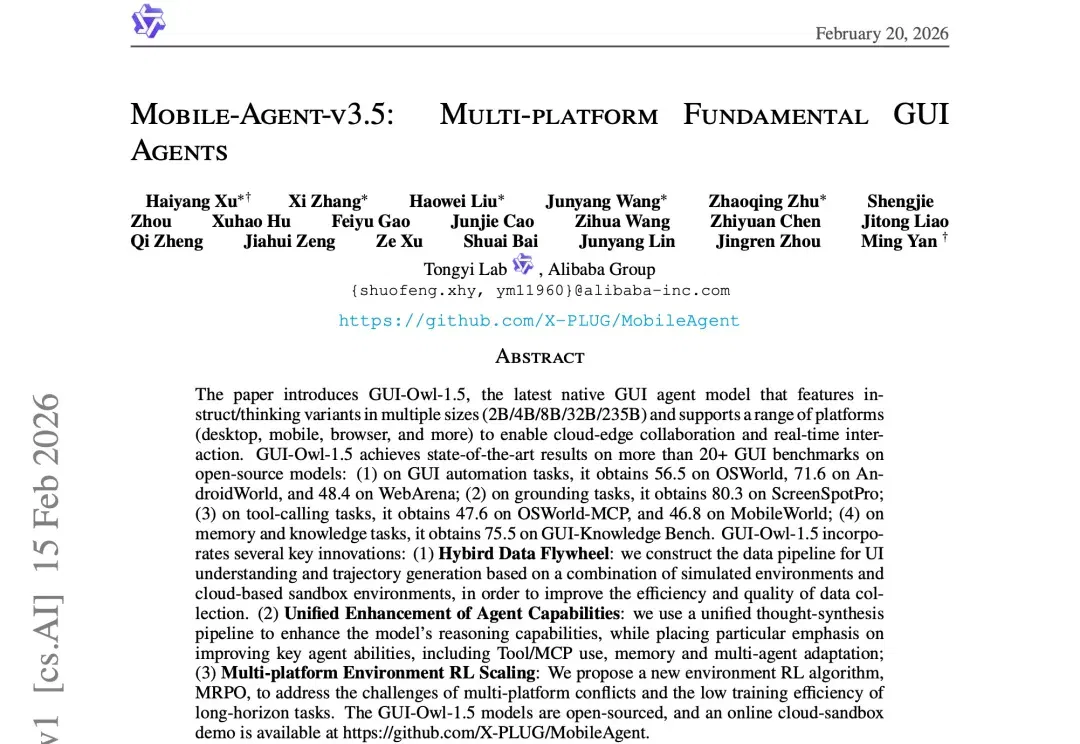
伴随多模态大模型的发展,GUI Agent正成为人机交互的新范式。
ChatGPT发布距今已近36个月,面对OpenAI的领先,哈萨比斯带领谷歌AI全面反攻,通过新发布的Gemini 3强势回归。Gemini 3在LM Arena等多个模型榜单登顶,表现优于GPT-5及其他模型,上演了一场完美逆袭。