大模型能“原地”改参数了!字节Seed&北大新论文:测试时推理无需加层重训练(在新窗口打开)
字节Seed最新研究,让大模型能“原地改参数”了。既不用改模型结构,也不用重新训练,还跑得很快。具体是这么个情况。智能体时代嘛,大家都知道模型们面对的任务开始变得越来越复杂、上下文越来越长。
共 348 篇
字节Seed最新研究,让大模型能“原地改参数”了。既不用改模型结构,也不用重新训练,还跑得很快。具体是这么个情况。智能体时代嘛,大家都知道模型们面对的任务开始变得越来越复杂、上下文越来越长。
最近,来自Meta与University of Copenhagen的研究者提出了OneStory: Coherent Multi-Shot Video Generation with Adaptive Memory(收录于CVPR 2026)。这项工作聚焦于一个核心问题:如何在生成多镜头视频时,有效保留长程跨镜头上下文,从而实现更强的叙事一致性。
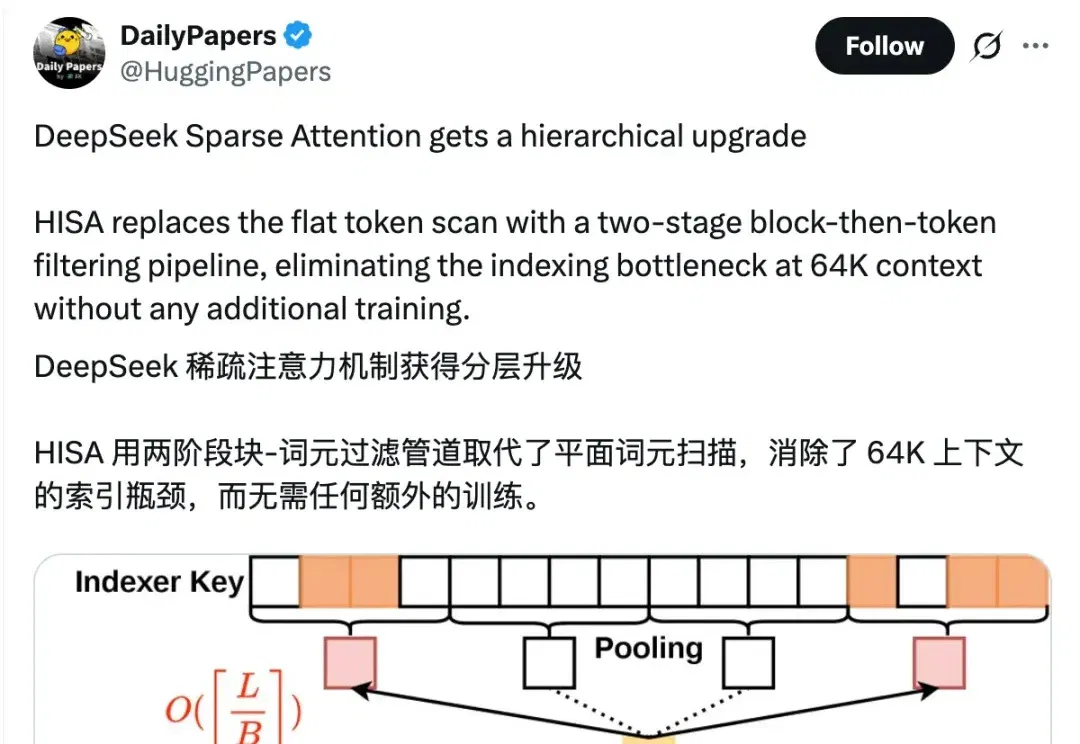
就在大家都急头白脸地等待DeepSeek-V4的时候,冷不丁一篇新论文引起了网友们的注意—— 提出新稀疏注意力机制HISA(分层索引稀疏注意力),突破64K上下文的索引瓶颈,相比DeepSeek正在用的DSA(DeepSeek Sparse Attention)提速2-4倍。
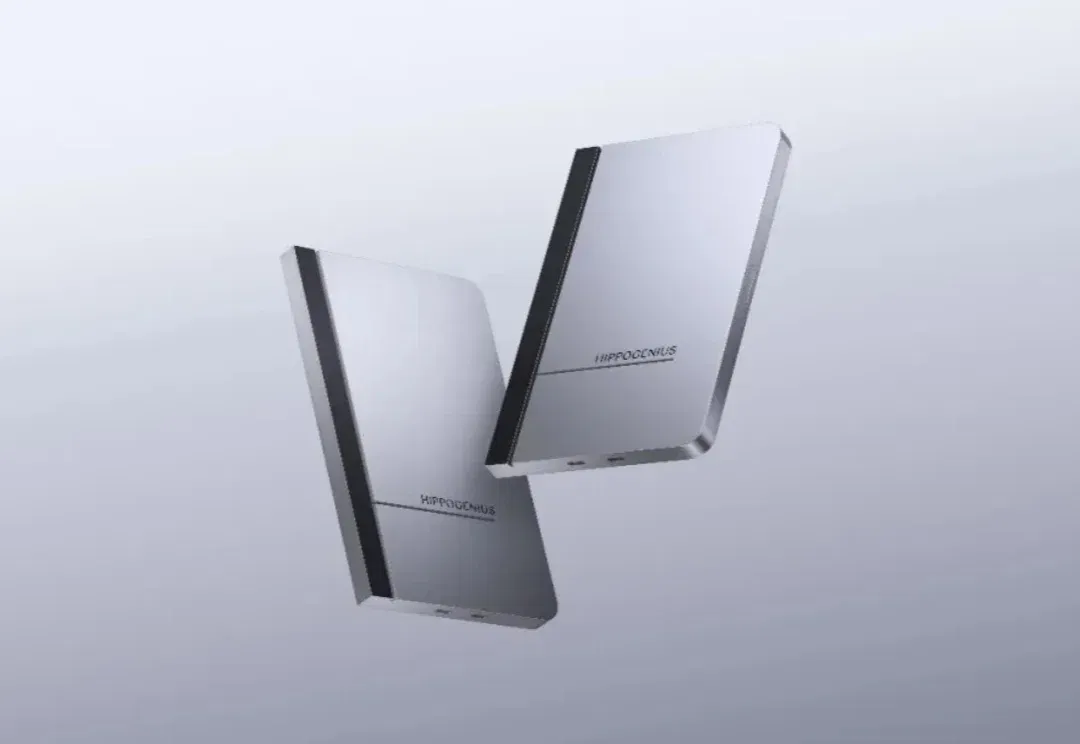
一家叫泛灵人工智能的团队,出了一款主打「超级办公助理」的硬件产品。
刚刚,Anthropic神秘王炸Mythos的基准测试泄露了,多项跑分直接刷新纪录!另外,泄露源码中还曝光出卡皮巴拉的细节:代号capabara-v2-fast,支持1M上下文。
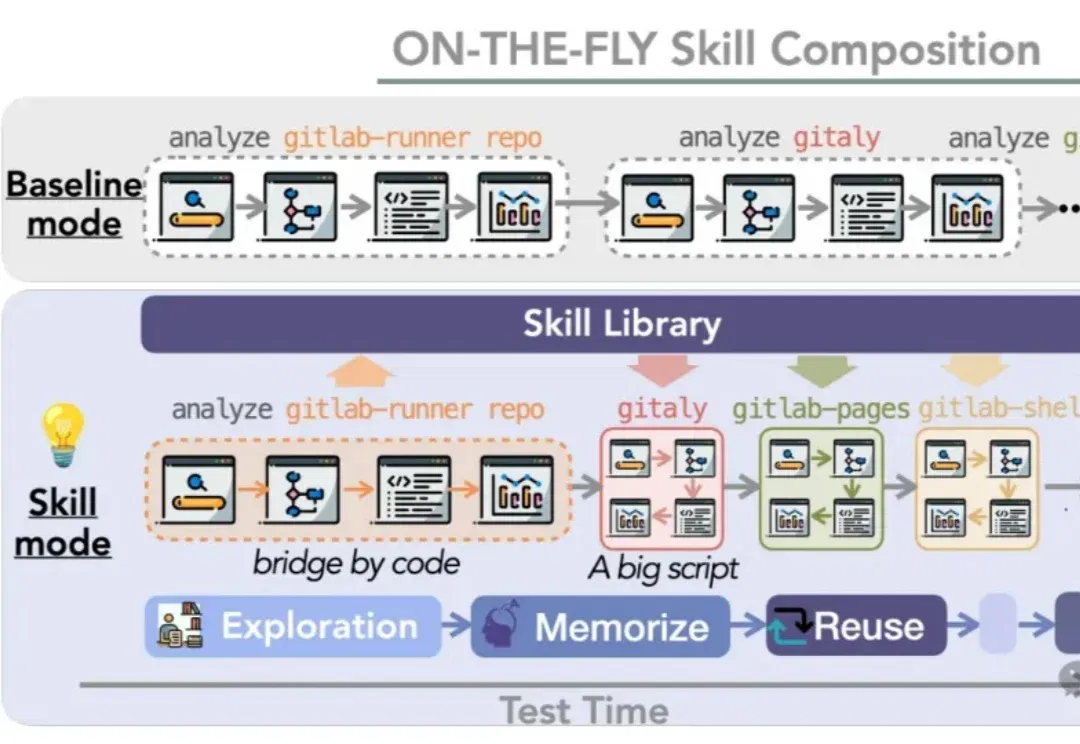
AI会用工具了,问题才真正开始… 这两年,大模型Agent在“用工具”这件事上进步很快。搜索、查信息、调API,很多模型已经能把一串操作接起来,完成相当复杂的多步任务。 但一旦把场景拉近到真实工作流,问题很快就会显现出来。很多任务表面上不同,底层流程其实高度相似:先搜,再筛,再整理,最后再做一点汇总分析。换一个对象,这套流程往往又要完整走一遍。 麻烦在于,现有Agent虽然会做这些事,却不太会把已经做成功过的流程留下来。 圆满完成任务后,再遇到同样任务它还是会重新规划、重新传参、重新走一遍工具链。结果就是:任务也许做成了,但token越跑越多,上下文越来越长,成本和不稳定性也一起上来了。 为解
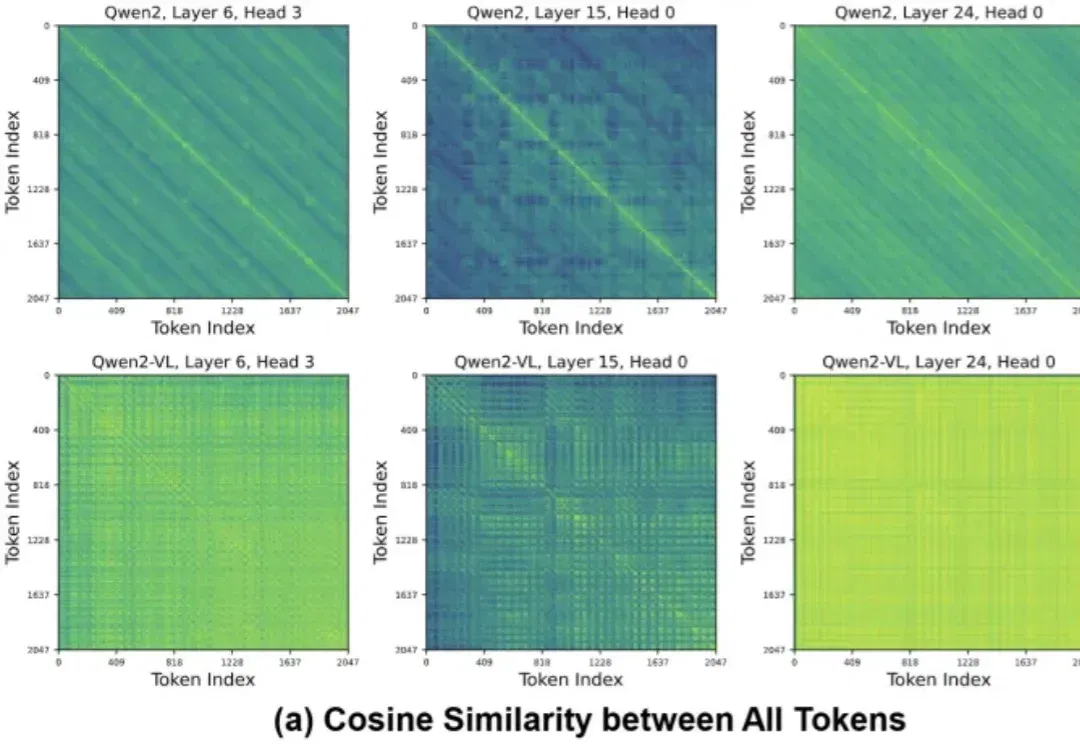
长上下文推理已经成了VLM/LLM的默认形态。
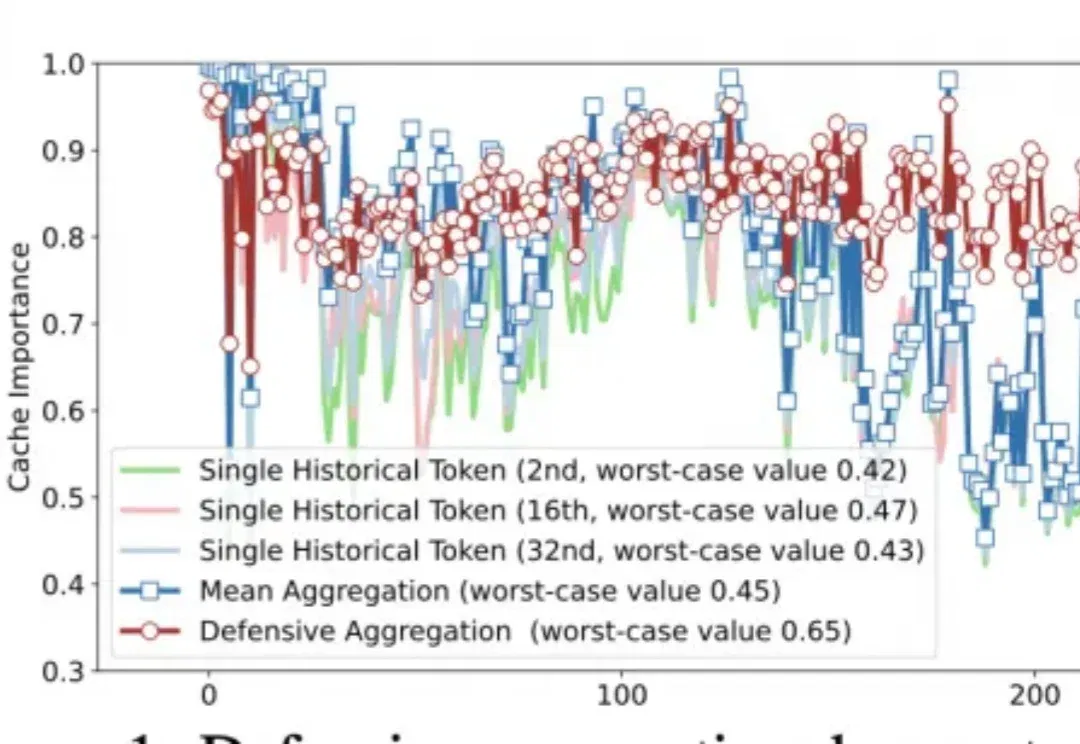
随着大模型长上下文能力快速增长,海量 KV Cache 存储需求急剧增加,各类 KV Cache 压缩方法如雨后春笋般涌现。然而,这些方案在真实场景中的工程落地却常常陷入困境。
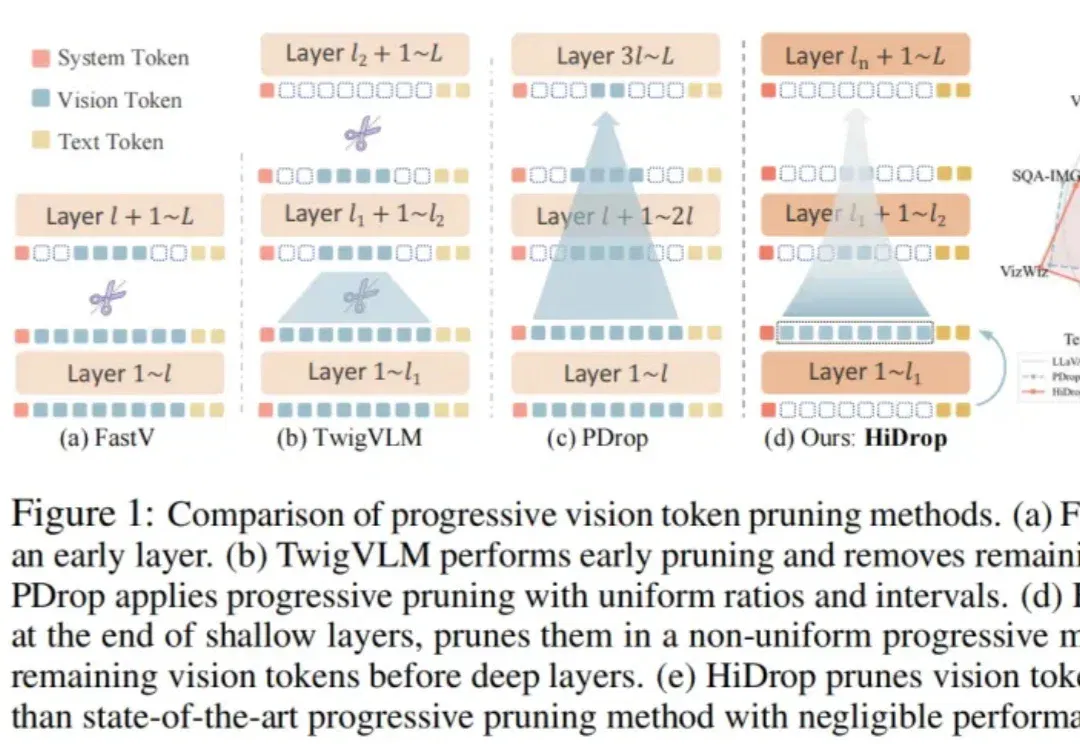
随着多模态大语言模型(MLLM)支持更长上下文,高分辨率图像和长视频会产生远多于文本的视觉 Token,在自注意力二次复杂度下迅速成为效率瓶颈。
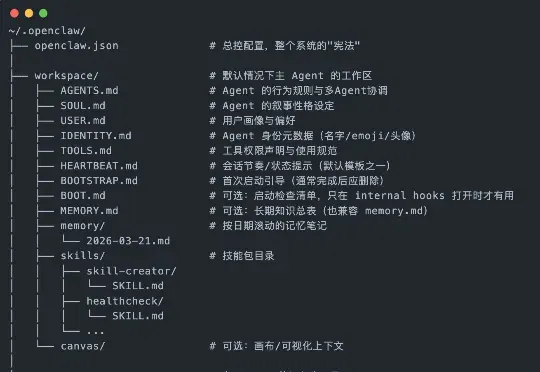
一边的人,每次跟 Agent 说话都像重新 onboarding:得再讲一遍背景、偏好和上下文。另一边的人,Agent 已经知道自己是谁、该怎么说话、用户讨厌什么,也记得上次积累下来的东西。这条分界线,叫 workspace。