500行极简开源框架,硬刚GPT/Gemini视觉极限!(在新窗口打开)
多模态模型代码写得像老司机,却在数手指、量柱子时频频翻车?UniPat AI用五百行代码打造的SWE-Vision,让模型「掏出Python尺子」自我验证,一举拿下五大视觉相关基准SOTA。
共 438 篇
多模态模型代码写得像老司机,却在数手指、量柱子时频频翻车?UniPat AI用五百行代码打造的SWE-Vision,让模型「掏出Python尺子」自我验证,一举拿下五大视觉相关基准SOTA。
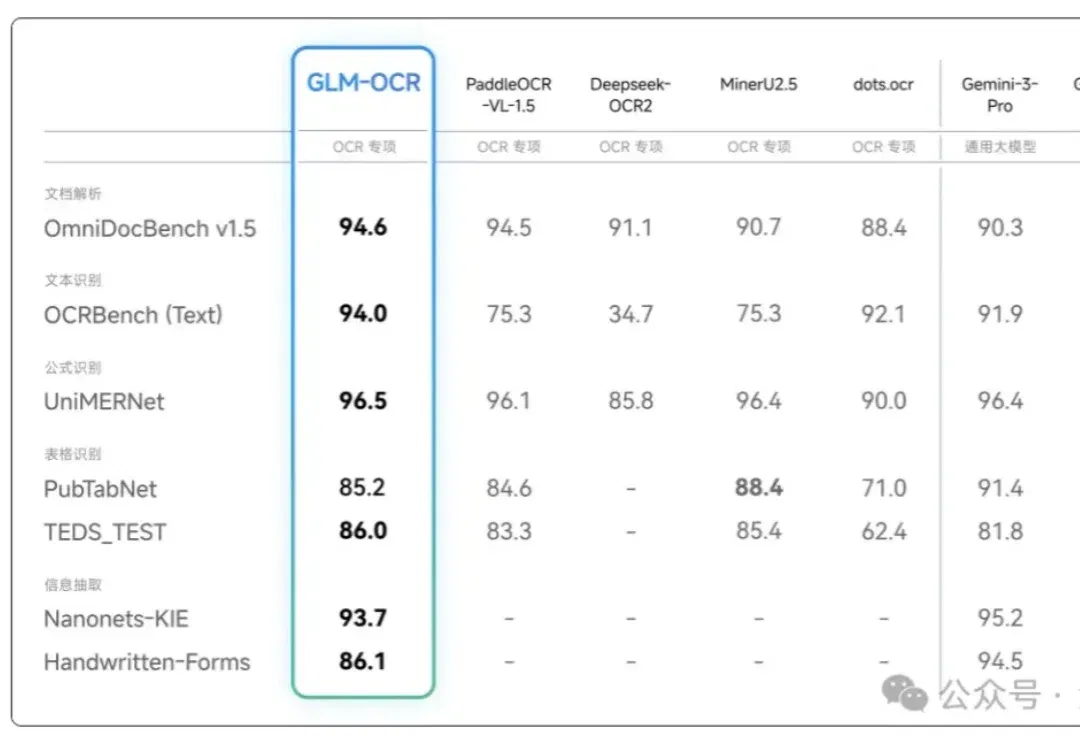
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
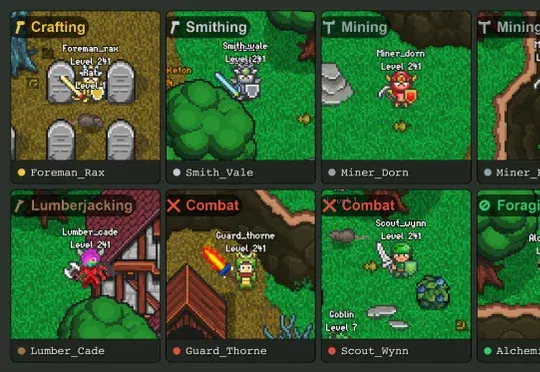
OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。
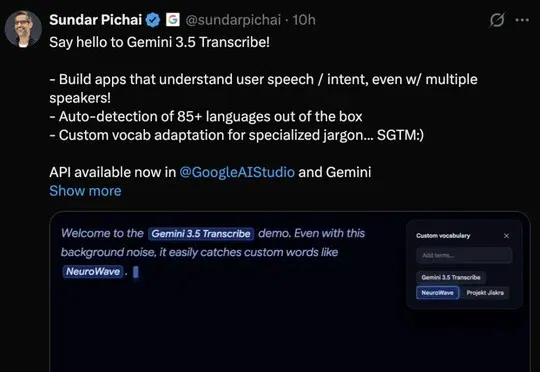
谷歌发布语音转文本模型Gemini 3.5 Transcribe,支持85种以上语言、流式转录与智能整理功能,流式词错误率为4.0%,文章认为该模型并非Agent时代的落伍产品,而是语音Agent走向生产环境所必需的关键基础拼图。
AI 产业的两大核心趋势正并行发展:基础大模型的能力持续突破,而 AI Agent 的产业化落地也在全面提速。Capgemini 于 2025 年 4 月发布的一项覆盖 14 国 1500 名企业高管的调研显示[1],已有 37% 的受访组织启动或实施 AI Agent 项目,另有高达 61 %的组织将在一年内跟进部署或进行探索,印证了该趋势的全球共识。
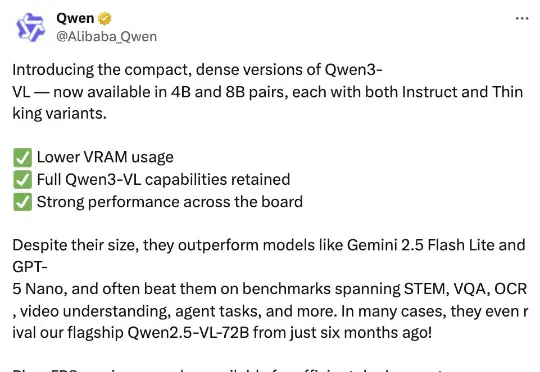
智东西10月15日报道,今日,阿里通义千问团队推出其最强视觉语言模型系列Qwen3-VL的4B与8B版本,两个尺寸均提供Instruct与Thinking版本,在几十项权威基准测评中超越Gemini 2.5 Flash Lite、GPT-5 Nano等同级别顶尖模型。
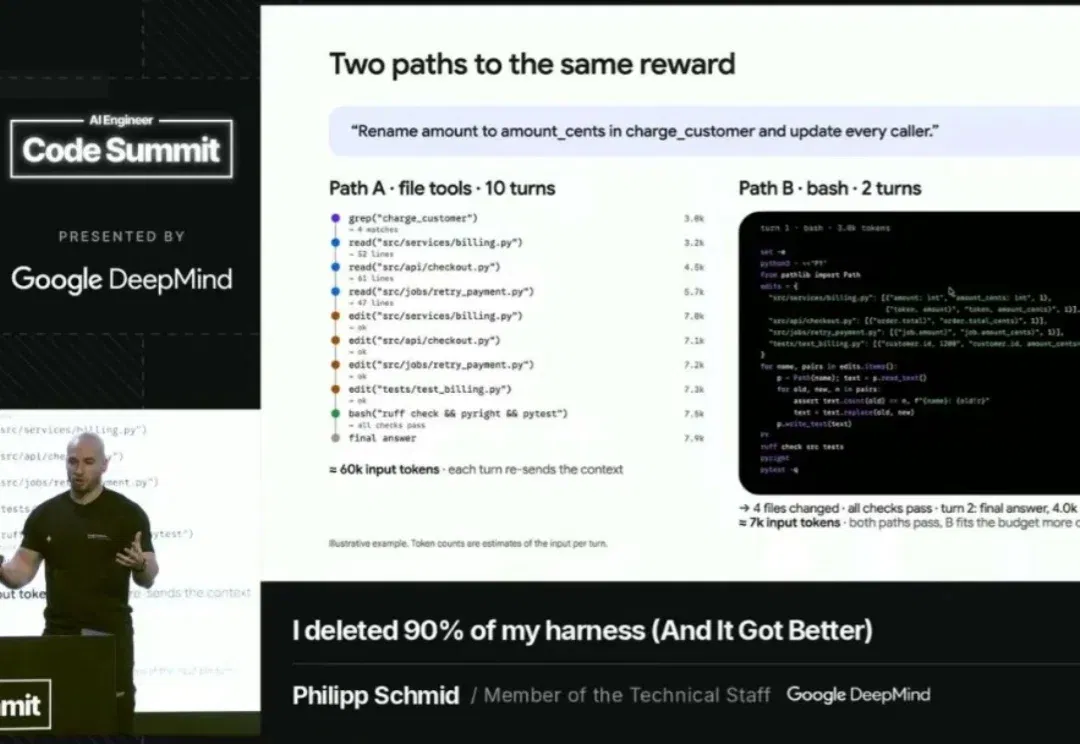
Philipp Schmid分享了只保留Bash和媒体查看器的智能体设计。其350余项任务对比中,完成率接近而Token与费用存在差异;单次运行结果仍需重复实验验证。
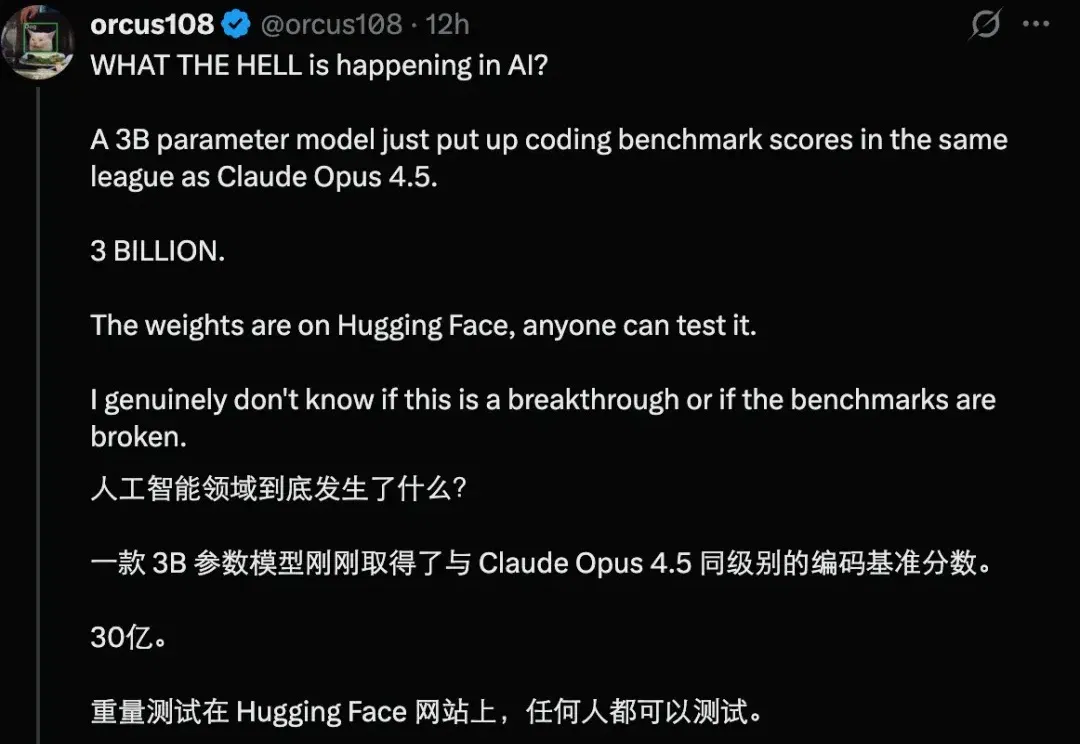
最近几天,一个 3B 的小模型在 X 上火了,因为在一些难度可验证的推理任务上(比如编程),它进入了 Gemini 3 Pro、GPT-5 high、Claude Opus 4.5、GLM-5、Kimi K2.5 等前沿模型的性能区间,而它的体积远小于这些模型。
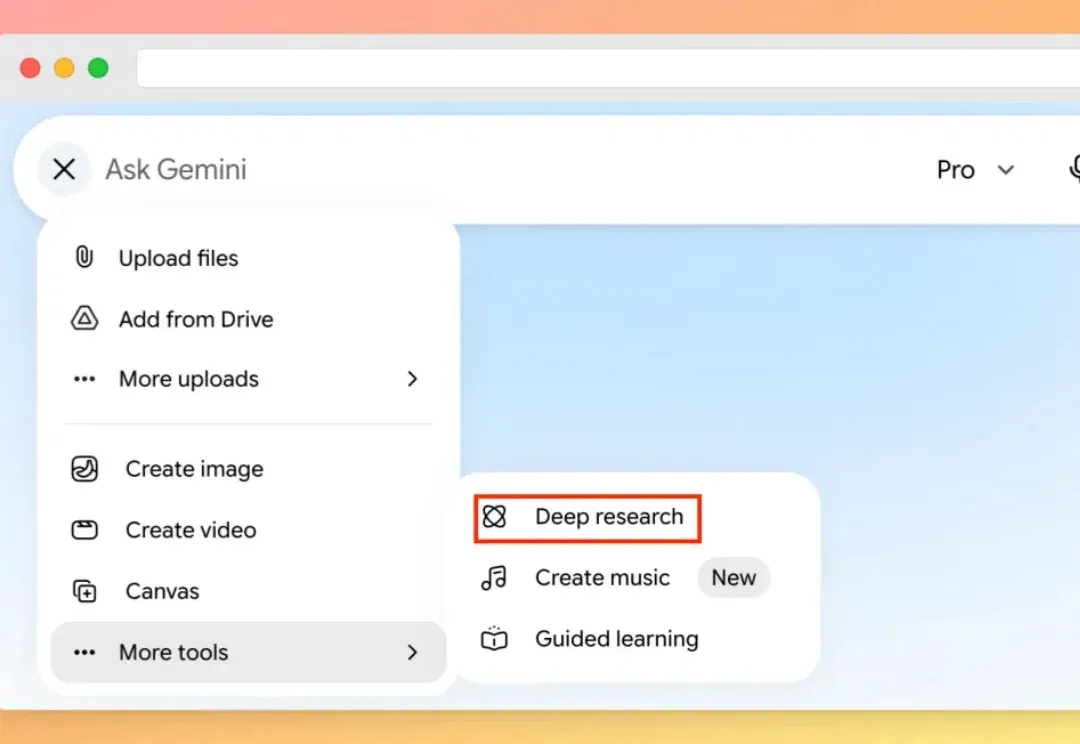
AI 工具推荐现在是门显学。 打开任何一个平台,都有人在告诉你「这 10 个 AI 工具必须收藏」「2026 年最强 AI 工具箱」。标题一个比一个夸张,列表一个比一个长。你点进去、收藏,然后,再也没有打开过。 我们自己也推过不少工具。但说实话,大部分 AI 产品用一两周就删了。 界面太复杂,响应太慢,免费额度用完就吃灰,还有的纯粹是「能做什么」和「我会用它做什么」之间隔了一条河。 一年下来,真正留在工位上、每天都在用的,就这几个。也顺便聊聊,它们是怎么嵌进我们真实工作流的。 信息太多的时代,先让 AI 理清关系 Gemini 深度研究 + Kimi 在所有被 AI 改变的工作环节里,搜索可能
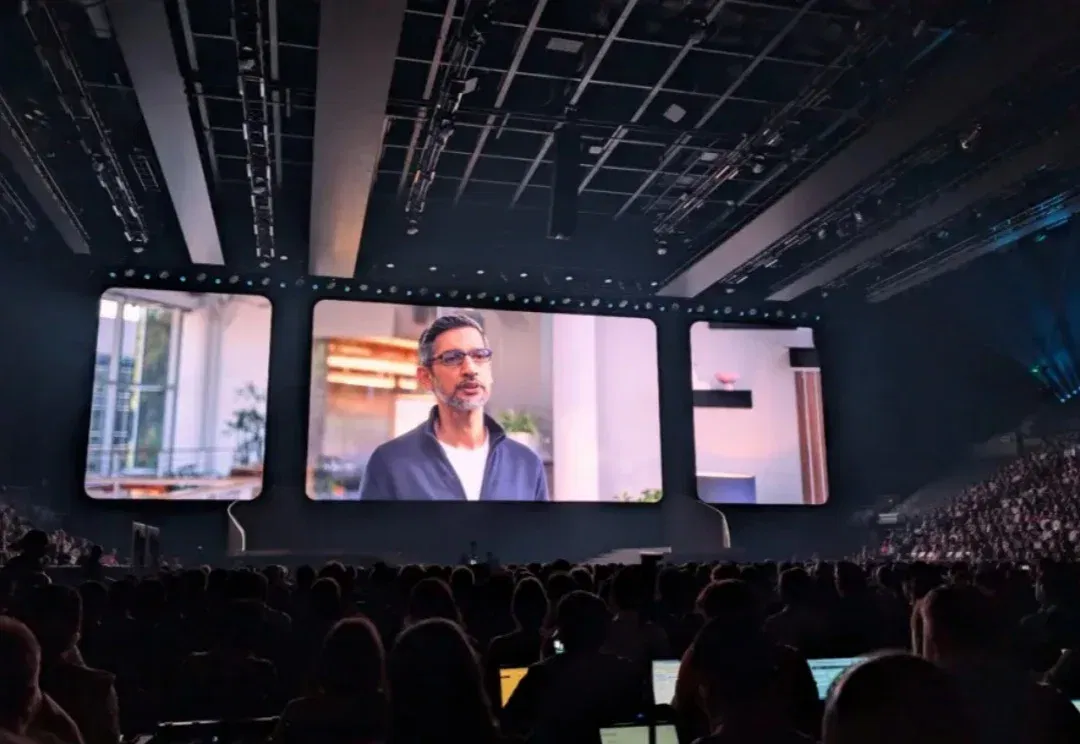
强如谷歌,算力也不够了。 在昨天拉斯维加斯的谷歌 Cloud Next 大会上, CEO 劈柴哥 (Sundar Pichai) 透露了令人震撼的数字: Gemini API 上个季度每分钟处理 100 亿 token——仅仅过去一个季度,就涨了足足60%,现在每分钟处理超过 160 亿 token。 增量很大程度上来自 agent 使用场景。一个任务被拆成十几步,每一步都是上下文读取,都是 API 请求,都在输入和输出 token。如果说简单的 chat 模式就是一来一回,那 agent 的到来让一切都变了,变成了一台「大电脑」带着一群「小电脑」在给你干活。 推理成本曲线也显著攀升了…… 为