名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」(在新窗口打开)
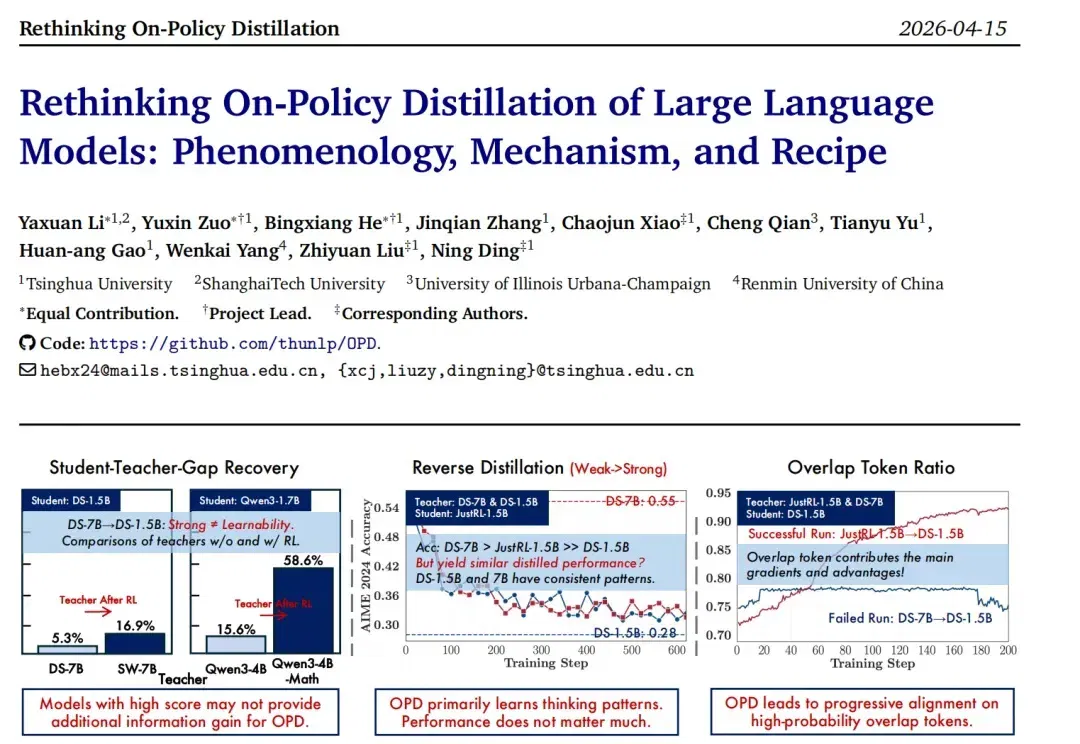
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
共 362 篇
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
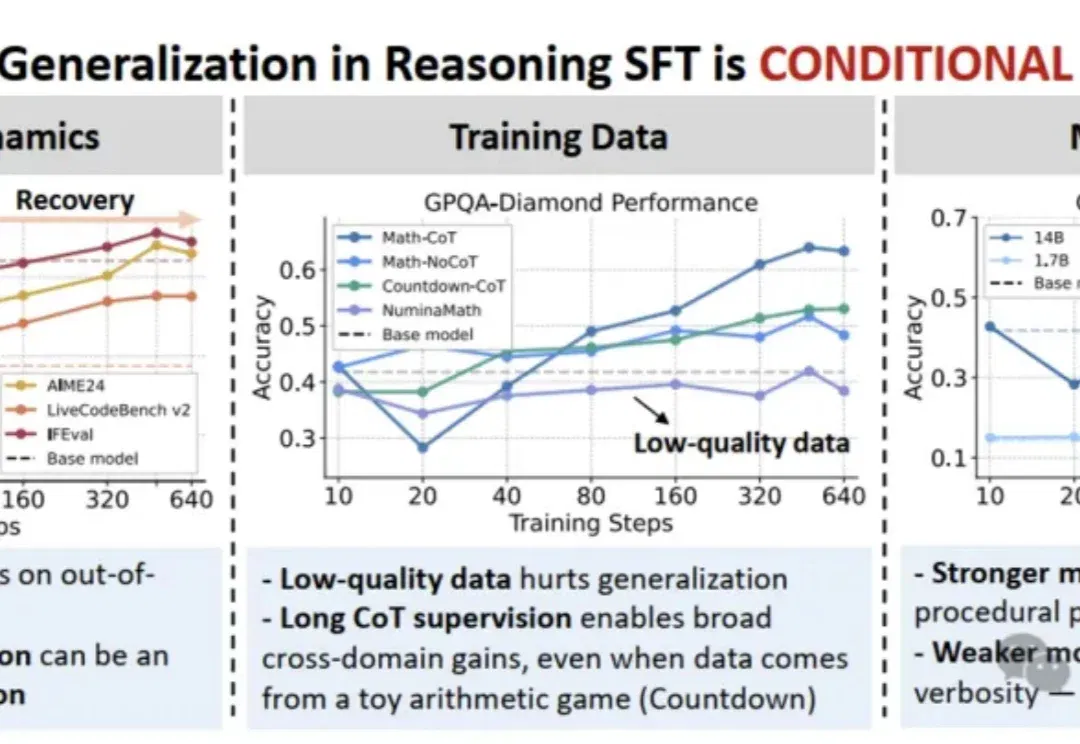
随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。
懂王开始做 API 中转站了,还七折的 Claude 的 API。买多了,还抽送懂王的私人晚宴名额!项目叫 WorldClaw,可以理解为 OpenRouter 的懂王版,在这里,需要用懂王的加密货币 WLFI 结算,聚合了 300 多个 AI 模型,声称比官方定价低 30%
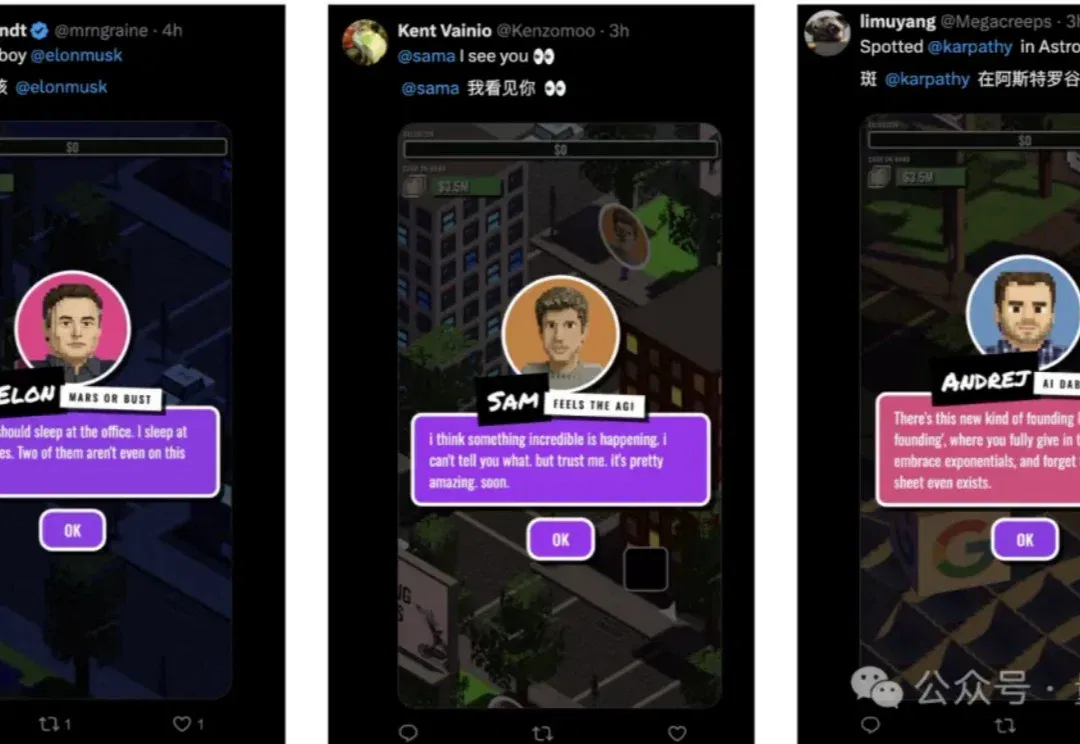
李飞飞又拿到钱了。5600万美元。 不是做世界模型的World Labs,是她联创的一家AI游戏公司,叫Astrocade。 你可能没听过这个名字。 我第一反应也是,等等,飞飞老师什么时候还搞了个游戏公司? 调研了一下,发现Astrocade想做的事情,其实蛮「常规」的: 任何人,不用写一行代码,用自然语言描述你想要的游戏,几分钟之内就能玩上。 比如这个硅谷模拟创业游戏,就是用他们的产品做出来的。 马斯克、卡帕西、奥特曼……都在里面。 虽然但是,听着像是又一个跟投资人吹水的AI颠覆XX行业的叙事,对吧? 但这组数据让我闭嘴了,上线8个月,2000万用户,每个月1.4亿次游玩,来自80多个国家的
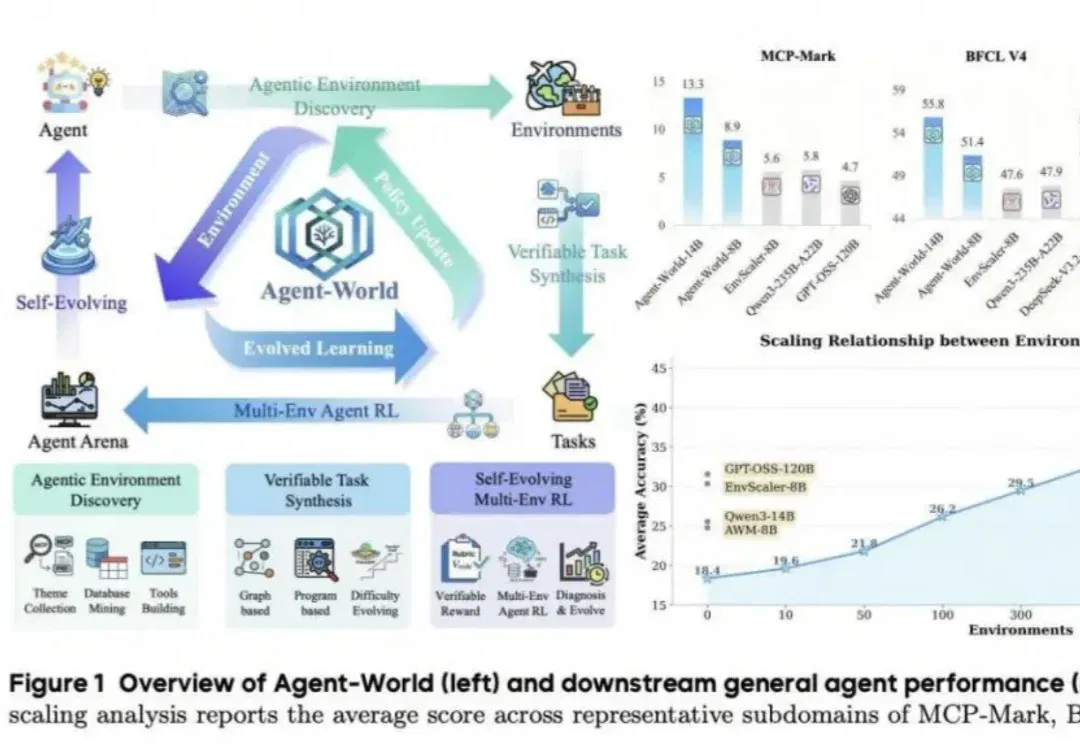
随着MCP、Agent Skills与各类Harness的快速发展,大模型能轻松调用成百上千种外部工具,但在多工具,具备复杂状态、长程交互的任务上仍有明显短板。尽管一系列环境扩展方法尝试复刻真实世界的交互环境(如订票系统,外卖平台),但仍受限于环境扩展的规模与真实性。
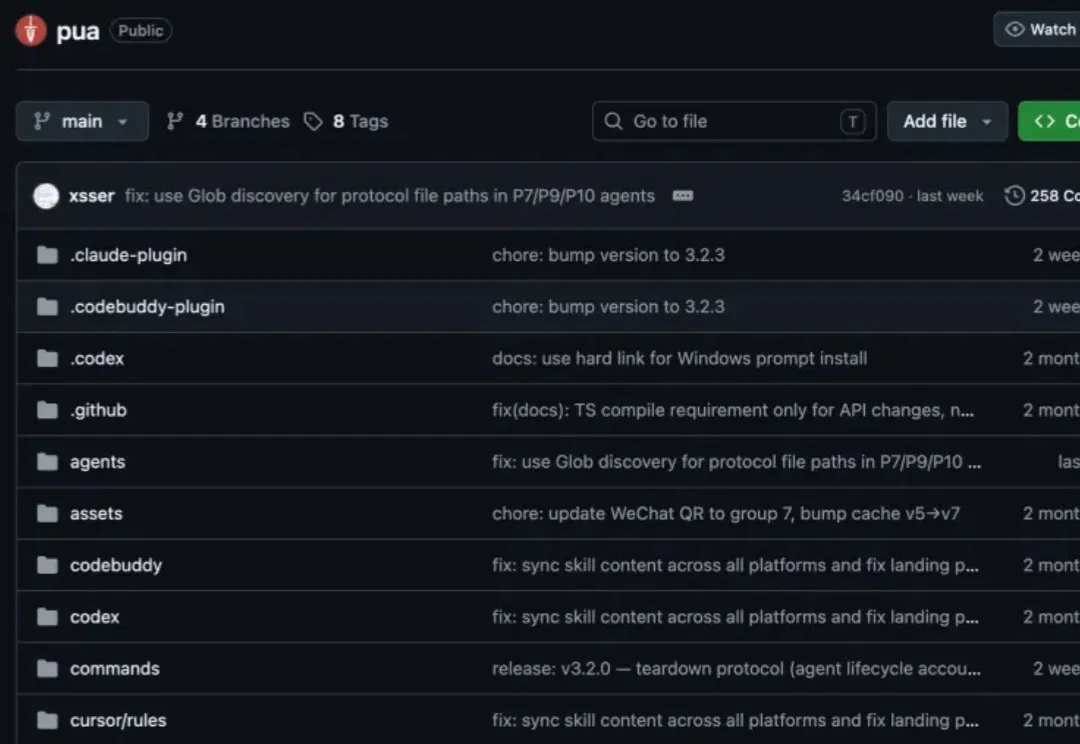
真的,你有过这种时刻吗。 盯着终端,看你的 AI coding agent 在同一个错误上失败了第 17 次。日志一行一行地滚,它还在重试。Ctrl+C 按得手都酸了,它停下来喘口气,然后又开始第 18 次。 你不知道该笑还是该砸电脑。你甚至开始怀疑,这玩意是不是在装傻。 如果你有过这种时刻,那今天要聊的这两个 GitHub 项目,就是为你准备的。 它们的方式不太一样,但目标高度一致,治一治 AI agent 的摆烂问题。 openwhip,真正的物理鞭打 先聊第一个。 它叫 OpenWhip。项目介绍就一句话,「Sometimes Claude Code is going too slow,
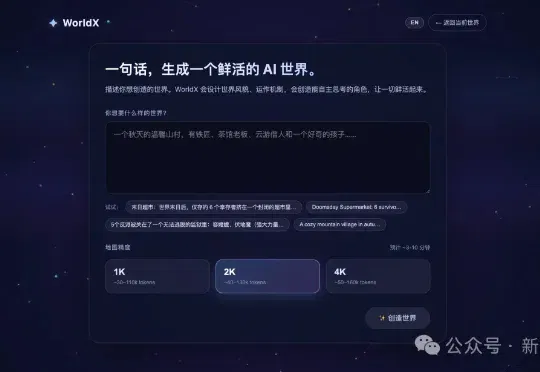
2023年斯坦福「AI小镇」火了,后续也诞生了大量类似的热门项目,但所有这类项目都有一个共同瓶颈——世界是人工搭建的,固定的。最近,一位独立开发者用10天婚假爆肝了一个项目WorldX:输入一句话、5分钟,一个完整的AI世界就诞生了——地图、角色、动画、人设全部自动生成,AI角色们自主在其中生活、对话、形成记忆、产生戏剧性的涌现行为。
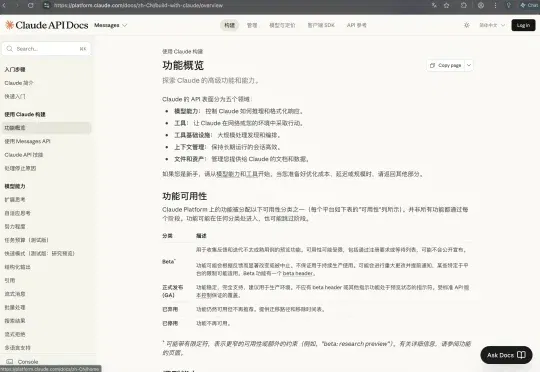
我发现:Claude 一边把中国大陆挡在门外,一边在认认真真做简体中文。事情是这样—— 前两天我把 Claude 文档 URL 里的 /en/ 改成了 /zh-CN/。页面唰地就变了。整站简体中文,翻译贼讲究。
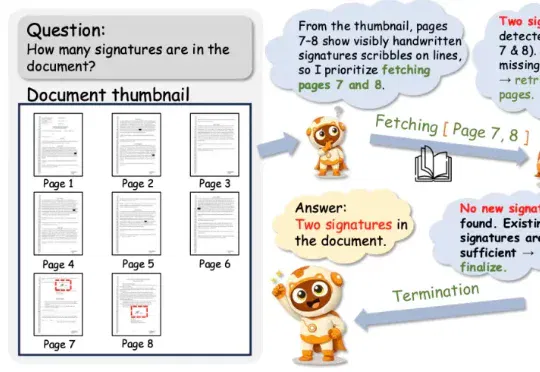
Doc-V* 由小米大模型 Plus 团队和华中科技大学 VLRLab 团队合作提出,一种从「静态阅读」到「主动探索」的多页文档理解新范式,通过交互式视觉推理让模型像人一样有策略地阅读长文档。
世界模型黑马横空出世!就在刚刚,生数科技的MotuBrain零宣发登顶双榜,直接打通「看懂世界+执行行动」,而且不同的是,他们把World Action Model适配多个头部机器人本体,完成多个长程任务,这是国产AI的硬核突围!从此,具身智能彻底迈入新纪元。