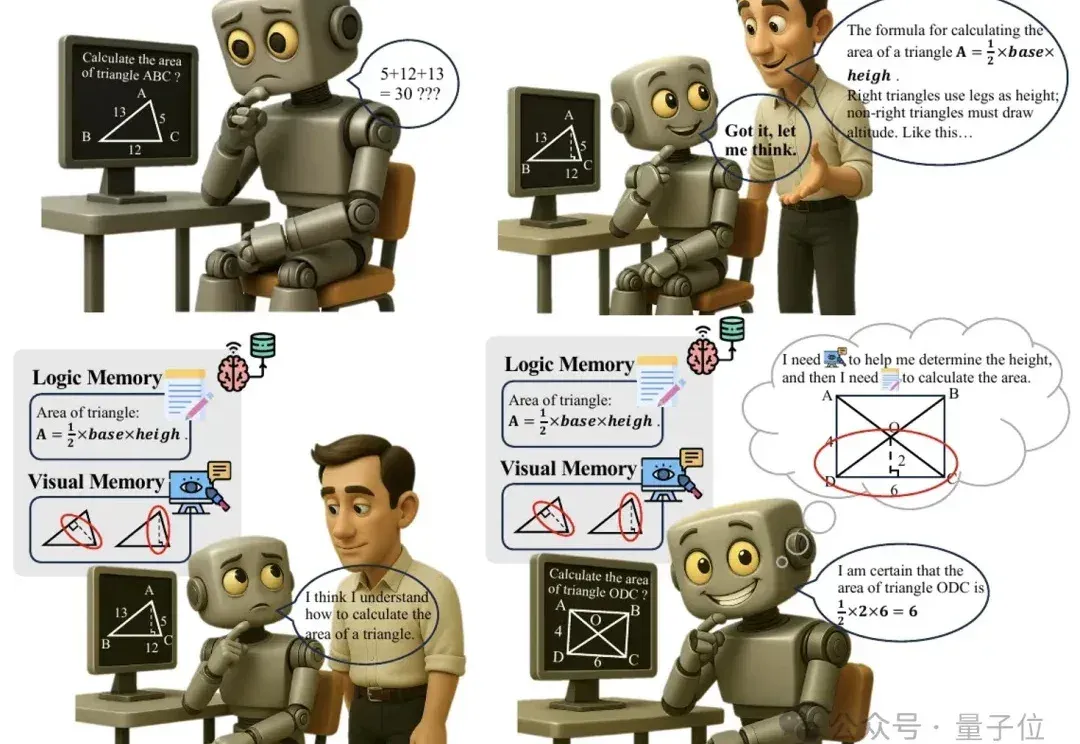
让大模型“吃一堑长一智”,南理工百度等提出模型记忆新方法(在新窗口打开)
多模态推理又有新招,大模型“记不住教训”的毛病有治了。
共 1517 篇
多模态推理又有新招,大模型“记不住教训”的毛病有治了。
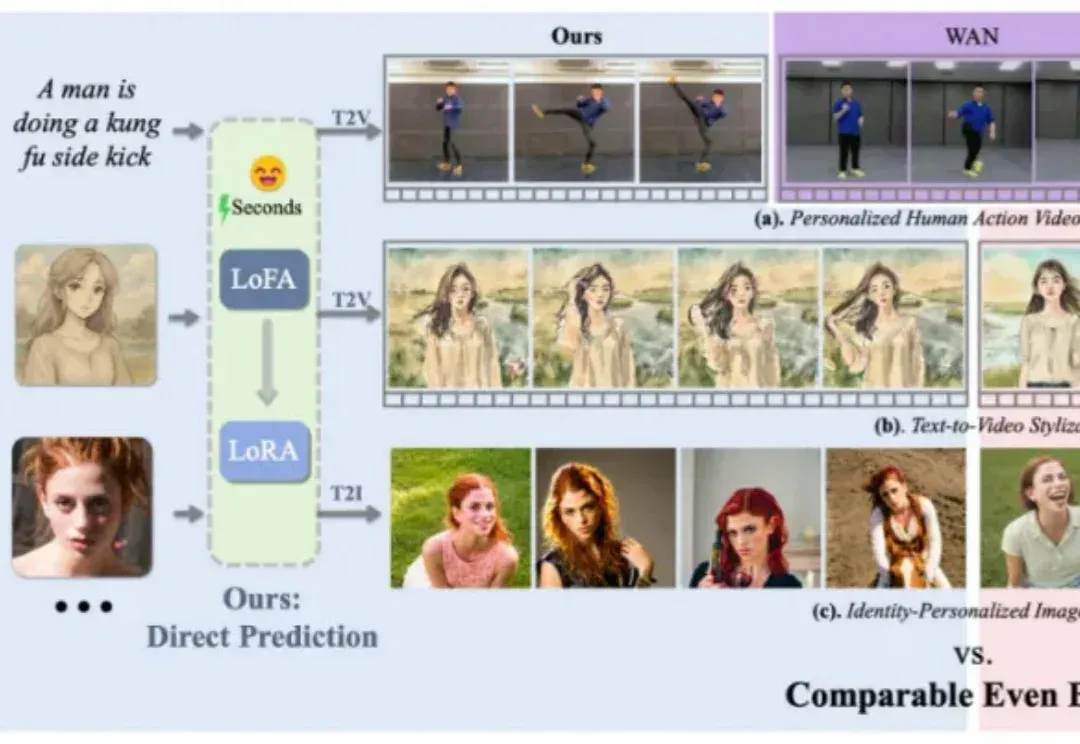
在个性化视觉生成的实际应用中,通用视觉基础模型的表现往往难以满足精准需求。为实现高度定制化的生成效果,通常需对大模型进行针对性的自适应微调,但当前以 LoRA 为代表的主流方法,仍受限于定制化数据收集与冗长的优化流程,耗时耗力,难以在真实场景中广泛应用。
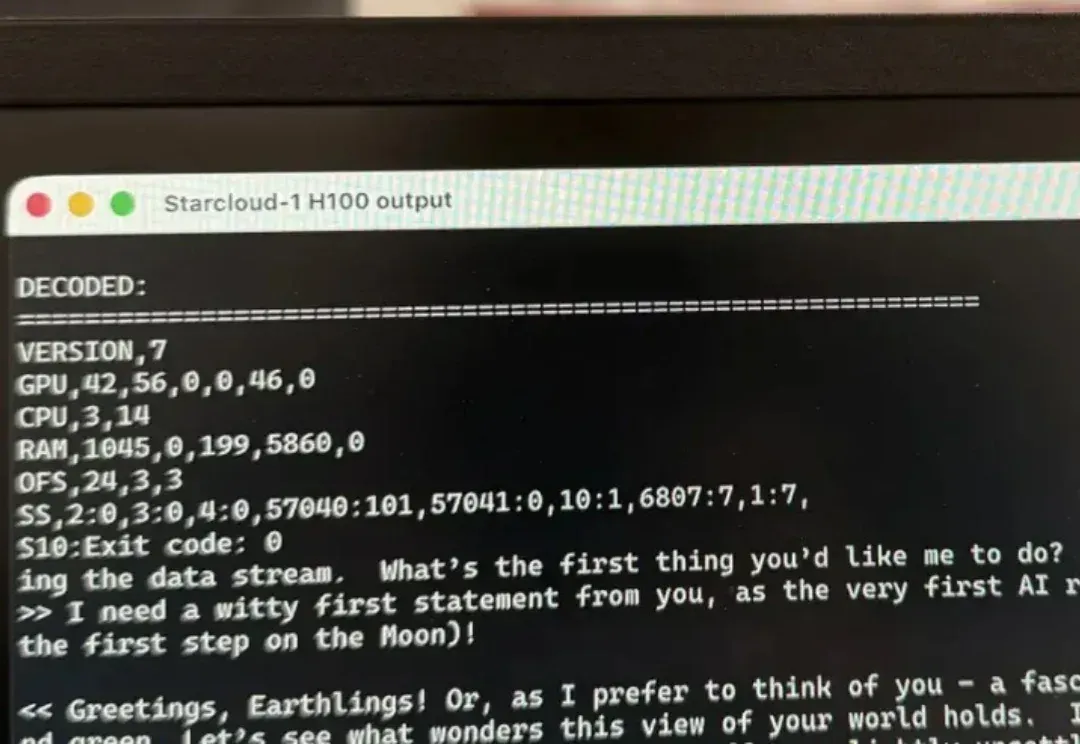
AI真的上天了。 人类首次实现了在太空训练、运行大模型。 而主角我们也很熟悉:英伟达、SpaceX、谷歌……还有前OpenAI联合创始人卡帕西的NanoGPT。 几个名字一出,故事就很明确了—— SpaceX火箭把英伟达H100芯片送上太空后,在轨道上运行了谷歌的开源AI大模型Gemma,并获取到了回应: 你们好,地球人! △图源:CNBC 除了Gemma之外,还在H100上用莎士比亚全集训练了卡帕西的大语言模型NanoGPT。 对此,网友有话说:以后外星人想研究地球就不用亲自来一趟了(doge)。 首次太空训练AI 上个月初,作为Nvidia Inception一员的、聚焦太空数据中心的初创
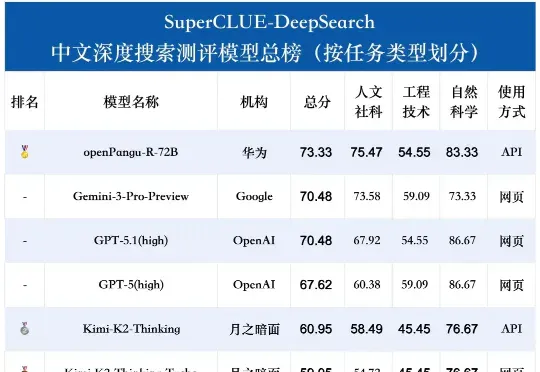
近日,第三方评测机构 SuperCLUE 发布 11 月 DeepSearch 评测报告,国产大模型 openPangu-R-72B 凭借在长链推理、复杂信息检索领域的卓越表现,在模型榜单中名列第一,体现了基于国产昇腾算力的大模型研发实力。
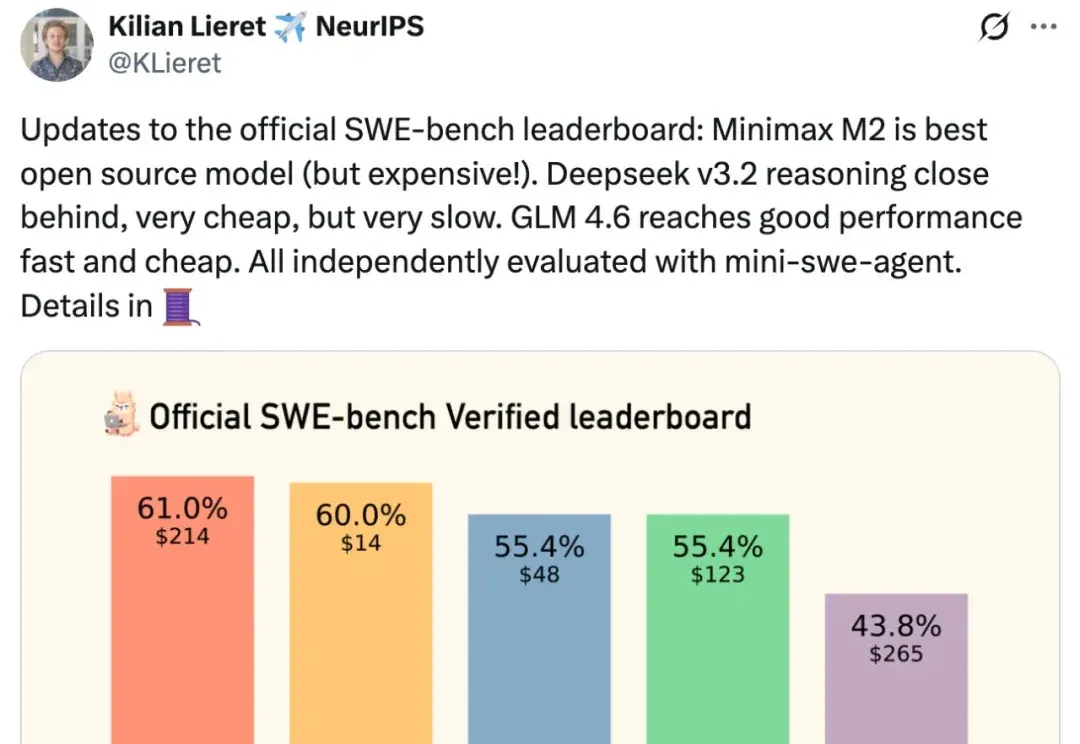
昨日,有位推特博主晒出了国内几大开源模型在轻量级软件工程 Agent 基准测试 mini-SWE-agent 上的成绩。该基准主要测试大模型在真实软件开发任务中的多步推理、环境交互和工程化能力。
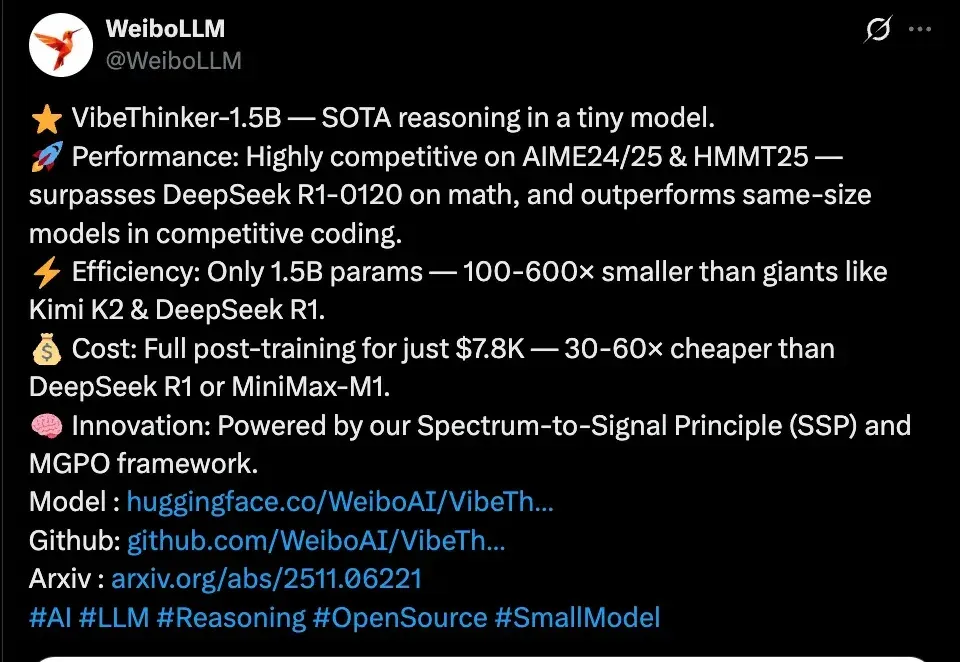
近日,微博正式发布首个自研开源大模型VibeThinker,这个仅拥有15亿参数的“轻量级选手”,在国际顶级数学竞赛基准测试上击败了参数量是其数百倍的、高达6710亿的DeepSeek R1模型。
今年阿里第三次集中力量办大事。 在科技公司大建 AI 的叙事里,阿里之前更像美国的亚马逊、微软 —— 没有微信、抖音那样的全民流量入口,AI 投入选择偏向企业客户,不断买卡建算力中心,以云计算业务抓住千行百业对 AI 的渴望。 过去几年,阿里在 AI 方面的主要进展也不在应用层 —— 入股多家中国头部大模型创业公司、自研的 Qwen 系列大模型在诸多测试赢过其他开源模型、阿里云加速增长。但 AI 助理 “千问 app” 在 11 月 17 日正式宣布公测说明阿里想要更大的剧本。 新的千问应用明确对标 ChatGPT 最新的 5.1 版本。它由此前的通义 app 和夸克 AI 对话助手升级而来,
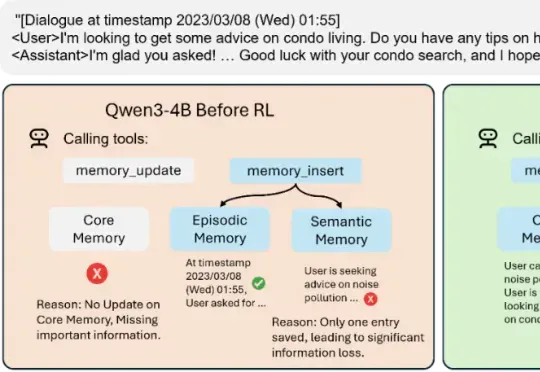
Mem-α 的出现,正是为了解决这一困境。由加州大学圣地亚哥分校的 Yu Wang 在 Anuttacon 实习期间完成,这项工作是首次将强化学习引入大模型的记忆管理体系,让模型能够自主学习如何使用工具去存储、更新和组织记忆。
杨红霞,是中国大模型领域一个无法绕开的名字。人们从 M6 模型(阿里达摩院发布的万亿参数 AI 大模型)开始熟知她,而她又在最近走出创业隐匿模式,正式向世界宣告自己已经是一名创业者,并希望能够做出下一
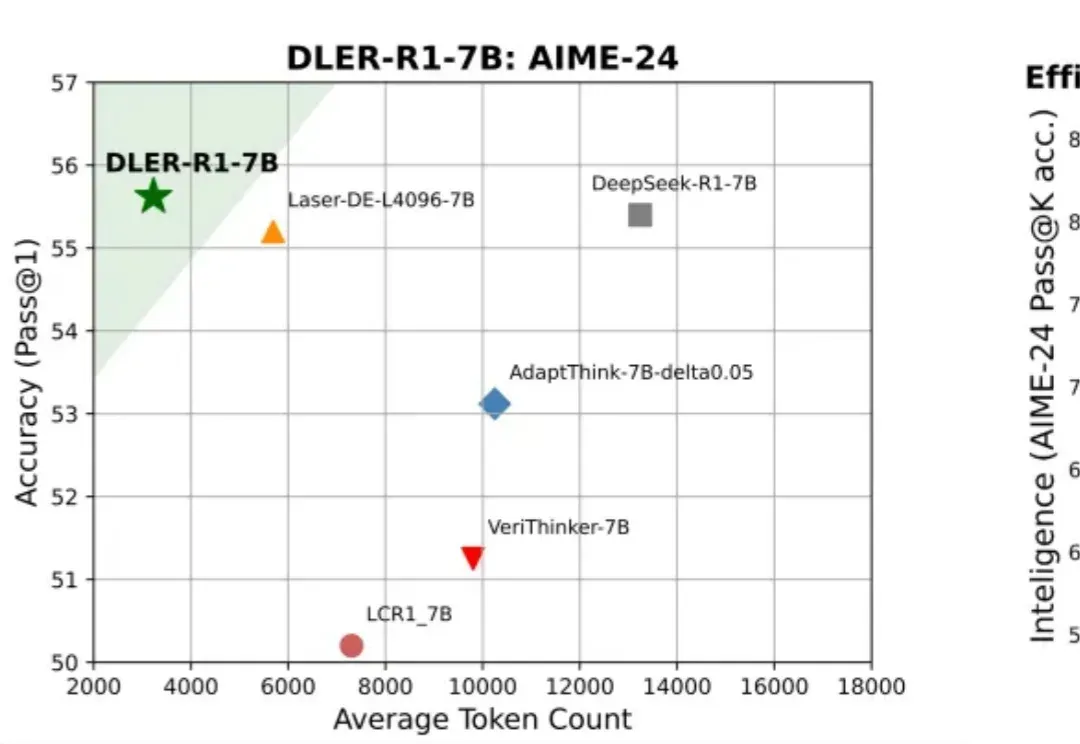
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。