NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了(在新窗口打开)
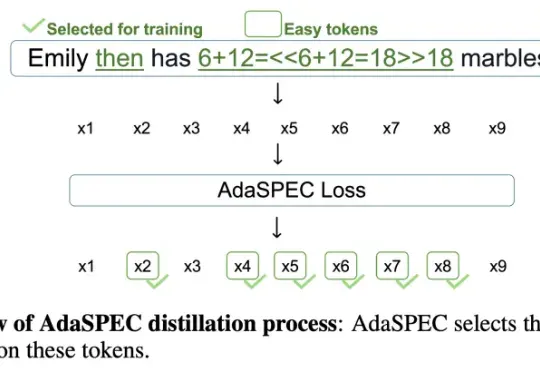
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
共 619 篇
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
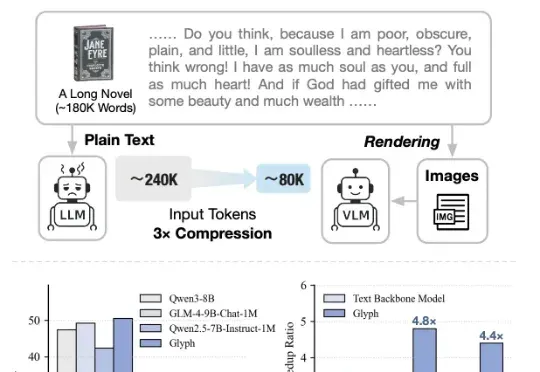
太卷了,DeepSeek-OCR刚发布不到一天,智谱就开源了自家的视觉Token方案——Glyph。既然是同台对垒,那自然得请这两天疯狂点赞DeepSeek的卡帕西来鉴赏一下:
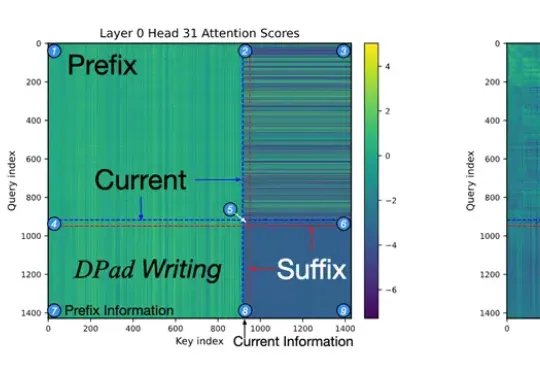
杜克大学团队发现,扩散大语言模型只需关注少量「中奖」token,就能在推理时把速度提升61-97倍,还能让模型更懂格式、更听话。新策略DPad不训练也能零成本挑出关键信息,实现「少算多准」的双赢。
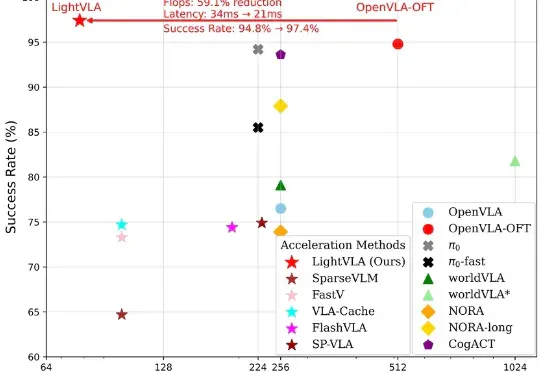
LightVLA 是一个旨在提升 VLA 推理效率且同时提升性能的视觉 token 剪枝框架。当前 VLA 模型在具身智能领域仍面临推理代价大而无法大规模部署的问题,然而大多数免训练剪枝框架依赖于中间注意力输出,并且会面临性能与效率的权衡问题。
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
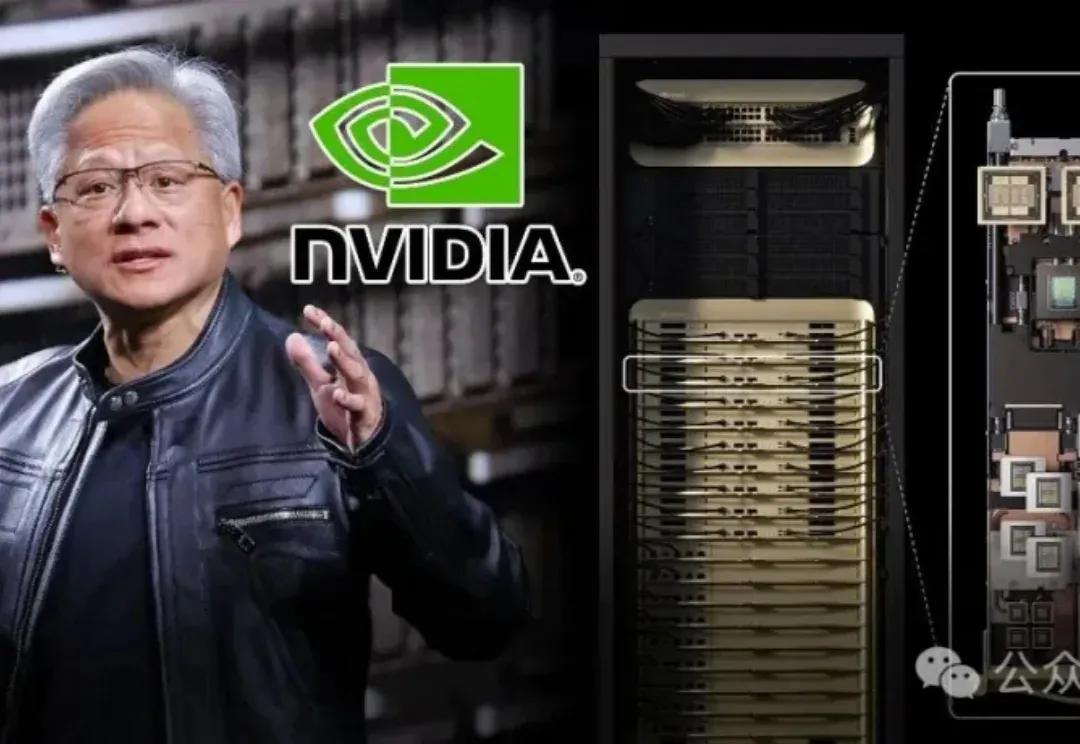
昨天,英伟达重磅发布了专为海量上下文AI打造的CUDA GPU——Rubin CPX,将大模型一次性推理带入「百万Token时代」。NVIDIA创始人兼CEO黄仁勋表示,Vera Rubin平台将再次推动AI计算的前沿,不仅带来下一代Rubin GPU,也将开创一个CPX的全新处理器类别。
最近,Claude Code 团队工程师 Thariq Shihipar又在X上发文了,上个月他写的Skill深度经验分享贴在社交平台爆火,这周他又发了一篇Claude的100万toke上下文窗口使用技巧的文章,平台阅读量已超过200万。
xAI重磅推出Grok 4 Fast,创新融合推理与非推理双模式,支持200万token上下文。在NYT Connections基准和AA智能指数中表现卓越,超越多家顶级模型,标志着AI智能获取门槛的进一步降低。
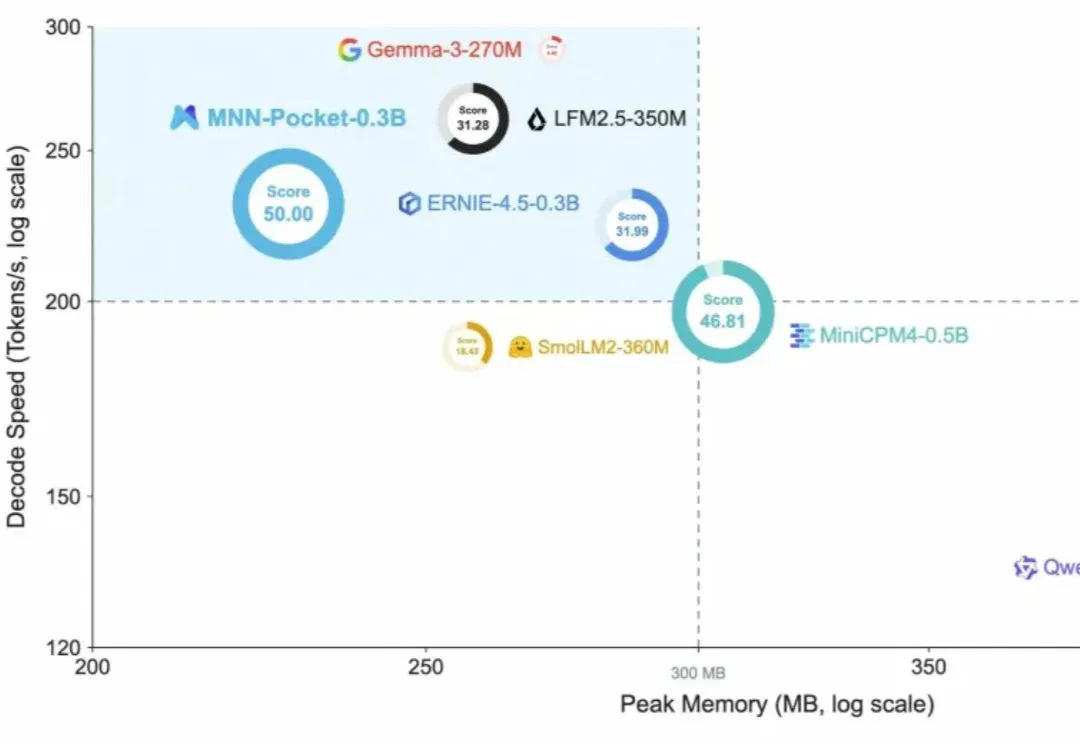
MNN-Pocket-0.3B 从结构、词表和推理引擎入手降低端侧开销。团队演示 iPhone 18 Pro 约 350 Token/s 的解码速度,并报告 INT4 文件 173 MB 与不同设备的测试结果。
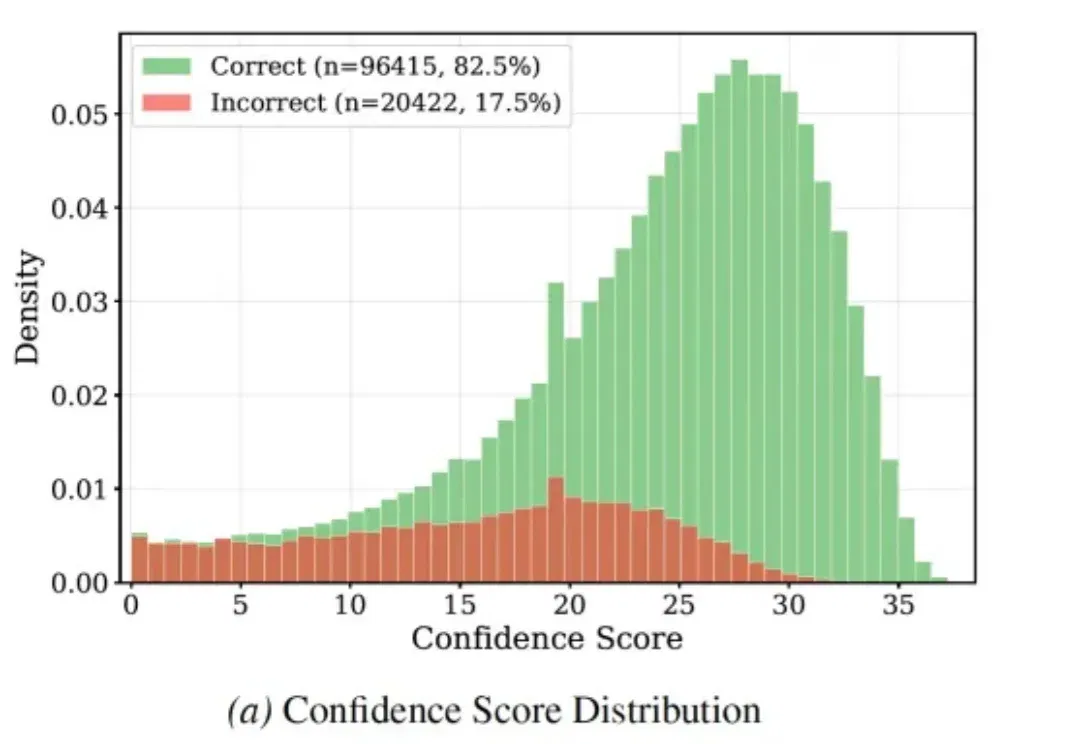
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。