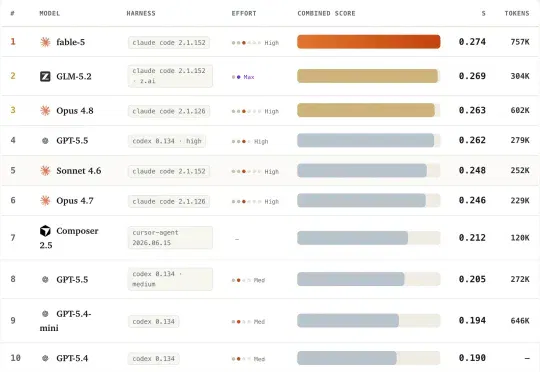
Claude、GLM、GPT谁才是真正的AI软件工程师?首个持续更新Visual Spec-to-App Benchmark发布(在新窗口打开)
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
共 285 篇
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
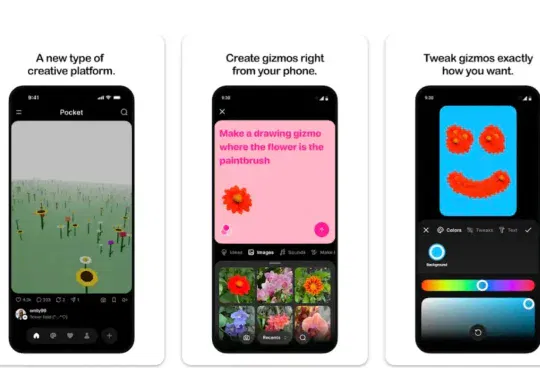
没有发布会,没有 Zuckerberg 的长文,Meta 就这样在六月底悄悄把一款新应用塞进了 App Store 和 Google Play。 这款叫 Pocket 的产品,直到七月初才被应用研究员 Alessandro Paluzzi 在 X 上扒出来。Appfigures 的数据证实,它最早出现在应用商店的时间是 6 月 29 日。没有官方公告,没有推广投放,甚至连美国用户眼下都下载不了
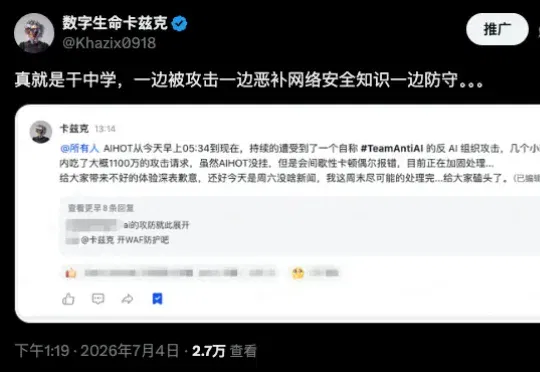
这个周末,可能是我最戏剧性的周末了。 周五发完Claude Fable 5的文章之后,看的人还是蛮多的,大家反馈也都不错。但是呢,我也不知道触动了谁,也有可能是某些大佬,可能想让我长长教训,或者想让我知道,Vibe Coding的网站就是狗屎,是有无数的安全隐患的。
Base44 是一家 vibe-coding 平台,一年前被 Wix 以 8000 万美元收购。当时,这家公司成立还不到六个月,团队只有 8 个人。如今,Base44 开始推出自己的 AI 模型,帮助用户通过自然语言创建应用。
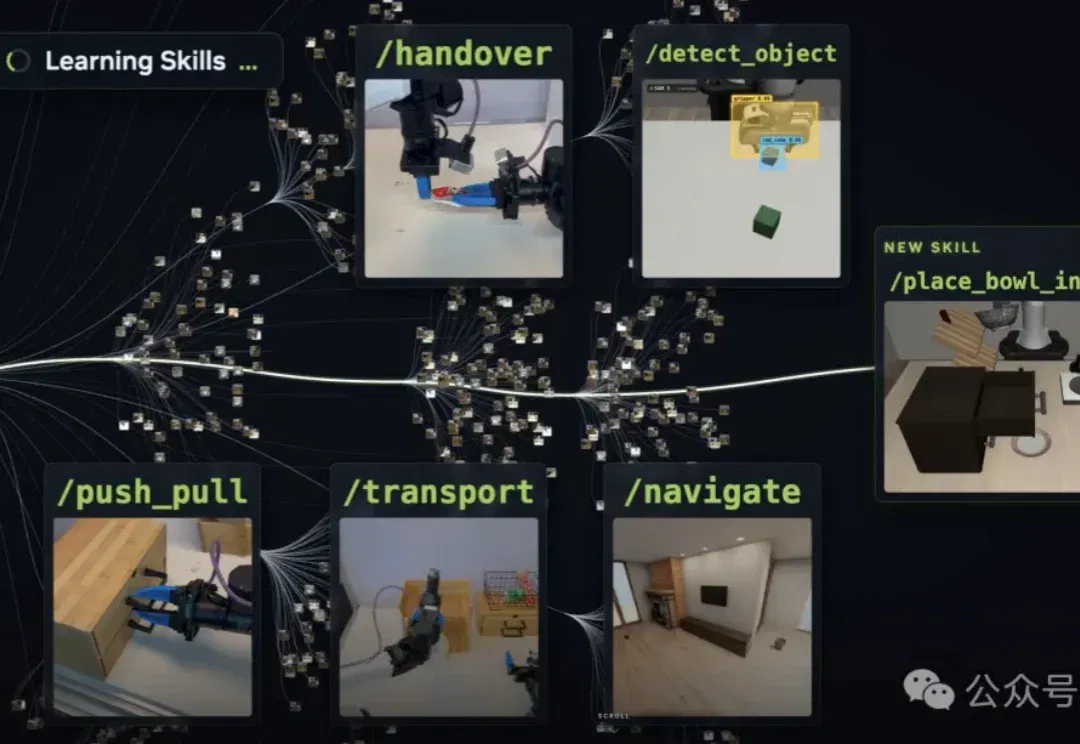
6!机器人也能学Skill了。 刚刚,英伟达放出了一套能让机器人持续成长的技能库—— ASPIRE。 简单理解,ASPIRE有点像一个机器人版Coding Agent。 就跟GPT能把你的prompt、工作记录炼成可复用的skill一样,它也会把机器人的一次次失败和修复,沉淀成之后能继续调用的经验。 只不过,它review的不是代码,而是机器人的操作过程。 每当机器人执行任务时,ASPIRE就会把感知、导航、抓取、碰撞、运动规划这些过程都记下来。 它背后调用的GPT / Claude则会像研究员一样,判断任务中哪里出了问题,迭代程序。如果跑通,就把沉淀出来的经验写进Skill。 由此,机器人就
全球最昂贵的浪费,正发生在最聪明的公司里。当你正 Vibe Coding 嗨到不行,或者跑着的项目突然停摆,打开 CLI 工具一看,「你的额度已用完」字样出现时,心态不崩是不可能的。
刚刚,DeepSeek V4 进行了一次更新。新推出了投机解码(Speculative Decoding)框架 DSpark,并同步开源了支撑该版本的全栈推测性解码框架 DeepSpec。DeepSeek-V4-Pro-DSpark 并非全新架构模型,而是在 DeepSeek-V4-Pro 基础上引入了推测性解码模块。此次更新的重点在于工程落地,而非模型能力本身的迭代。
当一个团队九成以上的代码都由 AI 写出,效率却只涨了六成——这两个数字之间,藏着 AI Coding 真正进入企业的全部难题。
Anthropic增加绿卡认证后,最开心是智谱,直接原地化身战狼,高呼「前沿智能属于所有人」,提前把专注Coding的GLM5.2发了。
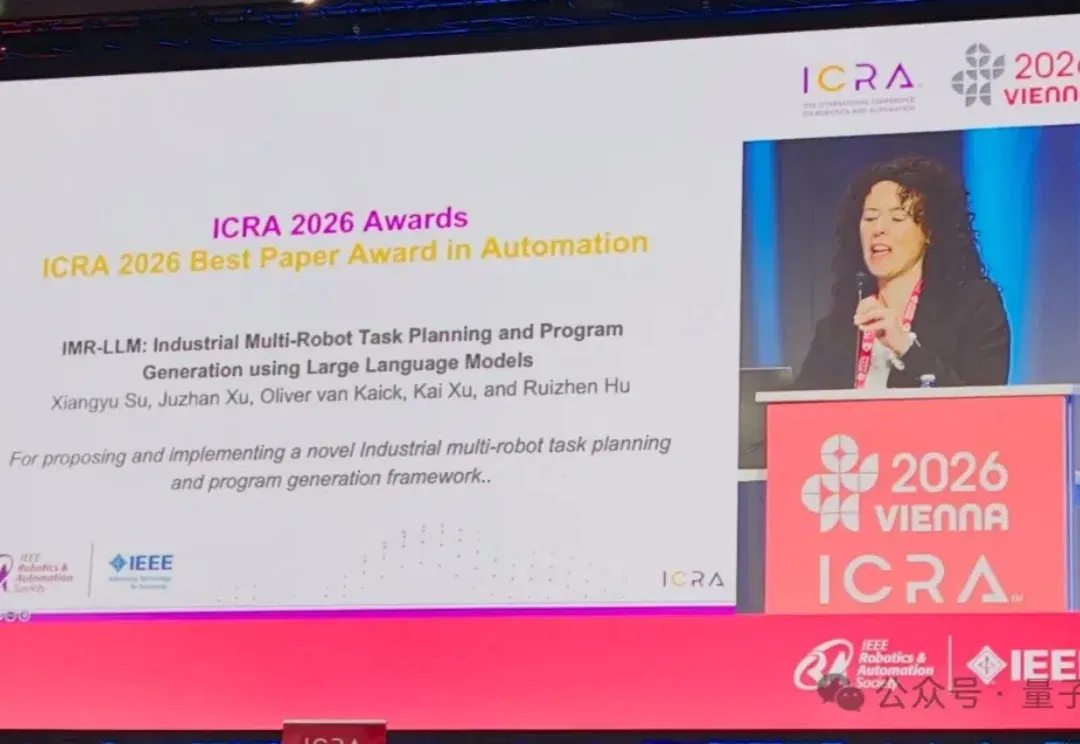
刚刚,在维也纳落幕的机器人顶会ICRA 2026上,最佳论文奖(自动化方向)颁给了一支中国团队。