AI智能体走出实验室!中科院等机构联合发布首个OpenClaw系统性综述(在新窗口打开)
上下文攻击、供应链渗透、AI社区崩溃……当大模型智能体真正进入开放世界,挑战远比想象中复杂。
共 348 篇
上下文攻击、供应链渗透、AI社区崩溃……当大模型智能体真正进入开放世界,挑战远比想象中复杂。
多模态长记忆在“看得准、找得到、想得清”三大环节的底层逻辑与工程避坑指南。
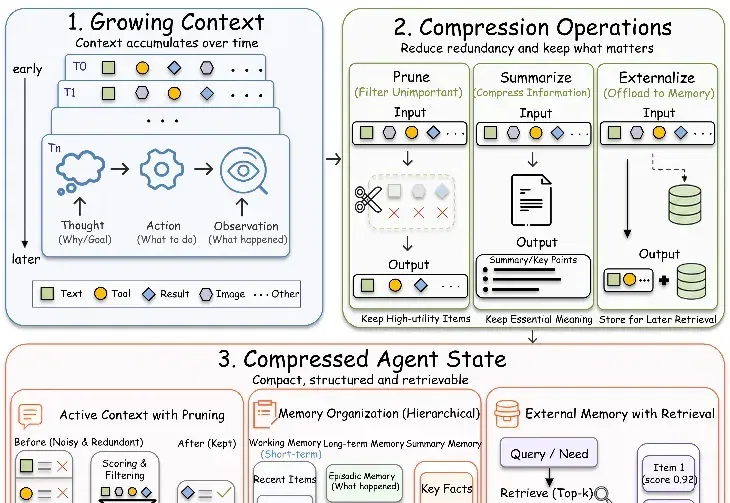
LLM Agent 做长任务时,真正让人头疼的往往不是模型不会推理,而是上下文开始失控:前几步还很清楚,后面就忘约束、丢状态、重复试错,最后把任务跑成事故现场。
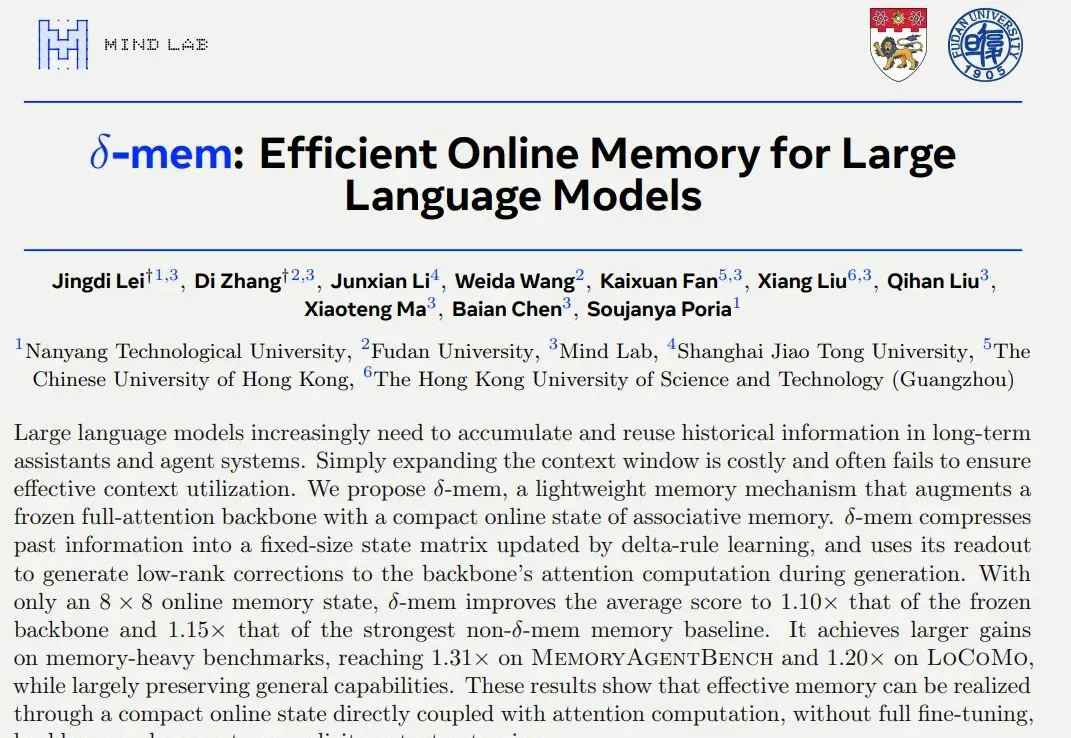
不扩上下文窗口、不换骨干架构、不做全参数微调 —— 只需要一个 8×8 的在线状态矩阵,就能让冻结的 Transformer 拥有真正的长期记忆。
长上下文模型越来越能“记”,但真正让它们跑到线上时,最先顶不住的往往不是算力,而是KV Cache。
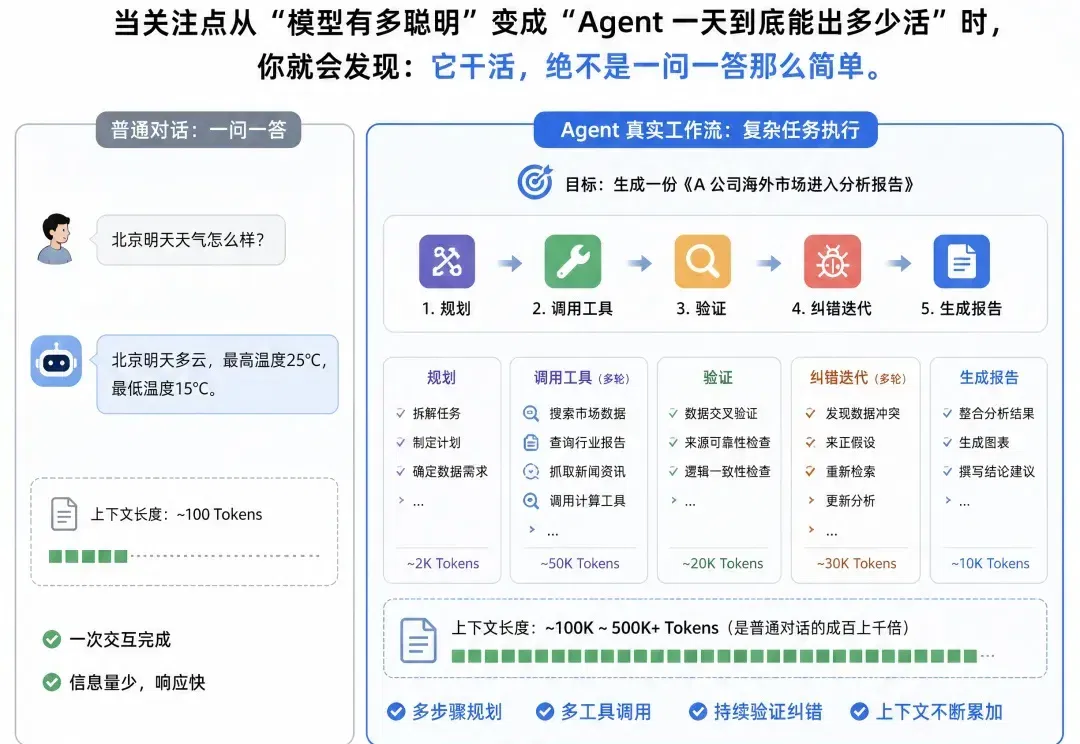
感觉大家对追新这事,没那么上头了。 要是去年,哪怕是大半夜发个新模型,朋友圈里必定有一票人熬夜实测。现在甩个新闻链接大家点个赞就算看过了。 我复盘了下大家热情消退的最大原因,就是现有模型已经够强了。 以前是我们拿既有问题去试,测完都觉得差口气。现在随便拎个主流模型出来,给 Agent 一挂,稳如老狗,自然懒得再去折腾所谓的“参数突破”。 当我们的关注点从模型有多聪明,变成 Agent 一天到底能出多少活的时候,你就会发现它干活,绝不是一问一答那么简单。 它需要不断地规划、调用工具、验证和纠错。这就导致它要处理的上下文长度,通常是普通对话的成百上千倍。只要任务还在推进,信息就会层层累加,Toke
过去三年来,所有人都在卷模型,参数更大、推理更深、上下文更长。但当Claude Code把Anthropic推到杀手级应用的位置、当OpenAI的Codex已经能替你写完一整本游记,问题终于绕了回来: 这些越来越像「人」的模型,到底要装进什么样的载体里,才算真正走进生活?
前沿的 Coding 能力、1M 的上下文窗口,还有原生的多模态
SophiaPro 成立于 2025 年 6 月。 最早,他们做的是一款叫 Karis.im 的 ToB 产品,给出海企业提供市场营销数字员工。后来转向 C 端产品,先是做了浏览器插件 TryClico,最近又推出了桌面端产品 Invoko.ai,一个长在 Mac 灵动岛位置的 notch 工具,帮用户在不同 app 之间自由切换上下文。
继 Step 3.5 Flash 后,阶跃星辰最近又推出新一代高效率 Flash 开源模型 ——Step 3.7 Flash。该模型最大特点就是多(模)、快(速)、好(用)、省(钱)。总参数 196B,采用稀疏 MoE 架构,推理激活参数仅 11B,配备 1.88B ViT 视觉编码器,推理速度最高 400 TPS,支持 256K 上下文。