神秘黑马-莫刻机器人冲榜WorldArena,仅32张真武810E封神(在新窗口打开)
机器人实验室里,这样的画面总是反复出现:屏幕上模拟的机械臂正以完美轨迹移动,但真实世界的一边,玻璃杯还待在桌面上,甚至已被夹爪打翻。
共 362 篇
机器人实验室里,这样的画面总是反复出现:屏幕上模拟的机械臂正以完美轨迹移动,但真实世界的一边,玻璃杯还待在桌面上,甚至已被夹爪打翻。
李飞飞老师的World Labs,补了块关键拼图。
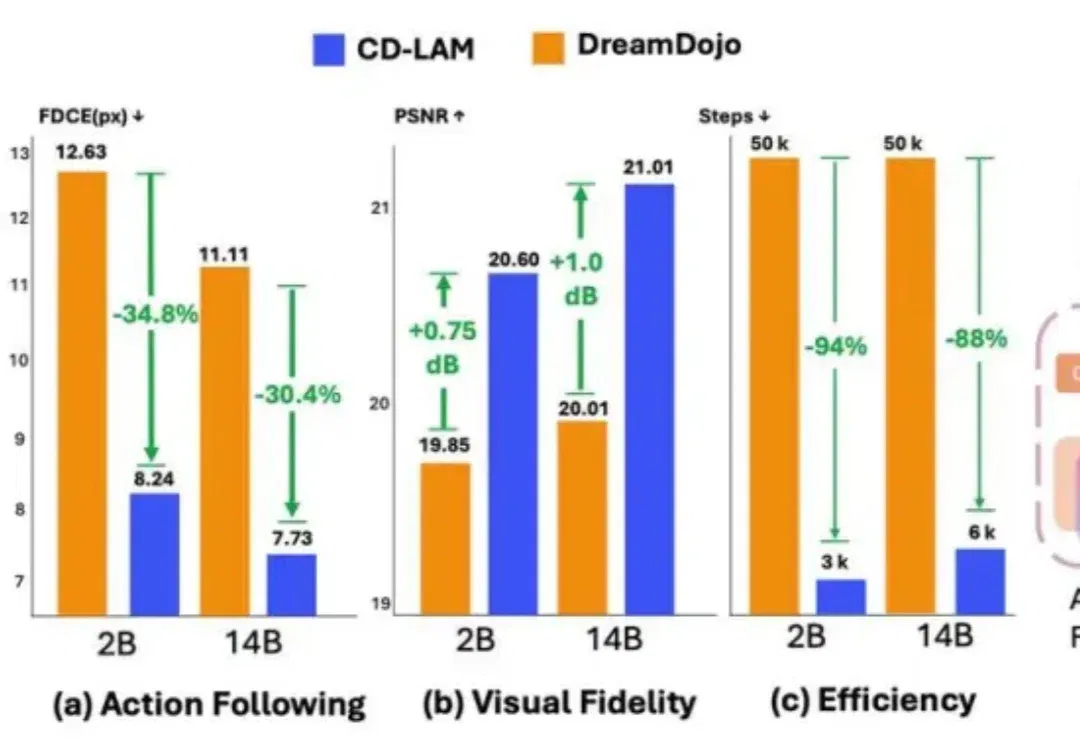
人类可以轻松想象一个还没做出的动作会带来什么:手一松,杯子会掉;往前一推,抽屉会合上。动作尚未发生,大脑已经预演了可能的结果。对机器人来说,具身世界模型(Embodied World Model)会根据当前观察和未来的动作,预测动作执行后的未来画面。
梅西其实早在为自己的人生下半场铺路。原来,他已经做起VC——2022年联合一群VC大佬在美国硅谷成立了一家风投公司Play Time。打开Play Time官网,赫然看到今年刚投了“AI教母”李飞飞创办的World Labs。
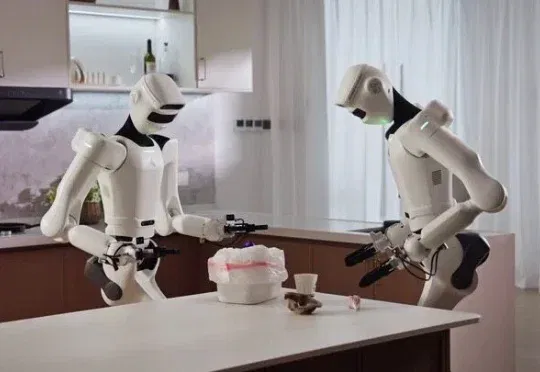
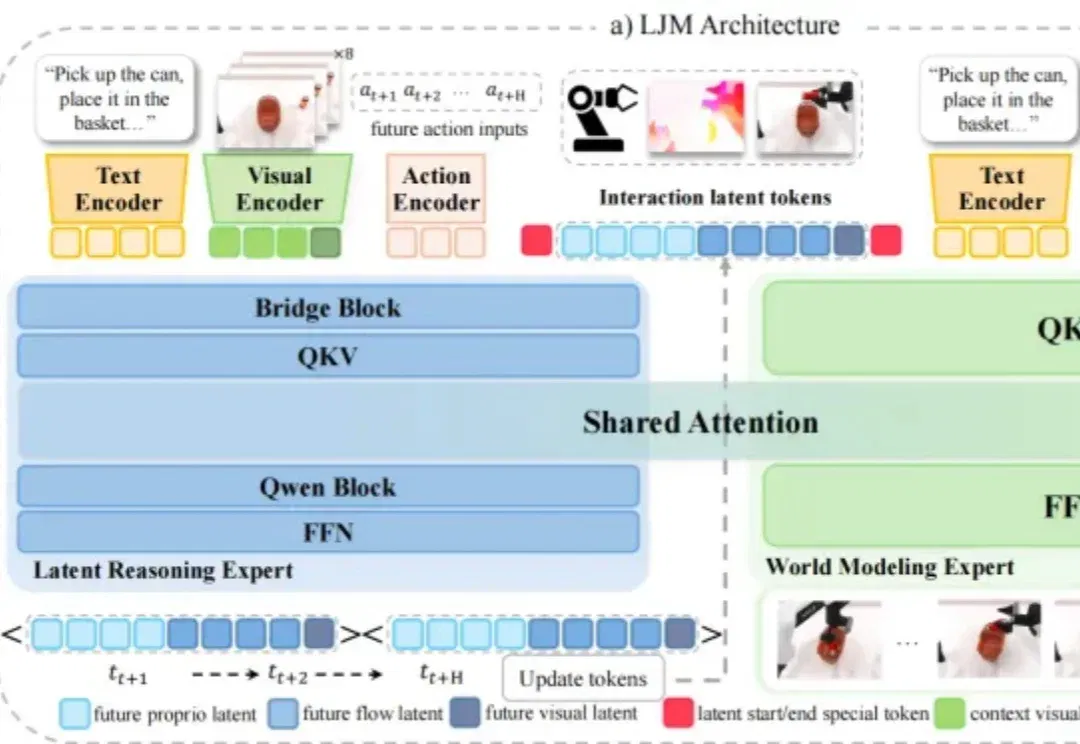
WAIC 前夕,星尘智能(Astribot)新模型 Lumo-2,直接在官网甩出 20 + 真机视频 ——这背后,是星尘智能发布的第二代具身基座模型,也是业内首个面向家庭场景的隐式世界 - 动作模型(Latent World-Action Model),同步发的,还智能体 Agent Philia。
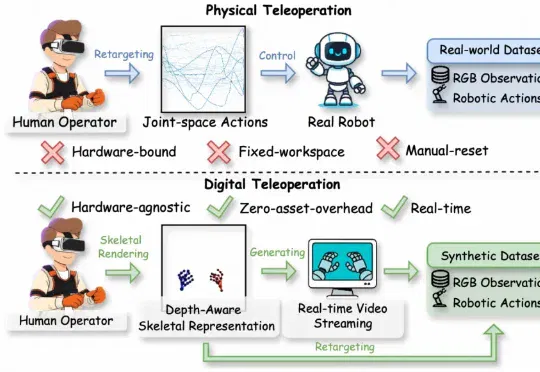
阿里巴巴达摩院的最新工作RynnWorld-Teleop对此给出的方案是:用生成式世界模型替代真实机器人。操作员的手势驱动一个实时视频生成器,由“数字世界中的机器人”完成全部视觉演示,同时自动获得关节级的动作标签。该方案被称为数字遥操作(Digital Teleoperation)。
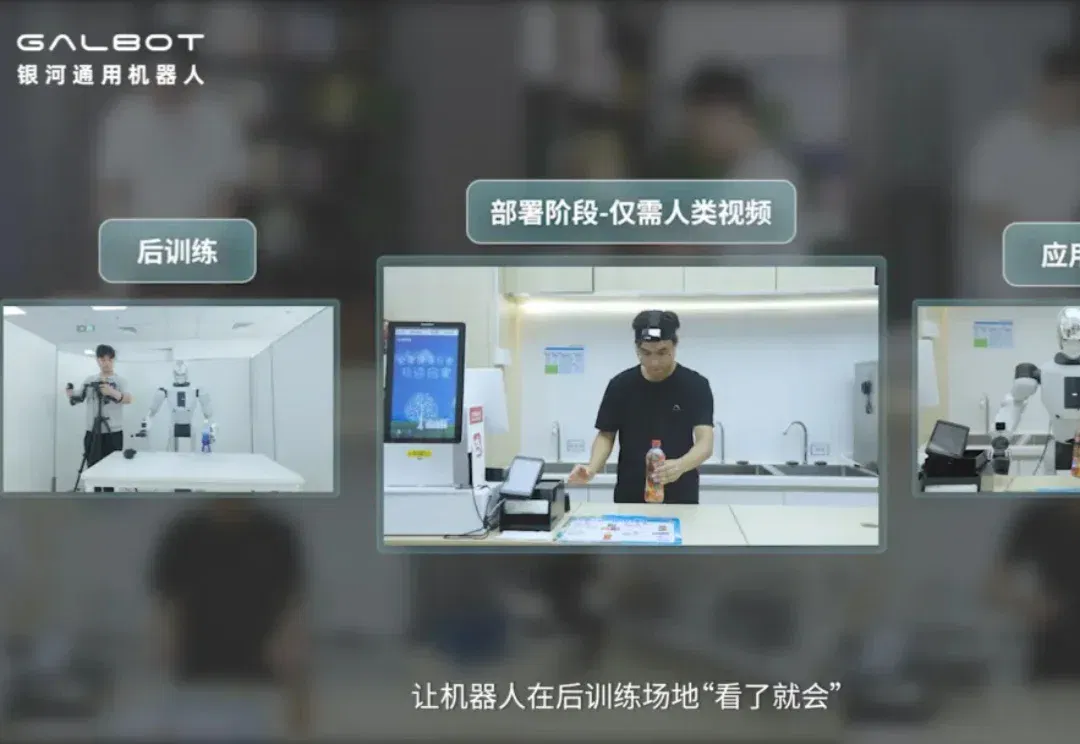
终于,现学现用的风也是吹到了具身智能。 要说这两年,大模型最重要的变化之一,就是越来越不依赖预训练一锤定音,部分能力开始留到推理时刻再兑现。 OpenAI o1如此,DeepSeek-R1也是如此。模型推理能力提升,靠的是在应用过程中的持续自我提升。 但机器人不一样,它面对的是比文本更复杂的物理世界,任意一次误判都有可能损坏抓取对象。想让机器人像大模型一样在部署时进化,行业内一直没有人做到。 直到今天,这条路线第一次被银河通用走通了。 刚刚,银河通用正式发布全球首个面向具身智能大模型的测试时后训练框架WAM‑TTT(World-Action Model Test-Time Training
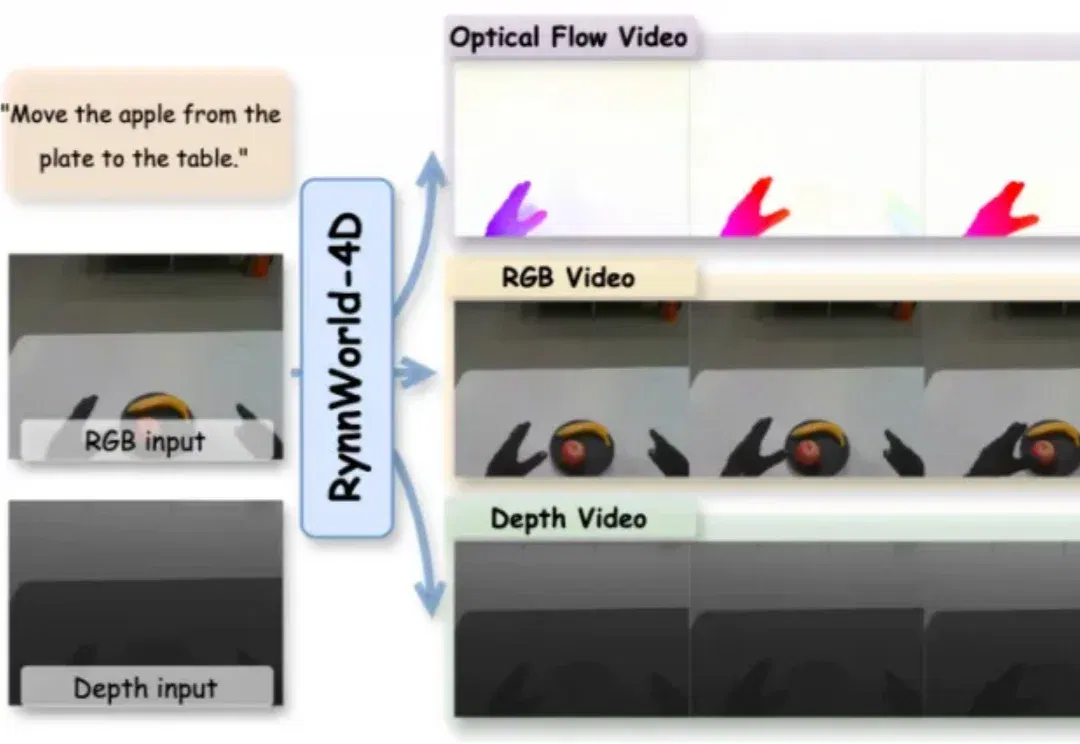
近两年,视频生成模型在具身智能领域受到持续关注。从 UniPi、SuSIE 到各类 action-conditioned video generation 变体,其核心思路一致:先由模型生成一段未来视频,再从中提取动作信号供机器人执行。
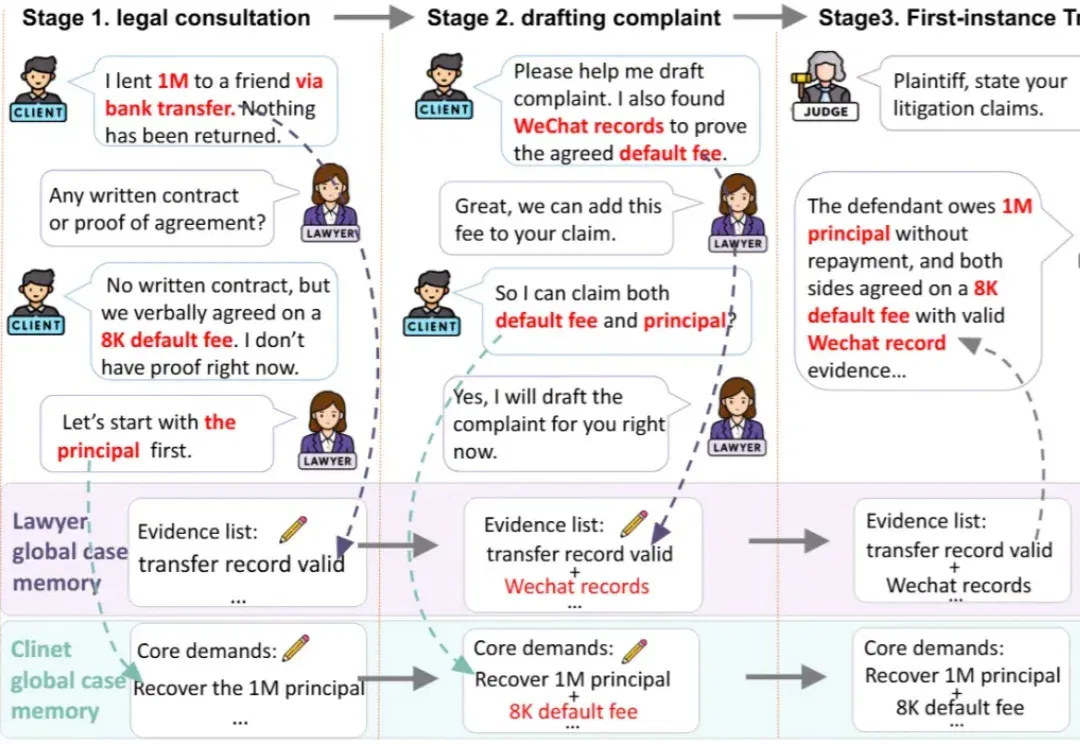
1. 引言 打官司,从来不是一问一答就能结束的事。 对当事人来说,一个案件意味着与律师的反复沟通、一轮轮文书起草,再到一审庭审、提出上诉、二审裁判,事实在积累,证据在交锋,每一步都建立在上一步之上。而对律所来说,这背后还有一整套专业运转:检测利益冲突、分配代理律师、拟定诉讼策略…… 一个案件的生命周期,远比一次问答复杂得多。而现有的模拟系统,大多还停留在单点模拟:演一次庭审、答一道法考题,答完就重置,仿佛案件没有过去,也没有未来。 LEGALWORLD 想改变这一点。 这是一个基于 LLM 智能体驱动的全生命周期交互模拟的法律环境。在这里,一个完整的中国民事实务被组织成一条连续推进的状态链,沿
Fable 5 在远程劳动力指数(Remote Labor Index,RLI)上拿到了 16.1% 的自动化率,几乎是第二名 Opus 4.8(8.3%)的两倍,更是第三名 GPT-5.5(6.3%)的 2.5 倍。