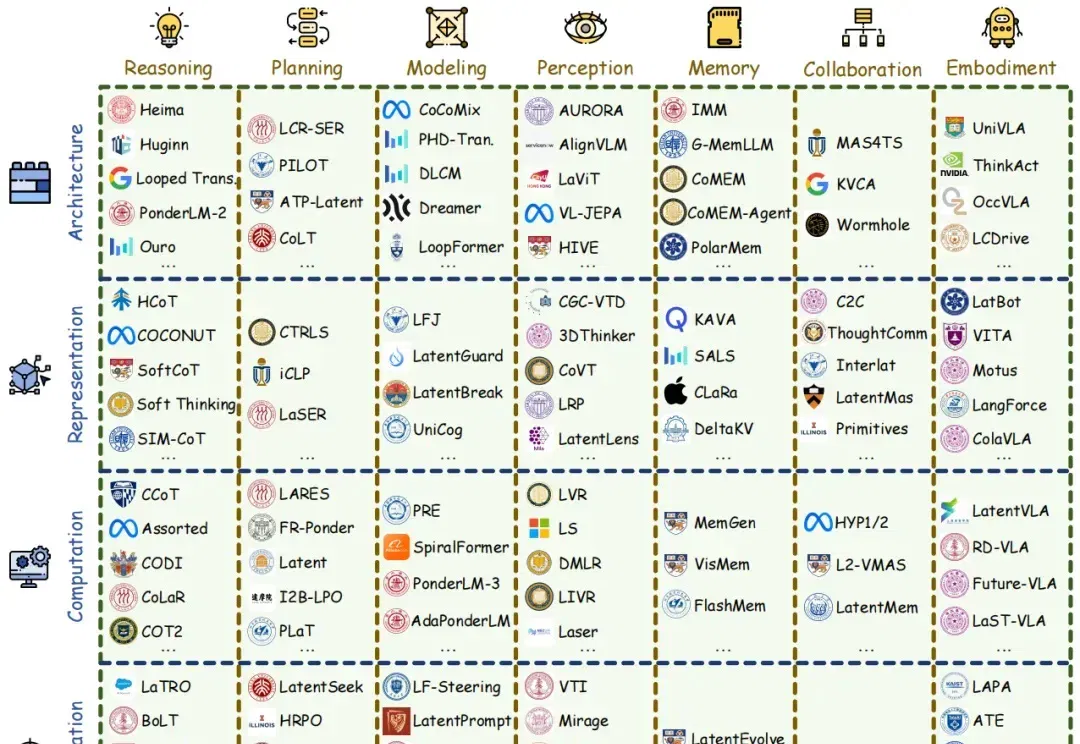
迎接范式革命:最新、最全的大模型Latent Space综述,NUS、复旦、清华等联合出品(在新窗口打开)
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
共 1517 篇
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
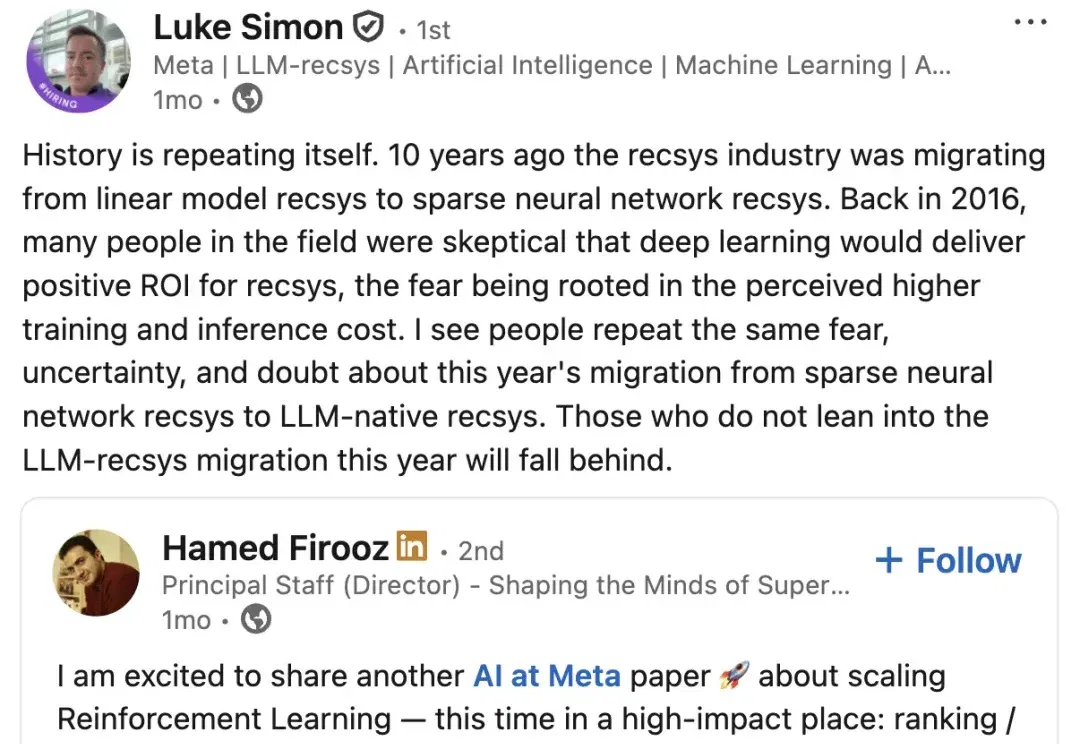
大模型(LLM)的世界知识和推理能力是实现下一代推荐系统,即基于大模型的推荐系统(LLM4Recsys)的重要基石。来自meta ai的研究者们尝试将推理模型引入再排序阶段,推荐系统的最后一环。
2026 年,阿联酋哈利法大学的邹航博士和他所在的团队,做出了全世界第一个射频大模型,名字叫 RF GPT。这个模型能直接看懂无线信号,就像 GPT 4o 能看懂图片、Qwen2 Audio 能听懂声音一样。你把无线信号扔给它,它不仅能告诉你这里面有几种信号、分别是什么技术,还能分析出有没有信号在打架、哪个是 5G 哪个是蓝牙、甚至能数出来 WiFi 网络里有多少个用户同时在用。
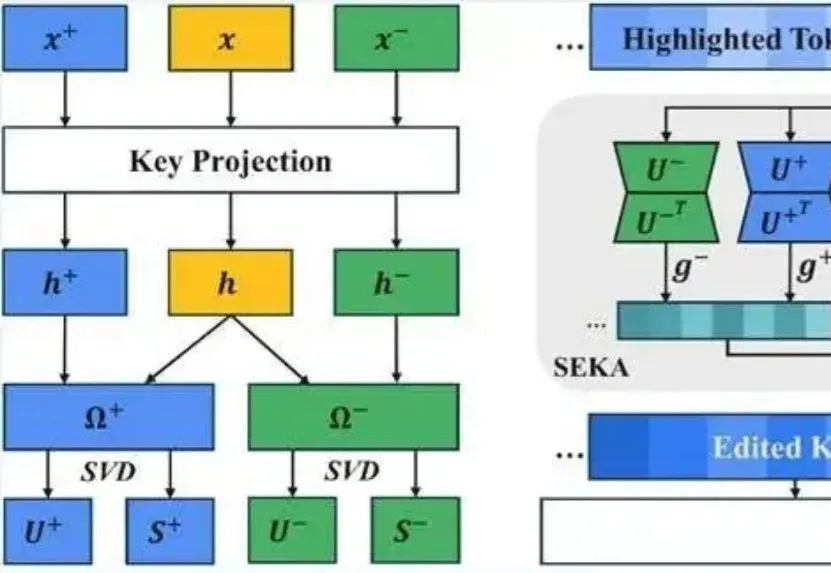
想让大模型重点关注提示词里的某句话可没那么容易。
百度再一次沦为了计量单位! 百度实习生创立4年的公司,市值正式超越百度,这可能是又一个deepseek时刻的开始。 就在3月10日,同在港股上市的MiniMax和百度悄然完成了位次调换,MiniMax的市值达到了3826亿港币,一举超过百度的3363亿。 前者近日接连暴涨,正是得益于最近火爆出圈的“全民养虾”潮,背后直接利好大模型厂商,而包括MiniMax、月之暗面和智谱AI合称“龙虾三兄弟”。 其中MiniMax专注的多模态大模型,刚好踩中了大家养虾最大的痛点,那就是token消耗太厉害成本太贵。而MiniMax直接把token价格打到0.3美元/百万token的地板价,只有国际主流模型的1
基础模型时代,大模型能力的爆发,很大程度上源于在海量文本上的预训练。然而问题在于,文本本质上只是人类对现实世界的一种抽象表达,是对真实世界信息的有损压缩。
近日, Anthropic 和斯坦福研究者 Neil Rathi 与这位传奇研究者联合发布了一篇新论文,并得到了一些相当惊人的新发现。在这项研究中,他们挑战了当前大模型安全领域的一个核心假设。长期以来,业界普遍认为要在模型发布后通过 RLHF 或微调来限制其危险行为。但 Neil Rathi 和 Alec Radford 提出了一种更本质的解法:
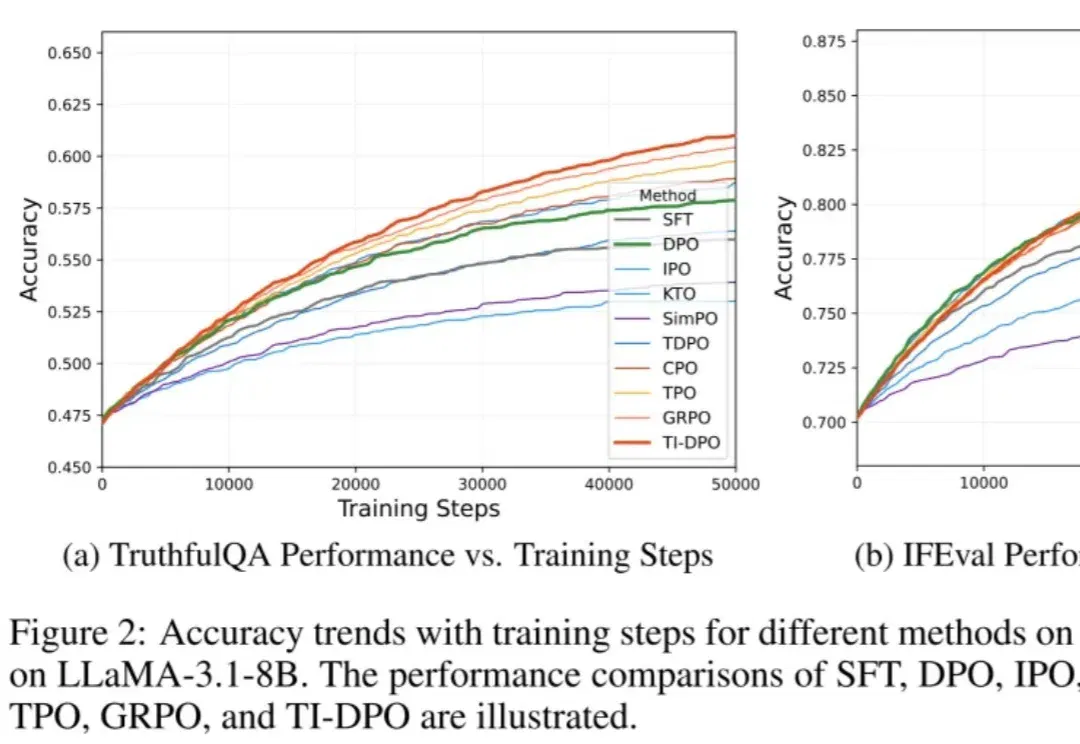
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
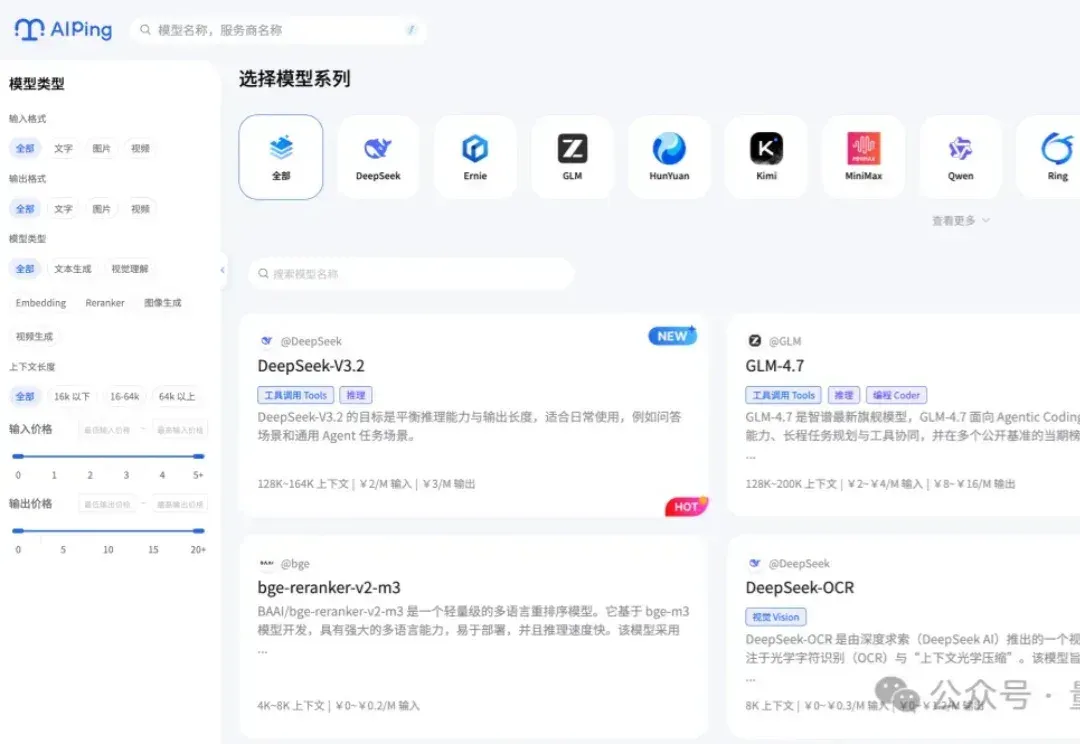
忍不了了,这个槽我真的不吐不快! 比面对大模型黑盒更让人抓瞎的事情,就是要去选既靠谱、性价比又高的API服务。 这几乎是每一个涉足AI应用开发的团队都会经历的至暗时刻,抹泪.gif。 同一个模型架构在不同的供应商手里,不仅价格上有出入,延迟、稳定性、吞吐量等用户关心的指标,波动幅度简直堪比霸天虎过山车。 你说荒诞不,在API调用动辄几十万、上百万token的时代,API选型居然变成了一件靠经验反复试错的事儿。 这就导致想要接个API做开发,还得先被迫兼职下采购员。东市买骏马,西市买鞍鞯,必须把市面上的供应商挨个测一遍。 (写到这儿的时候,我的表情就是那个大家可以想象的痛苦面具闭眼表情包.jpg
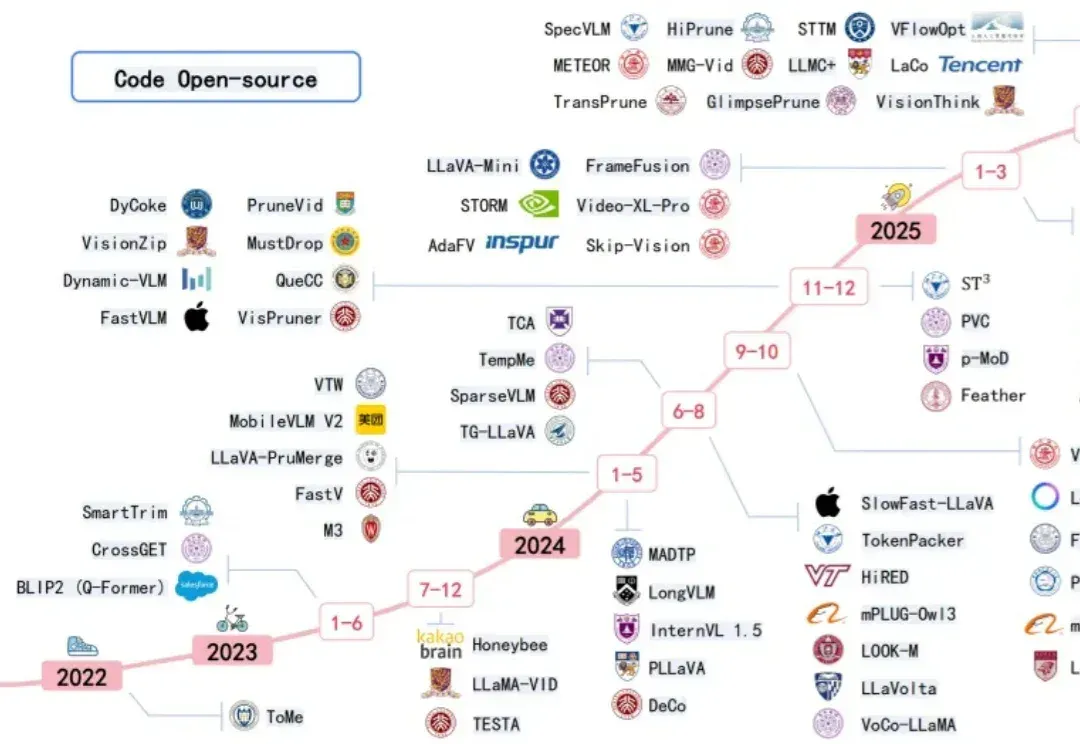
近年来多模态大模型在视觉感知,长视频问答等方面涌现出了强劲的性能,但是这种跨模态融合也带来了巨大的计算成本。高分辨率图像和长视频会产生成千上万个视觉 token ,带来极高的显存占用和延迟,限制了模型的可扩展性和本地部署。