
刚刚,DeepSeek V4.1 Flash正式上线!已适配Harness(在新窗口打开)
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
共 438 篇
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
图形学宗师童欣正式加盟胡渊鸣创办的AI 3D公司Meshy出任首席科学家,将负责制定长期科研战略,与胡渊鸣共同推进多模态世界模型与实时交互系统突破,朝着"AI for Fun"的愿景迈进。
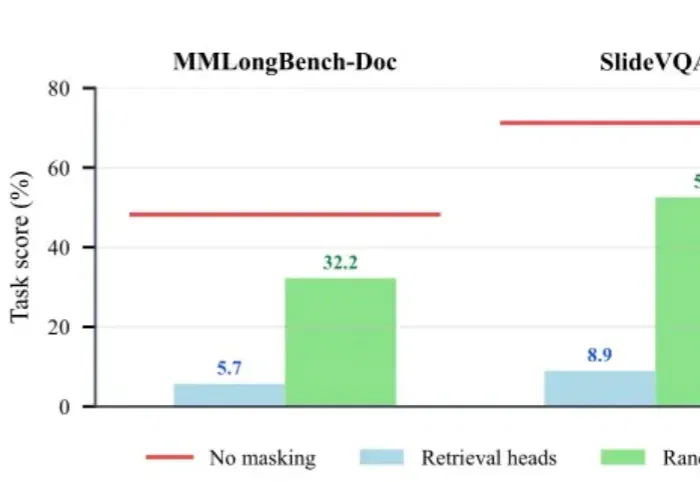
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
AI制药公司Owkin与勃林格殷格翰达成许可协议,将人工智能科学家K Pro及多模态患者数据用于肿瘤学和免疫学多个适应症的药物发现,K Pro已将Owkin内部药物靶点识别速度提升70%。
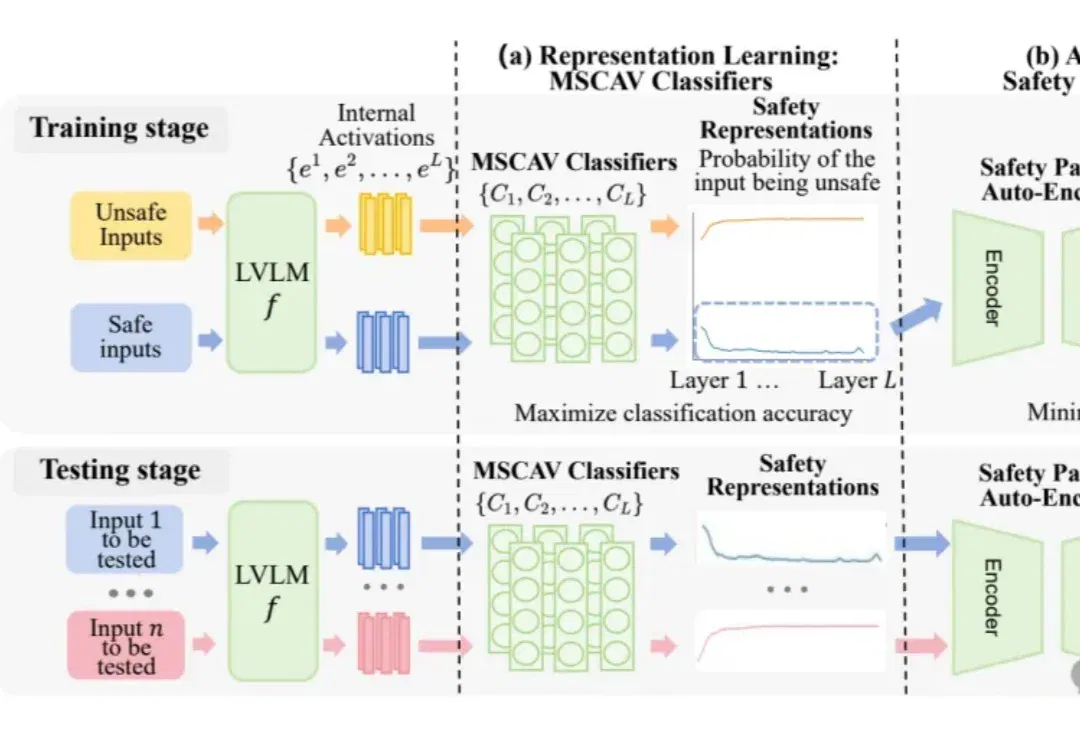
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
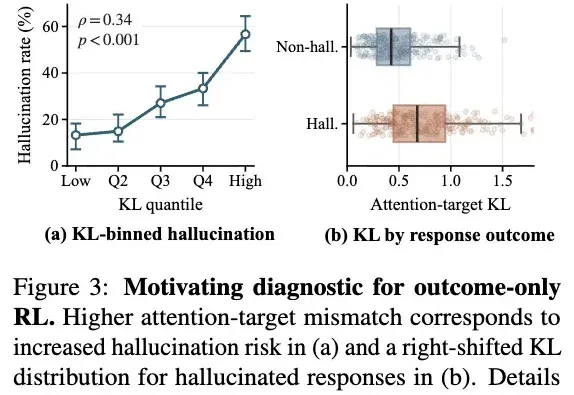
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
这几天 ox-alpha 用爽了吧...正如很多人猜的那样,这个模型来自智谱,正式名称为 glm-5.3-flash,支持多模态,但很多人没猜到的是:这个乱杀的模型只有 321B,且与 glm-5.3 不同,是完全的新架构
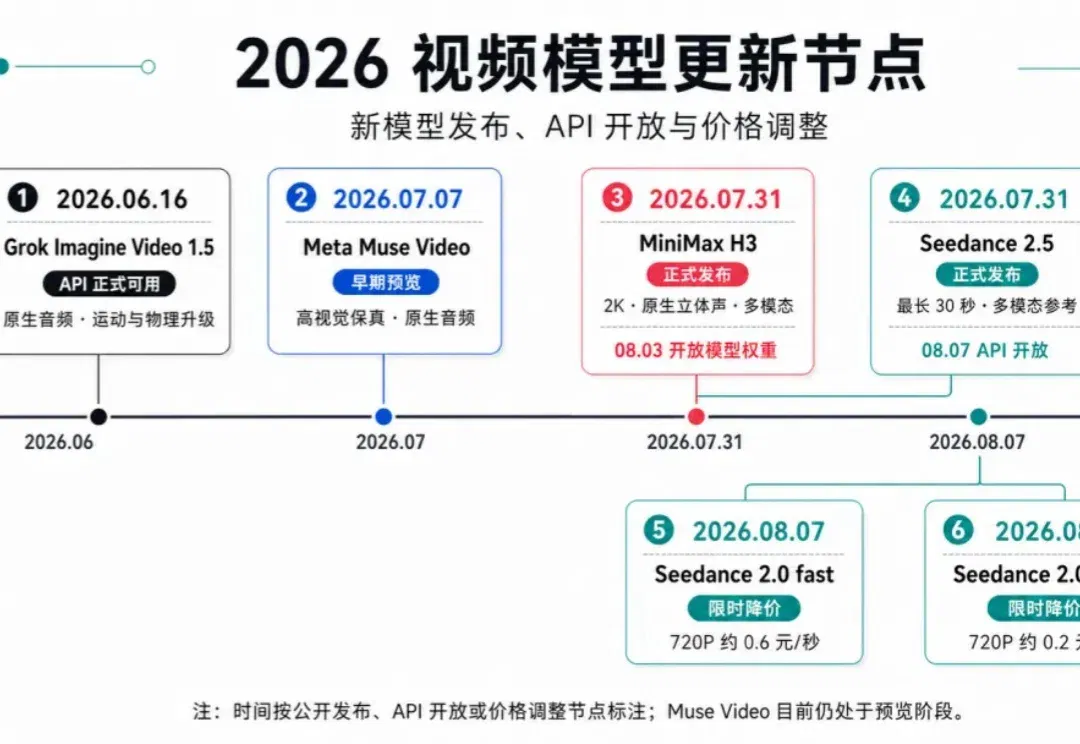
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 友友们,最近的视频模型更新得有点凶。 字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。 当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。 模型越多,普通创作者越
“这些人在往哪跑?为什么跑” “大模型浪潮狂飙三年半,国内AI人才也经历了三波大迁移。”资深科技猎头赵捷告诉雷峰网。 前两年,大家抢的是预训练人才,先是百度文心团队被疯抢,然后是AI六小虎人才遭遇瓜分,紧接着又是阿里、DeepSeek、字节、腾讯之间的人才大混战。 而现在,大家又开始抢推理、Agent等后训练人才;最近一年不少预训练人才,如Qwen Code负责人惠彬原、混元大语言模型预训练负责人姚星丞、混元多模态理解预训练负责人彭厚文,字节Seed核心专家顾全全等陆续离职,要么创业,要么流向更纯粹的AI研究团队。 是什么促成了这一轮轮AI人才大迁徙?这背后又藏着哪些AI行业更深层的逻辑转变?