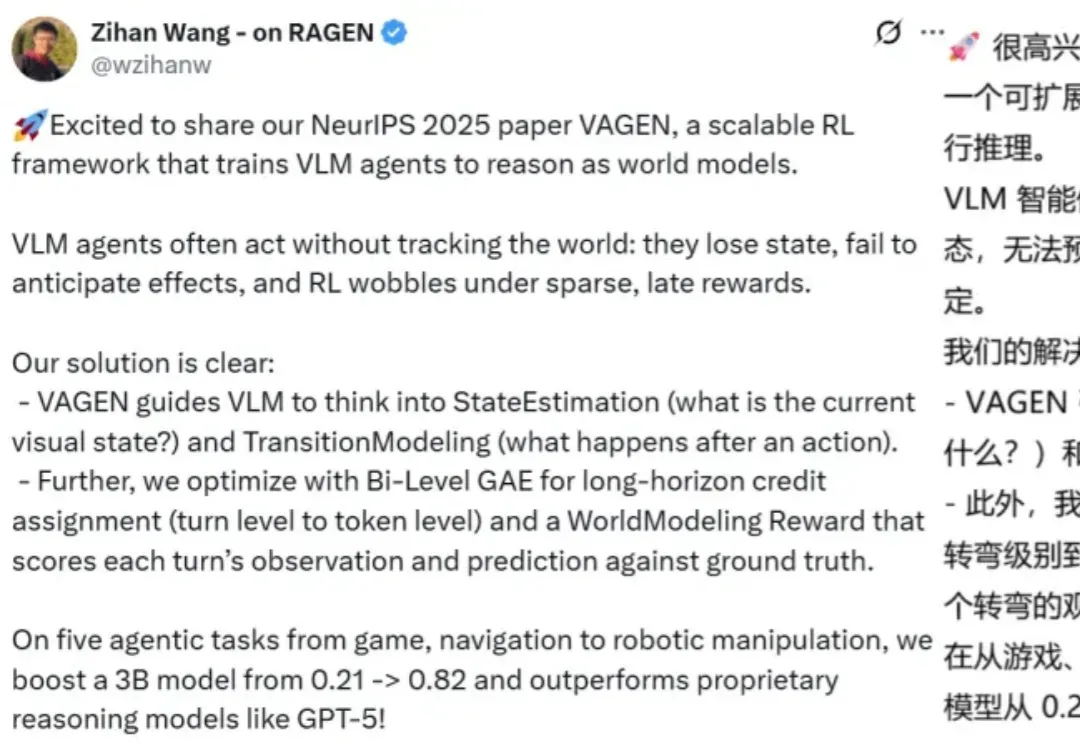
让VLM学会「心中有世界」:VAGEN用多轮RL把视觉智能变成「世界模型」推理机器(在新窗口打开)
当今的 AI 智能体(Agent)越来越强大,尤其是像 VLM(视觉-语言模型)这样能「看懂」世界的智能体。但研究者发现一个大问题:相比于只处理文本的 LLM 智能体,VLM 智能体在面对复杂的视觉任务时,常常表现得像一个「莽撞的执行者」,而不是一个「深思熟虑的思考者」。
共 388 篇
当今的 AI 智能体(Agent)越来越强大,尤其是像 VLM(视觉-语言模型)这样能「看懂」世界的智能体。但研究者发现一个大问题:相比于只处理文本的 LLM 智能体,VLM 智能体在面对复杂的视觉任务时,常常表现得像一个「莽撞的执行者」,而不是一个「深思熟虑的思考者」。
Alaya Lab推出反事实社会模拟产品合成世界Synthetic World,用户可改变故事中的关键事实进入平行时间线,观察AI居民持续互动、建立关系并自主推动剧情演化,目前平台已积累数百个世界、万级居民和近两万条社区动态。
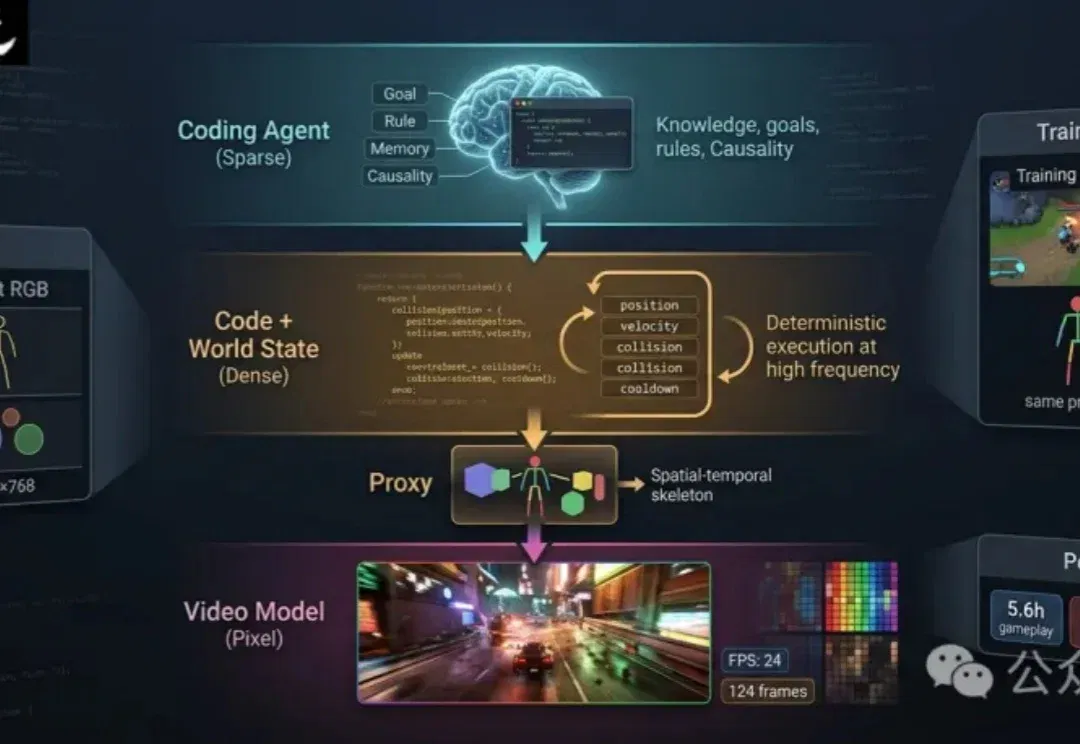
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
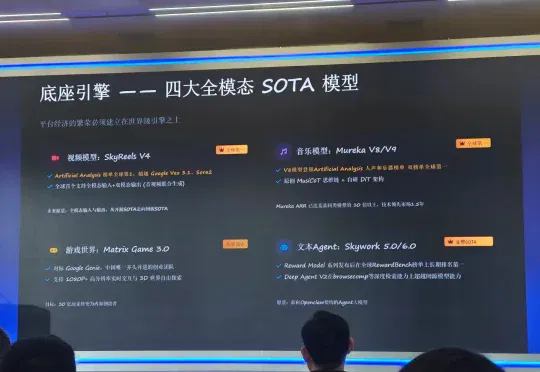
在会上,昆仑万维旗下天工 AI 重磅发布了全新 AI 游戏世界模型 Matrix-Game 3.0、AI 视频大模型 SkyReels V4 和 AI 音乐大模型 Mureka V9,在继续强化 AIGC 理解与生成能力的同时,进一步推进 AI 对物理世界的建模与仿真。
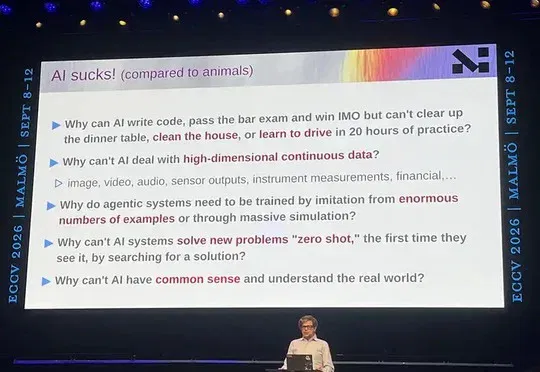
图灵奖得主Yann LeCun在ECCV 2026发表Keynote演讲,论证"预测像素"是伪命题,阐述JEPA在抽象表征空间预测世界的机制,并建议研究者放弃生成式模型与大语言模型,转向联合嵌入架构与世界模型以实现人类水平智能。
就在这一背景下,银河通用联合清华北大英伟达等众多机构联合发布了跨本体「隐式世界-动作基础模型」LDA-1B,将目光投向了具身智能 Scaling Law 的这个终极命题:如何让模型有效利用互联网规模的异构数据。
自 Sora 亮相以来,AI 视频的真实感突飞猛进,但可控性仍是瓶颈:模型像才华横溢却随性的摄影师,难以精准执行 “导演指令”。我们能否让 AI 做到: 仅凭一张静态照片,就能 “脑补” 出整个 3D
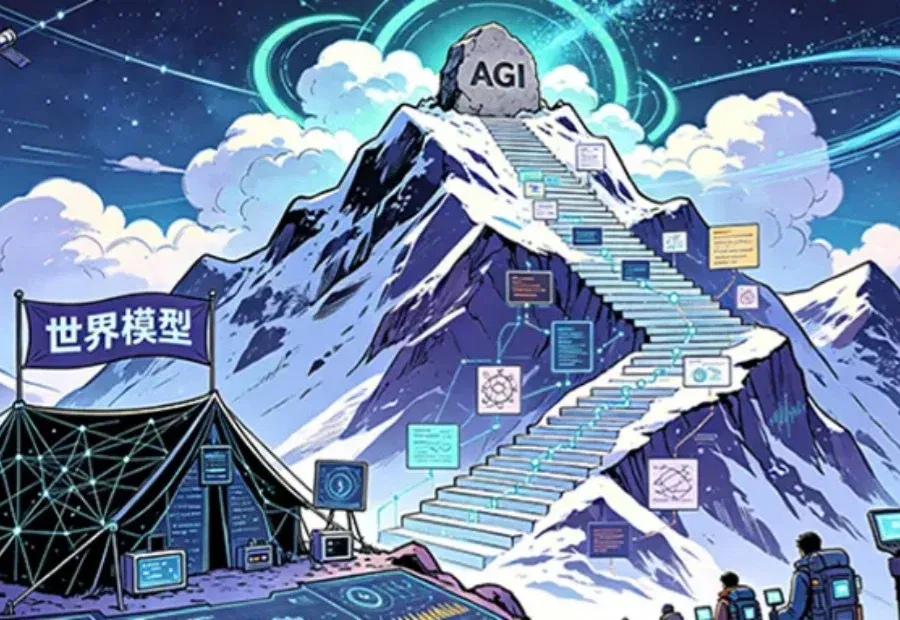
中国AGI两条上山路径:一条让机器理解、运用语言,另一条让机器认知、推演并改造世界,二者终会交汇。
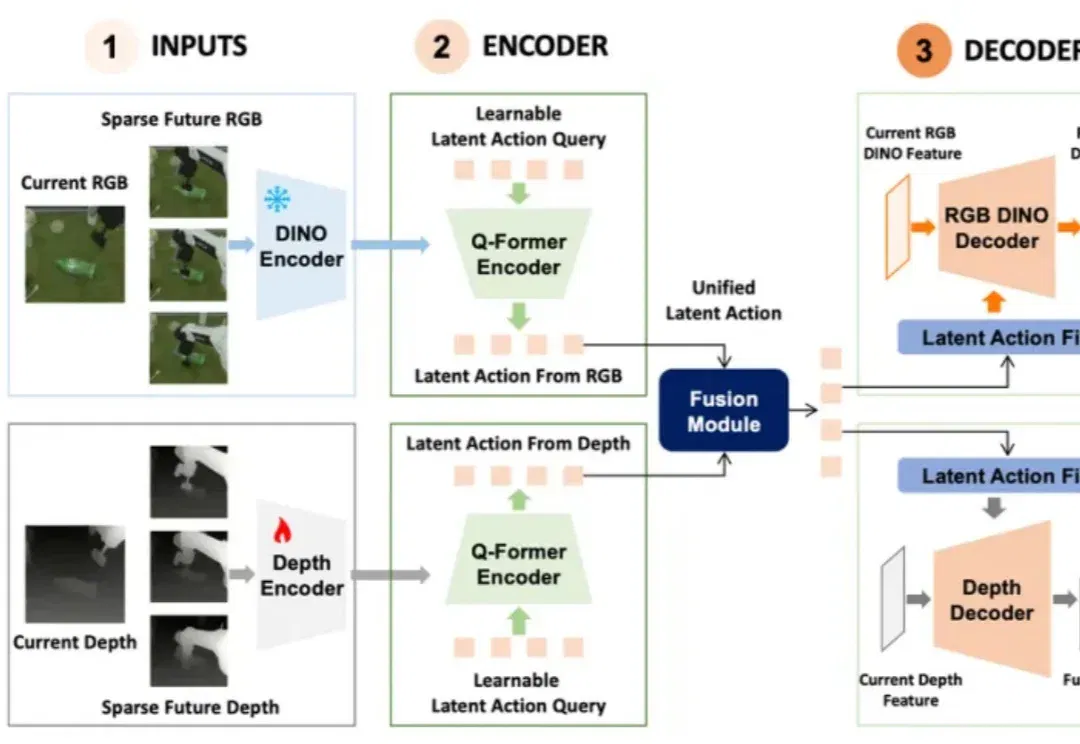
当前,物理 AI 正面临着关于泛化能力的普遍质疑。当模型缺乏对真实物理规律的深度认知、难以跨越复杂多变的开放场景时,如何让机器人真正理解物理世界并精准规划决策,已成为具身智能破局的关键。
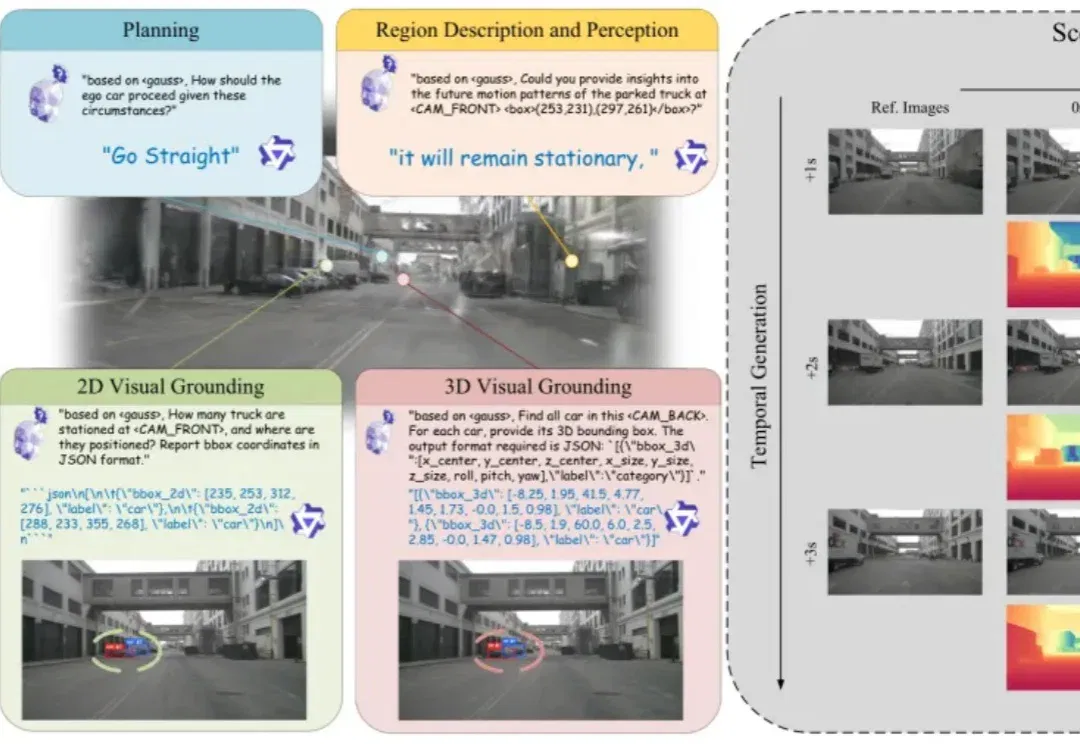
自动驾驶世界模型的研究目标已经从单纯预测未来视觉帧,扩展到构建可用于场景理解、空间定位和后续决策的世界表示。如果模型只能生成外观上合理的未来图像,却无法回答场景中有哪些目标、目标位于何处,以及不同视角下的空间结构如何变化,那么它仍然缺少对三维驾驶环境的显式建模能力。