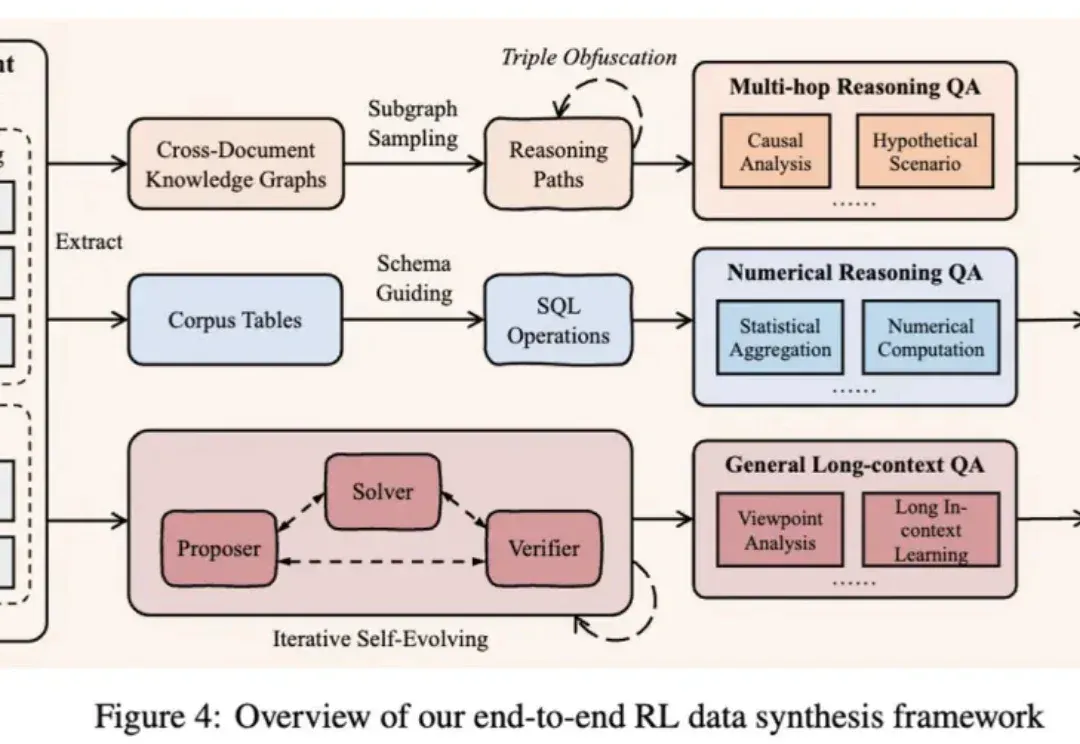
QwenLong-L1.5发布:一套配方,三大法宝,让30B MoE模型长文本推理能力媲美GPT-5(在新窗口打开)
作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?
共 219 篇
作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?
我真栓Q了!围观了场狼人杀,看得我汗流浃背……
AI不仅会做PPT,写代码,它还能理解更深层次的问题。在美国的一项偏重于文化领域的新基准测试中,中国开源模型Qwen3夺冠,DeepSeek的R1跻身前六,力压多家全球顶级的明星模型。
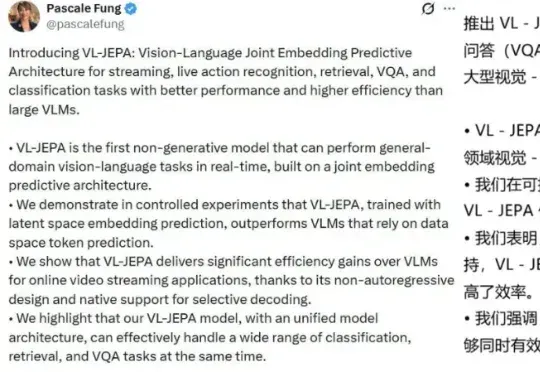
近日,来自 Meta、香港科技大学、索邦大学、纽约大学的一个联合团队基于 JEPA 打造了一个视觉-语言模型:VL-JEPA。据作者 Pascale Fung 介绍,VL-JEPA 是第一个基于联合嵌入预测架构,能够实时执行通用领域视觉-语言任务的非生成模型。
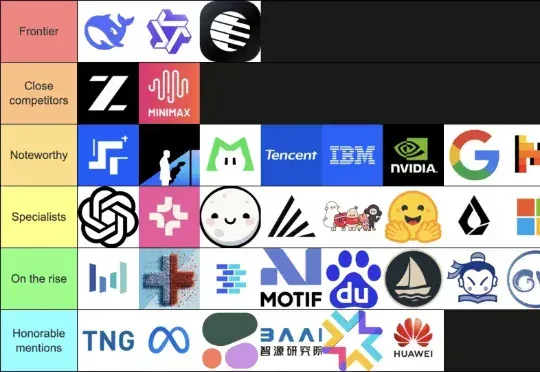
最近几天,一张开源模型的等级列表在 X 上被疯狂转载。 从夯到拉,国产开源模型排在了数一数二的位置,DeepSeek、Qwen、Kimi、智谱、还有 MiniMax 是全球开源模型的前五名。
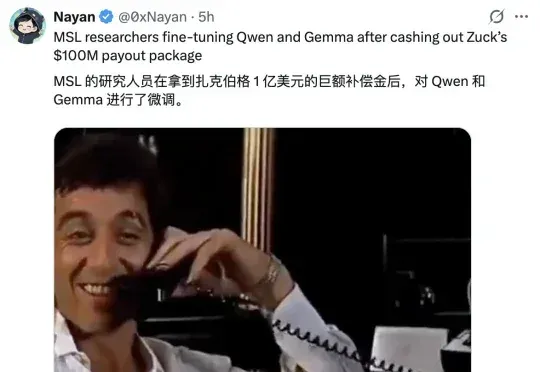
Meta的开源时代,要结束了。彭博社爆料,明年春季,Meta将发布一款代号为「Avocado(牛油果)」的模型。而这款新模型,很可能是「闭源」的。但如果仅仅是闭源,还不至于如此引人注目。真正让市场炸裂的是另一条更劲爆的消息:这款闭源模型,竟然在训练过程中使用了阿里巴巴的AI。
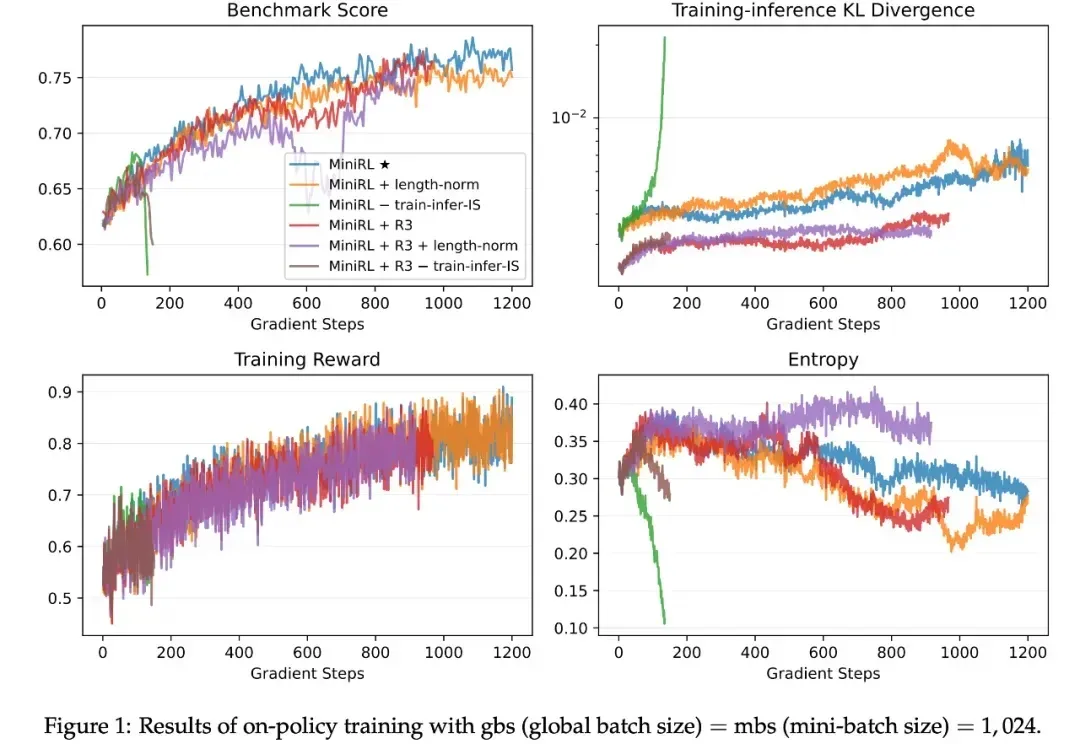
如今,强化学习(RL)已成为提升大语言模型(LLM)复杂推理与解题能力的关键技术范式,而稳定的训练过程对于成功扩展 RL 至关重要。由于语言具有强烈的上下文属性,LLM 的 RL 通常依赖序列级奖励 —— 即根据完整生成序列给一个标量分数。
刚刚,NeurIPS 2025最佳论文奖、时间检验奖出炉!
2025 年,AIGC 热度再冲新高:从社交头像、电商海报到影视分镜,AI 生成内容已全面渗透日常创作。在这股浪潮中,Nano Banana、Qwen Edit 等通用图像编辑大模型功能强大,涵盖了广泛的图像编辑场景。特别是最新爆火的 Nano Banana Pro 能将文字指令转化为高精度图像,精准呈现复杂场景。但是上述图像编辑大模型在一些细分领域的表现仍有不足,并且用于简单任务性价比不高。
在过去五年,AI领域一直被一条“铁律”所支配,Scaling Law(扩展定律)。它如同计算领域的摩尔定律一般,简单、粗暴、却魔力无穷:投入更多的数据、更多的参数、更多的算力,模型的性能就会线性且可预测地增长。无数的团队,无论是开源巨头还是商业实验室,都将希望孤注一掷地押在了这条唯一的救命稻草上。