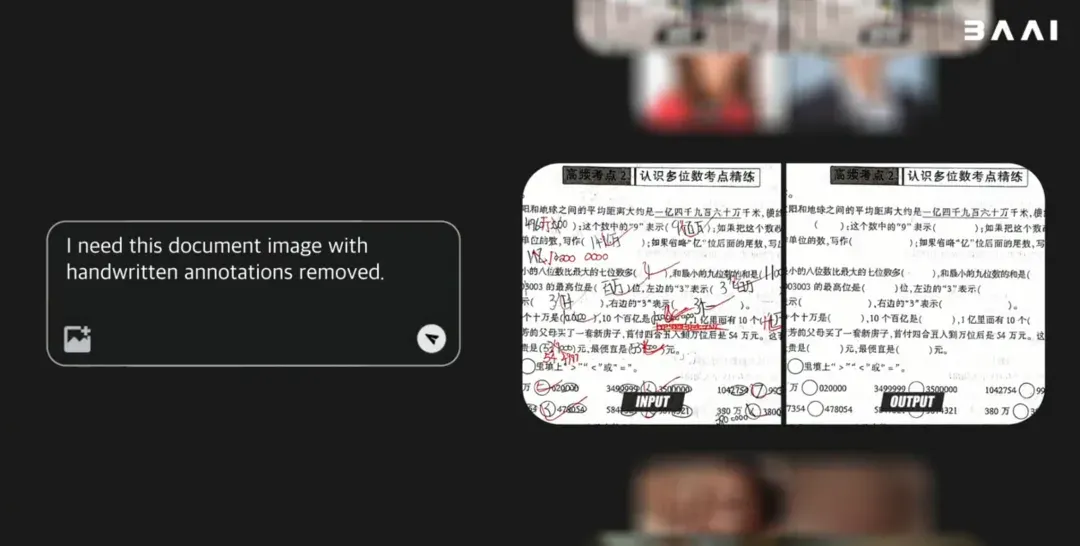
世界模型有了开源基座Emu3.5!拿下多模态SOTA,性能超越Nano Banana(在新窗口打开)
最新最强的开源原生多模态世界模型—— 北京智源人工智能研究院(BAAI)的悟界·Emu3.5来炸场了。 图、文、视频任务一网打尽,不仅能画图改图,还能生成图文教程,视频任务更是增加了物理真实性。
共 388 篇
最新最强的开源原生多模态世界模型—— 北京智源人工智能研究院(BAAI)的悟界·Emu3.5来炸场了。 图、文、视频任务一网打尽,不仅能画图改图,还能生成图文教程,视频任务更是增加了物理真实性。
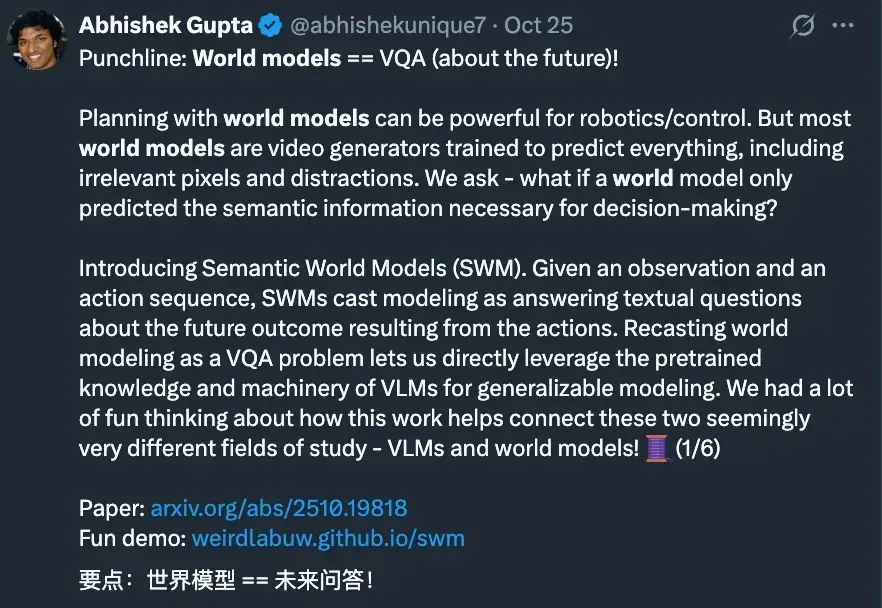
对于机器人来说,世界模型真的有必要想象出精确的未来画面吗?在一篇新论文中,来自华盛顿大学、索尼 AI 的研究者提出了这个疑问。
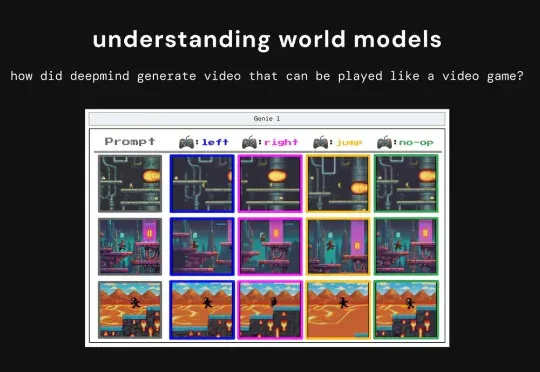
最近,X 博主 anandmaj 在一个月内复刻 Genie 3 的核心思想,开发出了 TinyWorlds,一个仅 300 万参数的世界模型,能够实时生成可玩的像素风格环境,包括 Pong、Sonic、Zelda 和 Doom。
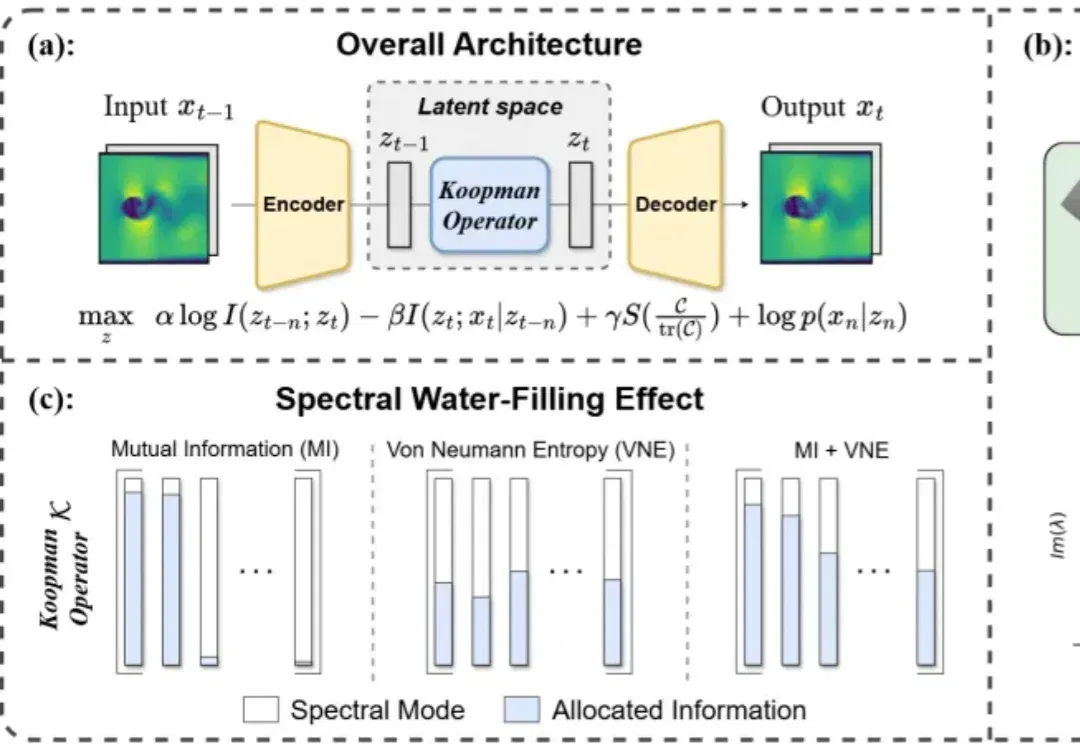
大多数世界模型工作默认:只要学到一个好的 latent dynamics,问题就解决了。 但这个假设本身是可疑的——什么样的信息,才足以支撑一个可预测、可传播的动力学? 本文从信息论出发,重新审视这一前提。
智源研究院悟界·RoboBrain Orca Team发布的技术报告Orca: The World is in Your Mind,想探索的正是这个问题。也有评论认为,Orca更接近早期通用世界模型的形态,即先学习世界如何变化,再将这种世界表征读出到理解、预测和行动任务中。
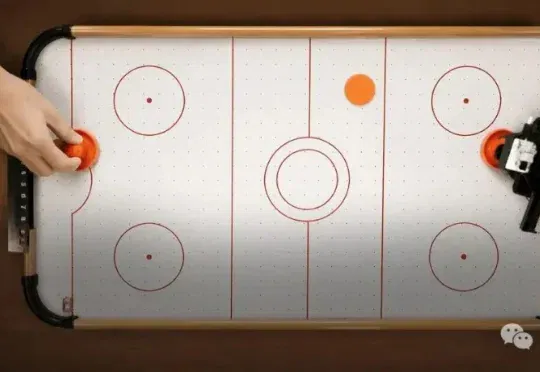
蚂蚁集团旗下具身智能公司蚂蚁灵波,把这块最难的拼图拍上了桌:LingBot-VA 2.0——行业第一个具身原生预训练模型。所谓「具身原生」,一句话说清楚:不是拿现成的数字世界模型做嫁接,而是从数据、训练目标到模型架构,每一层都为「机器人在物理世界干活」而生—
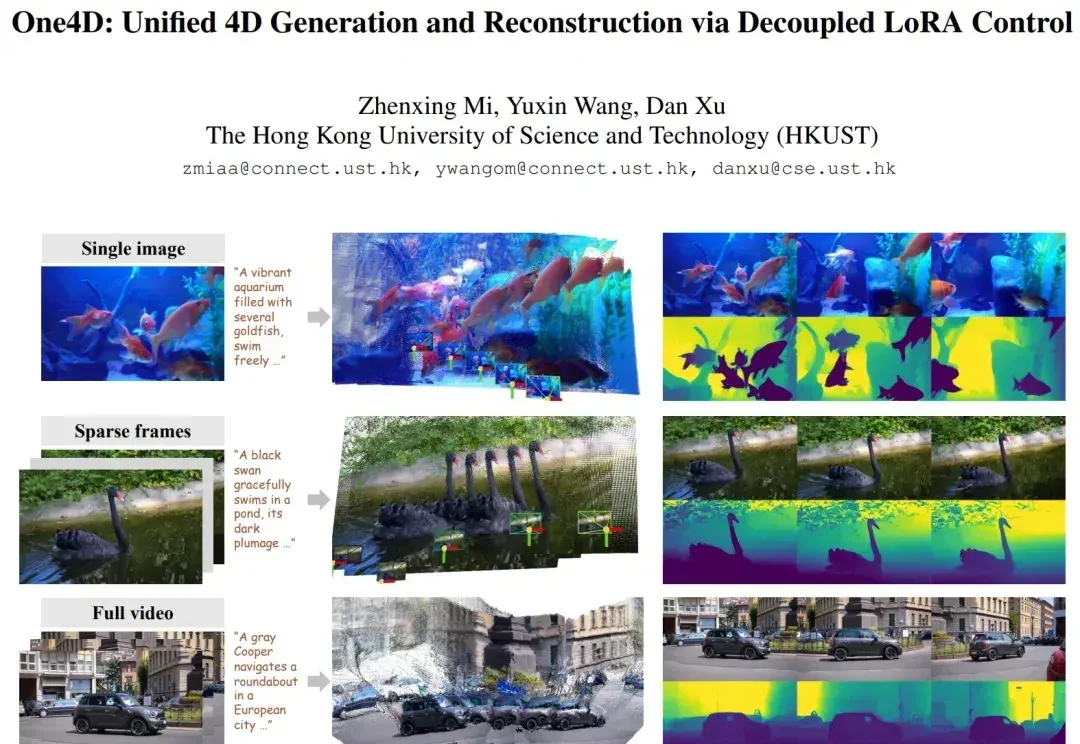
近年来,视频扩散模型在 “真实感、动态性、可控性” 上进展飞快,但它们大多仍停留在纯 RGB 空间。模型能生成好看的视频,却缺少对三维几何的显式建模。这让许多世界模型(world model)导向的应用(空间推理、具身智能、机器人、自动驾驶仿真等)难以落地,因为这些任务不仅需要像素,还需要完整地模拟 4D 世界。
今天,北京智源人工智能研究院(BAAI)重磅发布了其多模态系列模型的最新力作 —— 悟界・Emu3.5。这不仅仅是一次常规的模型迭代,Emu3.5 被定义为一个 “多模态世界大模型”(Multimodal World Foudation Model)。
刚刚,BeingBeyond智在无界发布首个基于人类视频数据的隐式触觉世界动作模型—— Being-H0.8。
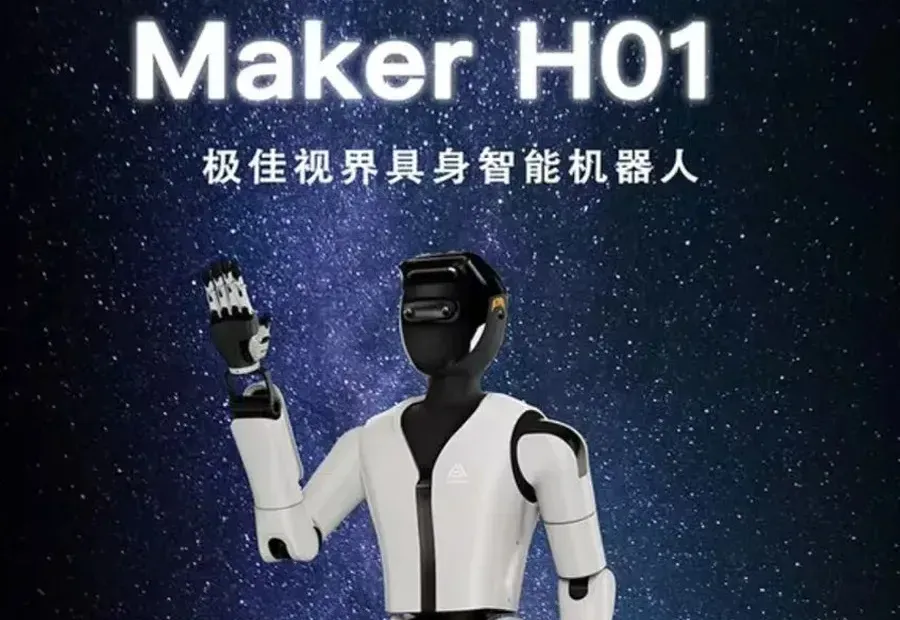
目标物理世界的“ChatGPT时刻”。 距上一轮融资发布仅一个月,具身智能公司「极佳视界」近日再获新一轮投资。 据悉,本轮为2亿元A2轮融资,由达晨财智领投,老股东华控基金联合领投,首发展创投、浦耀信晔、财鑫资本、珠海科技产业集团、张科垚坤、复琢创投等知名机构跟投,老股东合鼎共资本超额跟投。 此前,极佳视界已分别完成Pre-A、Pre-A+、A1连续三轮融资,3个月内连续完成4轮累计5亿元A轮系列融资。 作为一家专注物理世界通用智能的公司,极佳视界不仅面向物理AGI的目标推出原生模型,也已于2025年11月26日发布相应本体,布局物理AGI的终端业务。 具体而言,公司产品包括世界模型平台Gig