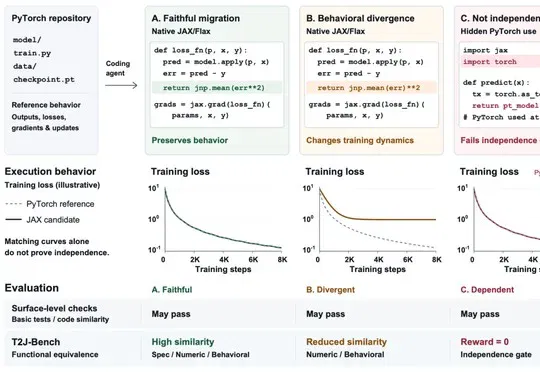
整仓迁移交给Coding Agent,训练与推理行为还能对齐吗?谷歌团队发布T2J-Bench(在新窗口打开)
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
共 57 篇
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
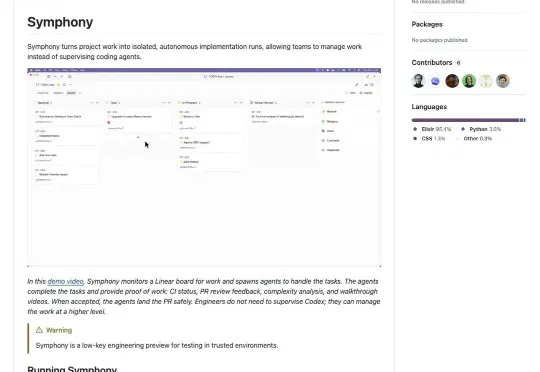
OpenAI工程师公开发帖承认:哪怕用的是Codex,一个人能有效监督的coding agent也就3到5个,再多生产率直接往下掉。更劲爆的是,OpenAI没有选择"让人盯更多屏幕",而是直接开源了Symphony——一套把人类从"实时盯盘"解放成"异步验收"的全新工作流系统。近40万人围观,近3000人收藏。
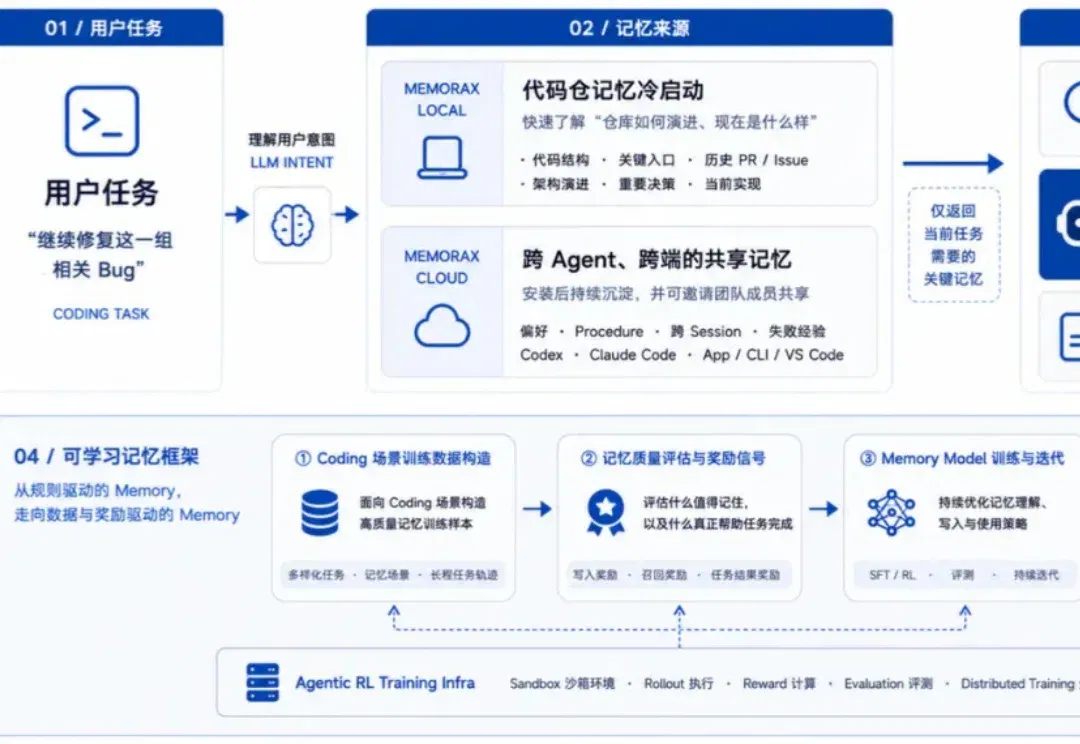
过去一年,Coding Agent 正在迅速改变开发者写代码的方式。
今天,智谱发布了一篇名为《Scaling Pain:超大规模Coding Agent推理实践》的技术报告,披露了GLM-5系列模型在Coding Agent场景下遇到的推理基础设施挑战与对应解法。
乐鑫信息科技 (688018.SH) 正式推出 ESP-Mosaico,一款为 Coding Agent(代码智能体)设计的模块化开发板,支持多机拼接。面对不断变化的应用需求,创作者无需受限于固定的硬件形态,可以按需组合不同的硬件能力,并借助 Agent 持续开发和完善,让硬件形态与应用能力能够随产品需求不断扩展。
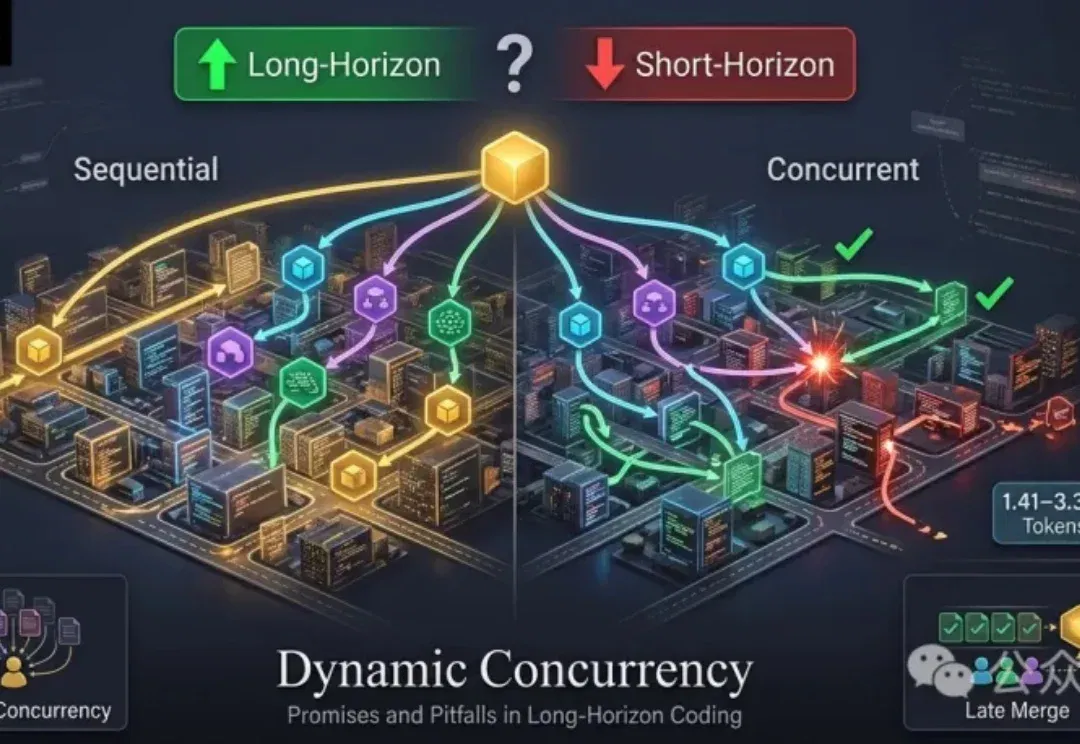
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
在本文中,我将探讨编码智能体(coding agents)及其智能体编排(agent harnesses)的整体设计:它们究竟是什么、工作原理如何,以及在实际应用中各组件是如何协同运作的。
在这篇文章里,我想介绍编码智能体(Coding agents)以及 Agent harnesses 的整体设计:它们是什么、怎么运作,以及各个零件在实践中怎么拼到一起。
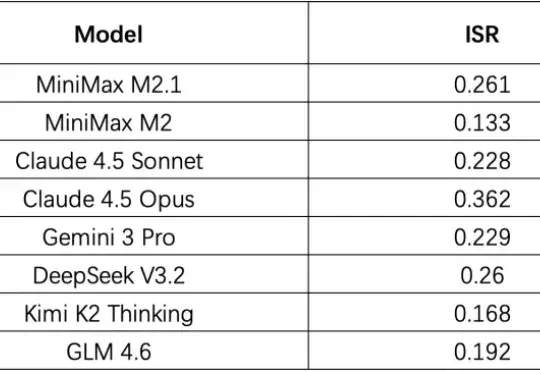
我们对 Coding Agent 的评测,可能搞错了方向。 一个反复出现,但常常被忽略的现象是:用户对 Agent 的不满,往往不是因为它「做不到」,而是因为它「做得不好」。 「做得不好」集中表现在: