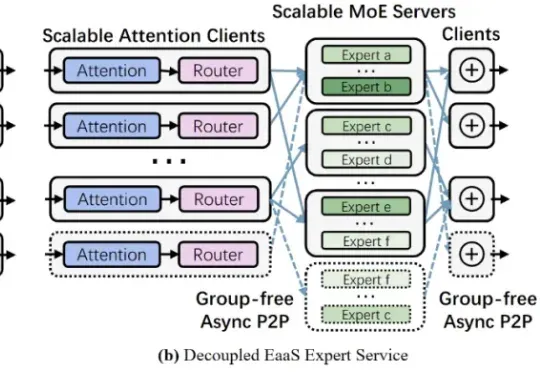
为MoE解绑:全新「专家即服务」推理架构发布,超细粒度扩展锐减37.5%成本(在新窗口打开)
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
共 12 篇
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
大模型在科研领域越来越高效了。 昨天,谷歌发表了一篇重磅文章,提出了一个能够帮助科研人员编写「专家级」科研软件的 AI 系统。 该系统融合了大语言模型和传统树搜索,能够自动编写和优化科研任务中所需的软件程序,能够获取多种渠道的现有知识,整合并且重组这些知识来构建一个新的研究思路。 谷歌生成,该系统不仅稳定达到专家水平,还常常超越人类。在基因组学、公共健康、数值分析等多个领域,这套系统的表现甚至超过了顶尖研究团队和国家级集成系统。 论文标题:An AI system to help scientists write expert-level empirical software论文链接:http