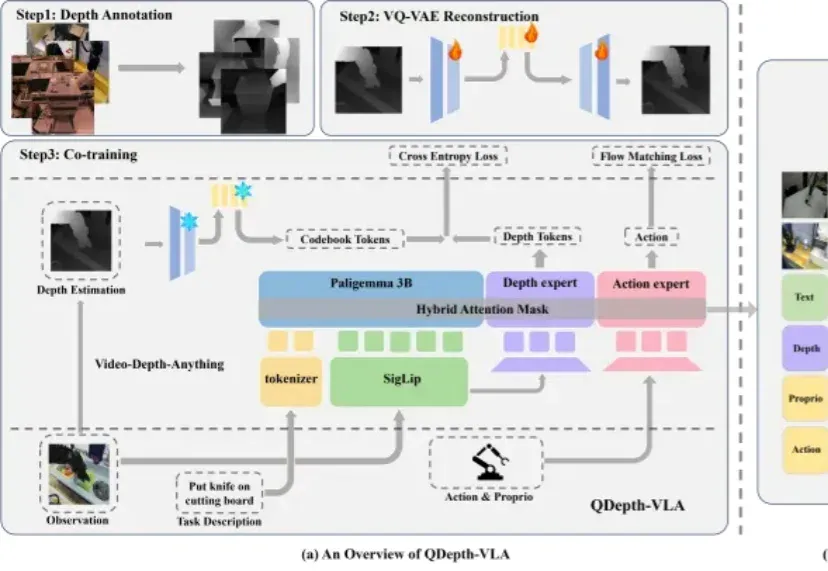
突破视觉-语言-动作模型的瓶颈:QDepth-VLA让机器人拥有更精准的3D空间感知(在新窗口打开)
视觉-语言-动作模型(VLA)在机器人操控领域展现出巨大潜力。通过赋予预训练视觉-语言模型(VLM)动作生成能力,机器人能够理解自然语言指令并在多样化场景中展现出强大的泛化能力。然而,这类模型在应对长时序或精细操作任务时,仍然存在性能下降的现象。
共 68 篇
视觉-语言-动作模型(VLA)在机器人操控领域展现出巨大潜力。通过赋予预训练视觉-语言模型(VLM)动作生成能力,机器人能够理解自然语言指令并在多样化场景中展现出强大的泛化能力。然而,这类模型在应对长时序或精细操作任务时,仍然存在性能下降的现象。
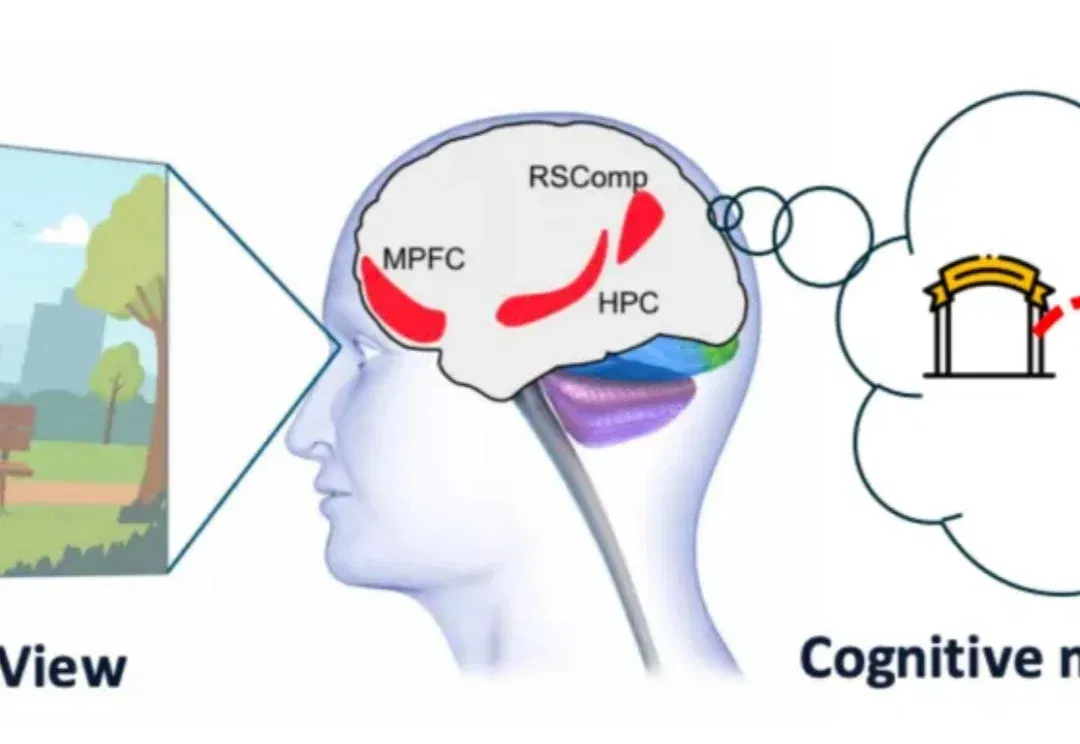
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
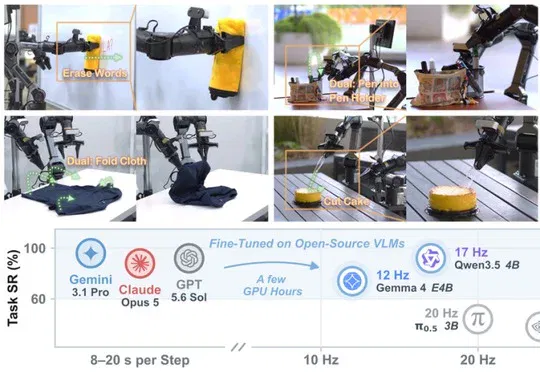
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
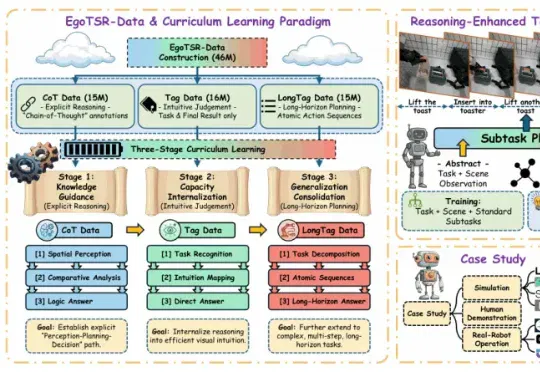
浙江大学等五所高校的研究团队提出 EgoTSR。研究从第一人称机器人视角出发,希望让 VLM 学会判断任务状态,并把这种能力进一步扩展到长程规划。团队构建了包含 4600 万条样本的 EgoTSR-Data,并设计了三阶段课程学习流程。
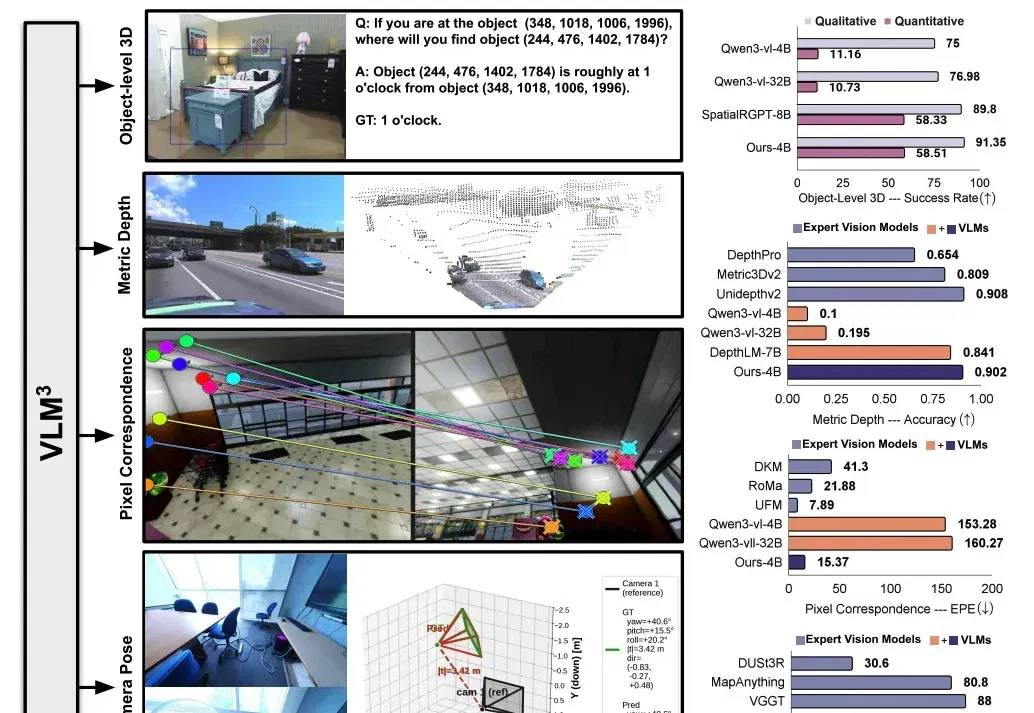
Meta 发布了一项令人震撼的研究工作 VLM³,首次揭示了三维视觉学习的 Bitter Lesson:标准的视觉语言模型 + scale 数据就是最简单有效的范式,针对特定任务的架构、损失函数以及数据增强的设计,甚至是 regression 的 formulation,均不是三维视觉学习的必要条件。
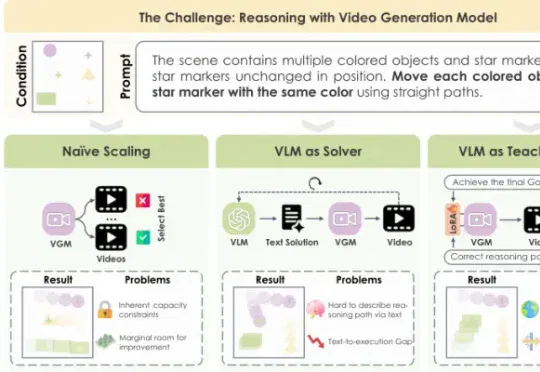
怎么让VGM学会按规则推理?过去主要有两条路。两条路,一个不动模型,一个只写文字,都没真正解决“执行”问题。为此,城大×快手可灵提出了第三条路:VLM-as-Teacher。
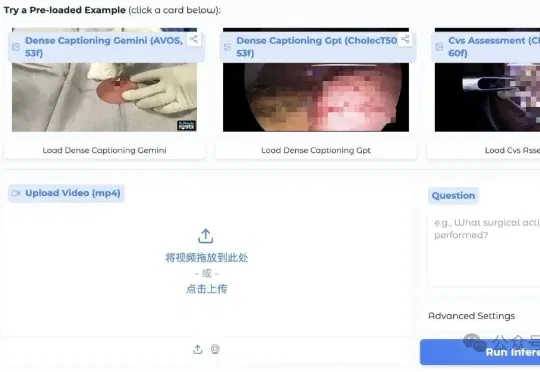
就在这两天,GitHub和Hugging Face社区上线了一枚医疗大模型领域的“核弹”。全球规模最大、性能最强的医疗视频理解大模型——uAI Nexus MedVLM(中文名:元智医疗视频理解大模型)开源!
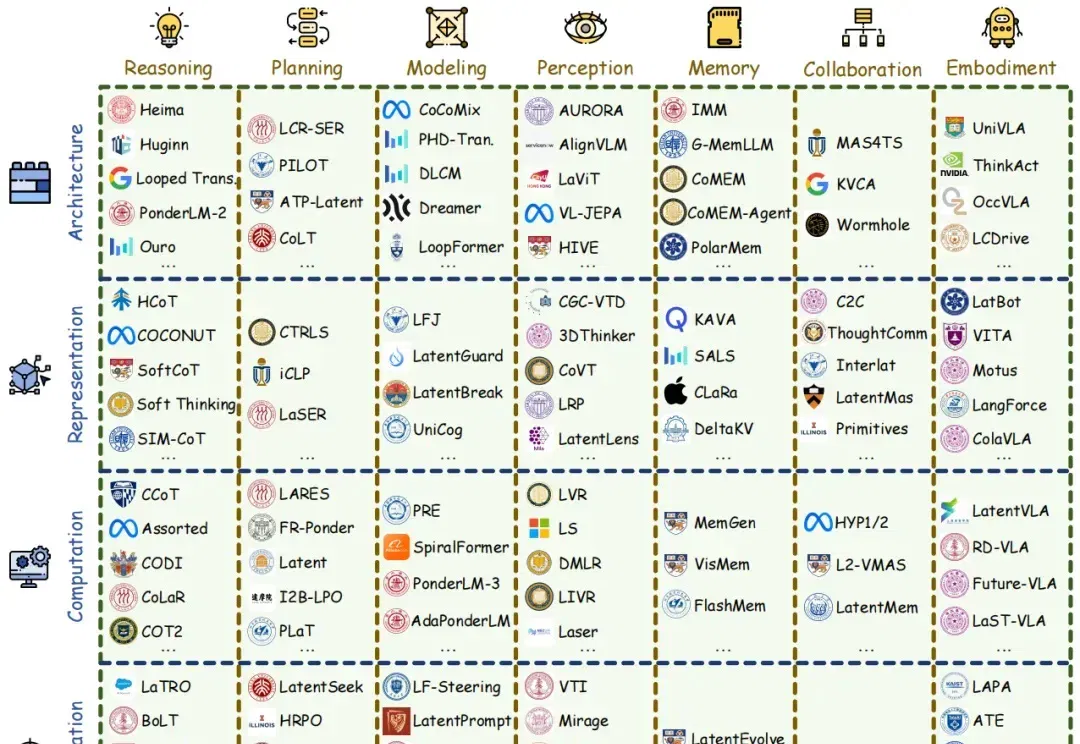
从 2024 年底的关于潜在空间的早期探索,再到 2025 年底和 2026 年初的相关研究爆发,潜空间范式正在彻底重塑大模型 (LLMs, VLMs, VLAs 等延伸模型) 的底层设计逻辑。
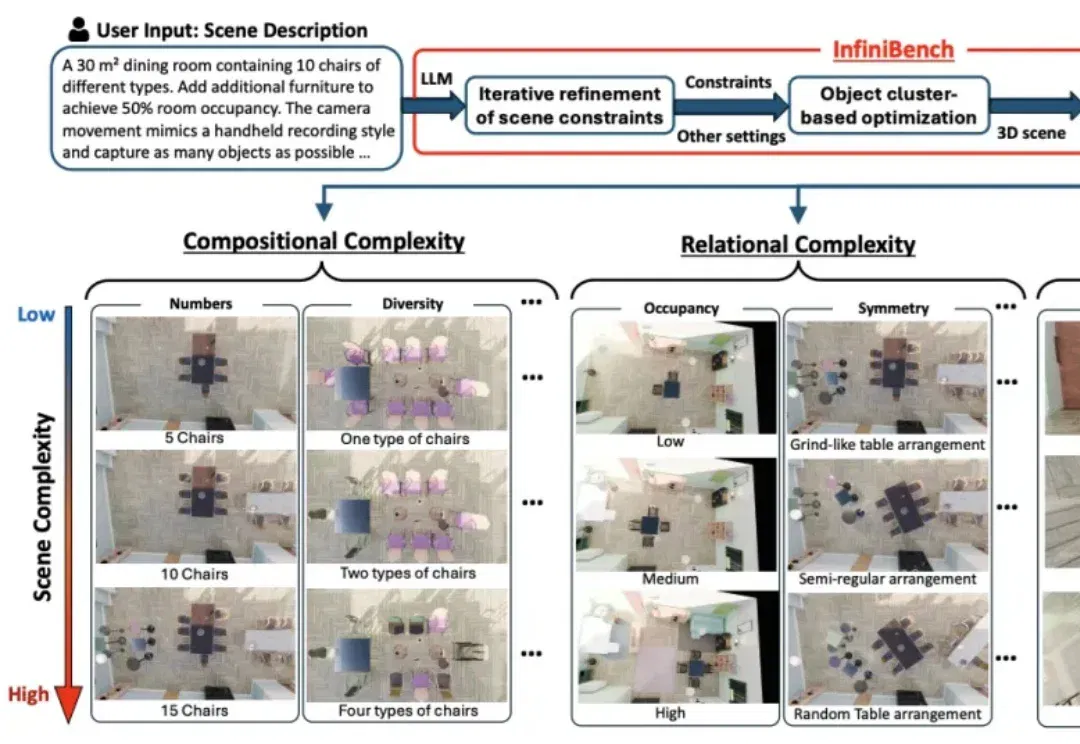
VLM看图像描述头头是道,一遇到3D空间推理就“晕菜”。
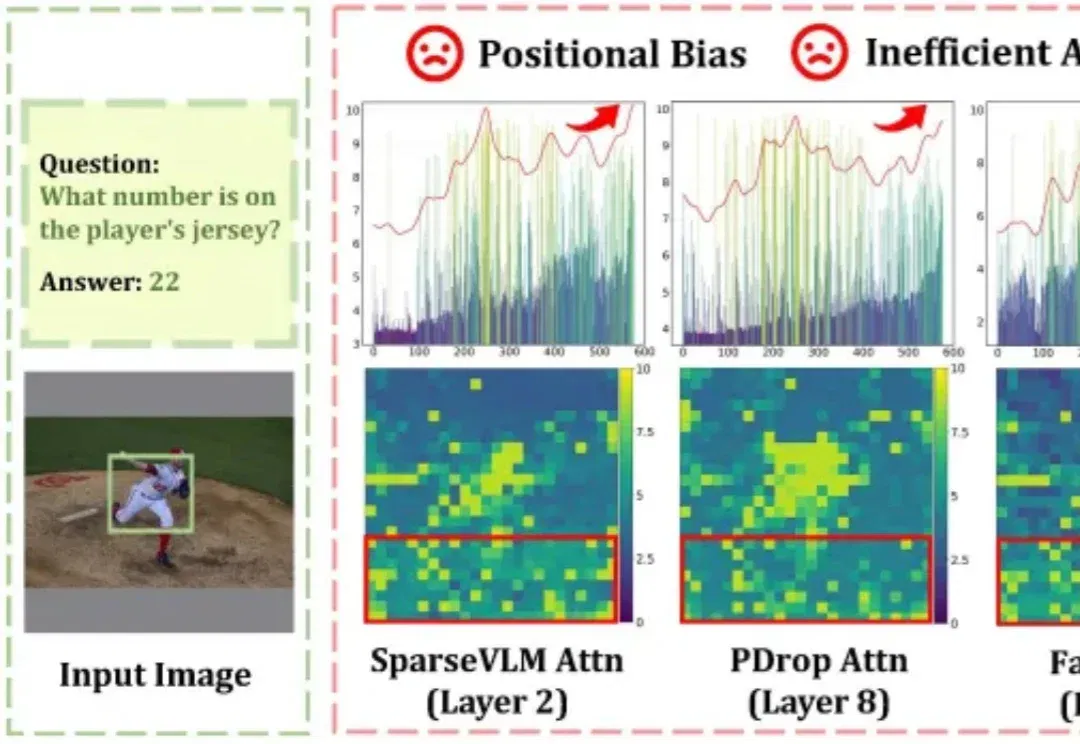
随着高分辨率图像理解与长视频处理需求的爆发式增长,大型视觉语言模型(LVLMs)所需处理的视觉 Token 数量急剧膨胀,推理效率成为落地部署的核心瓶颈。Token 压缩是缩短序列、提升吞吐的直接手段,但现有方法普遍依赖注意力权重来判断 Token 重要性,这一路线暗藏两个致命缺陷: