世界模型和具身大脑最新突破:90%生成数据,VLA性能暴涨300%|开源(在新窗口打开)
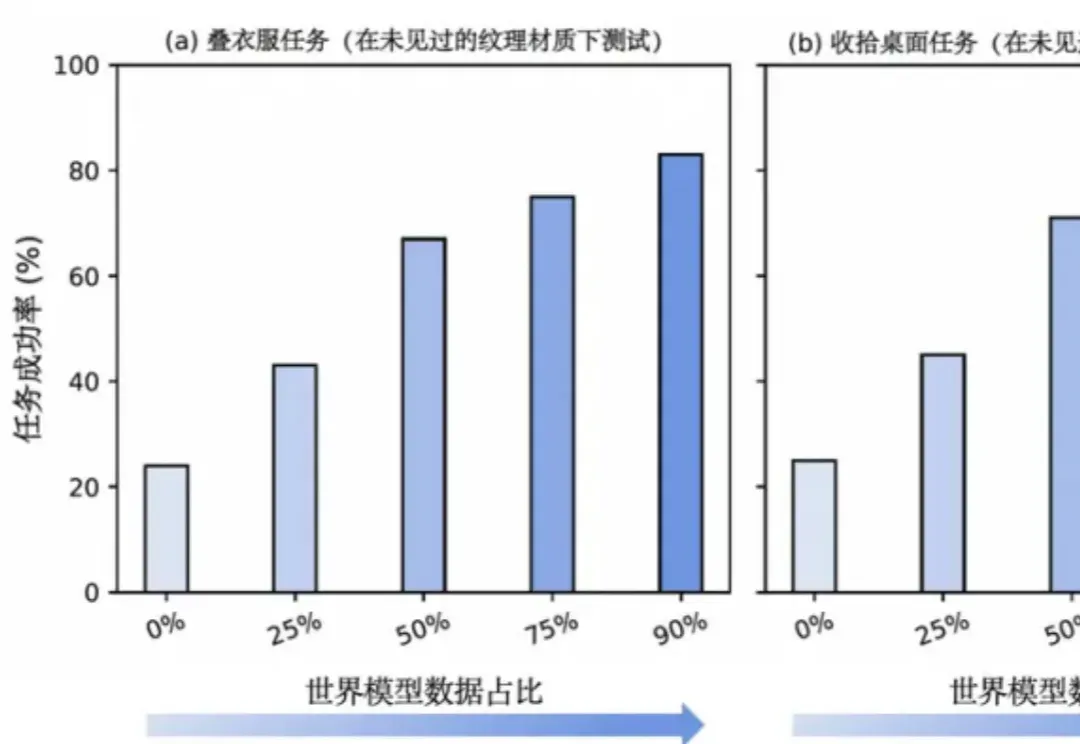
VLA模型性能暴涨300%,背后训练数据还首次实现90%由世界模型生成。
共 17 篇
VLA模型性能暴涨300%,背后训练数据还首次实现90%由世界模型生成。
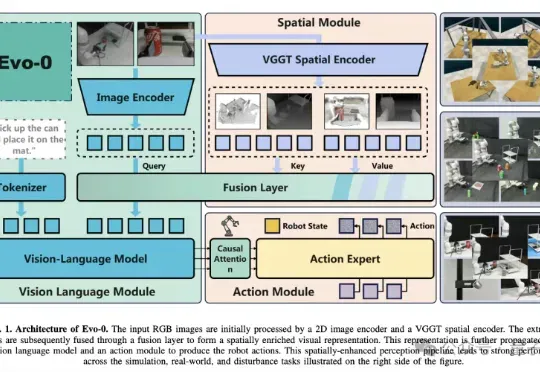
VLA模型通常建立在预训练视觉语言模型(VLM)之上,仅基于2D图像-文本数据训练,缺乏真实世界操作所需的3D空间理解能力。
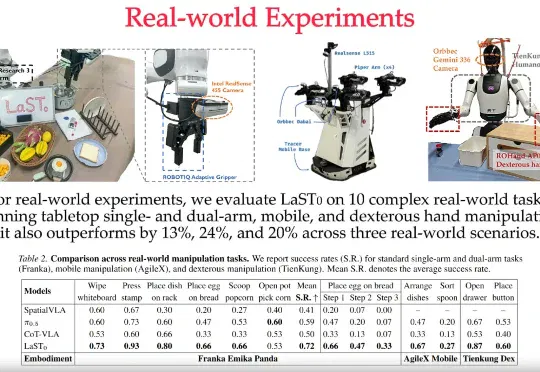
LaST₀团队 投稿 量子位 | 公众号 QbitAI 近日,至简动力、北京大学、香港中文大学、北京人形机器人创新中心提出了一种名为LaST₀的全新隐空间推理VLA模型,在基于Transformer混
具身数据层的全球竞赛正在迅速升温。NVIDIA Research在2026年发布EgoScale数据与训练框架,在Ego-centric人类操作视频上训练VLA模型,用 20,854小时带动作标注的第一人称人类视频,观察到数据规模和验证损失之间接近对数线性的scaling law。1X收集人类第一视角及家庭行为数据,通过 Sunday项目采集百万小时级家庭场景视频。
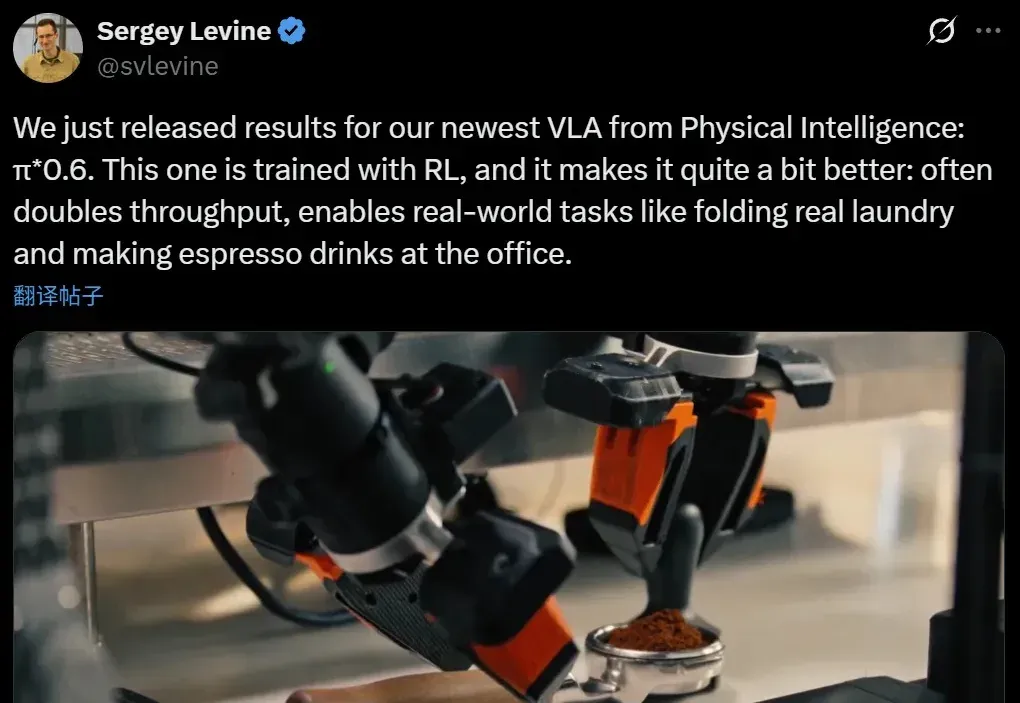
本周,美国具身智能创业公司 Physical Intelligence(简称 PI 或 π)发布了旗下的最新机器人基础模型 π*0.6。PI 是一家总部位于旧金山的机器人与 AI 创业公司,其使命是将通用人工智能从数字世界带入物理世界:他们的首个机器人通用基础模型名为 π₀,让同一套软件控制多种物理平台执行各类任务。
这个月,具身智能领域又卷出新高度:硅谷独角兽公司 Generalist AI 发布全新一代基础模型 GEN-1,将机器人包装手机、折纸箱这些活的平均成功率直接拉到了创纪录的 99%,折纸箱的速度更是飙到了以前的三倍(34s vs 12.1s)。
对于电子产品,我们已然习惯了「出厂即巅峰」的设定:开箱的那一刻往往就是性能的顶点,随后的每一天都在折旧。