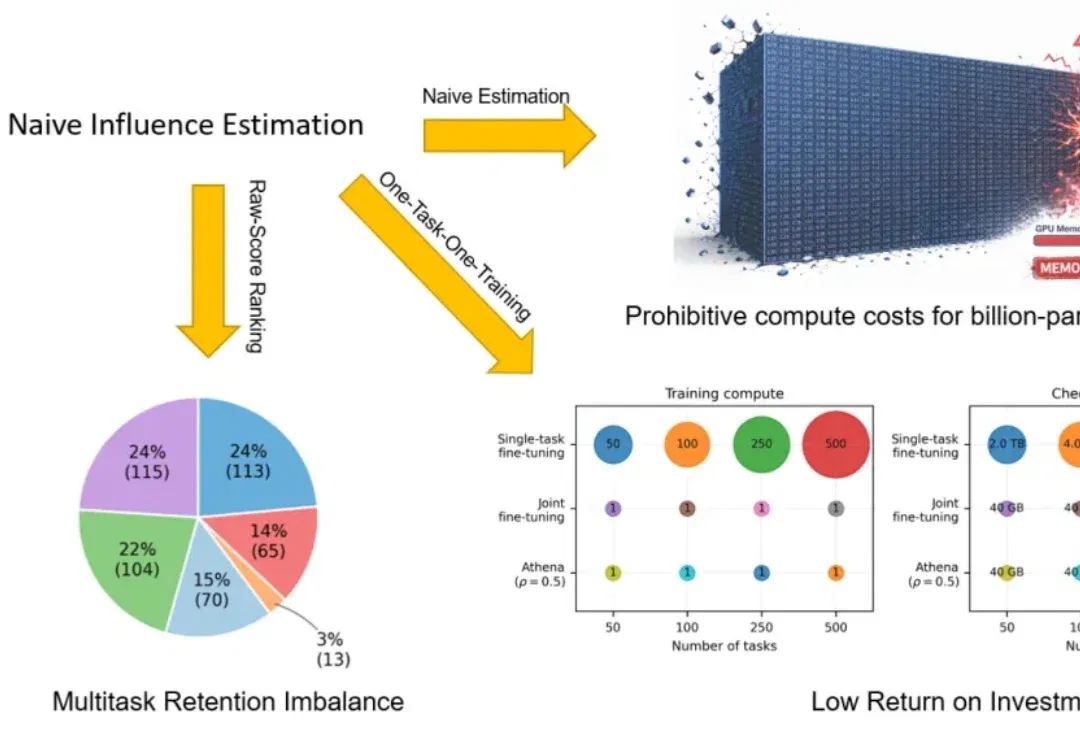
怎么量化机器人数据价值?ATHENA将影响函数扩展到十亿参数VLA,313×加速筛选高价值数据(在新窗口打开)
具身智能正在进入数据 scaling 时代。Vision-Language-Action(VLA)模型让机器人可以从大规模示教数据(demonstrations)中学习更通用的操作策略。但对机器人 VLA 训练来说,数据并不总是越多越好:低质量数据可能会拖累模型性能,而每一条 demonstration 都意味着昂贵的人力采集、机器人运行,以及云端存储和训练成本。
共 122 篇
具身智能正在进入数据 scaling 时代。Vision-Language-Action(VLA)模型让机器人可以从大规模示教数据(demonstrations)中学习更通用的操作策略。但对机器人 VLA 训练来说,数据并不总是越多越好:低质量数据可能会拖累模型性能,而每一条 demonstration 都意味着昂贵的人力采集、机器人运行,以及云端存储和训练成本。
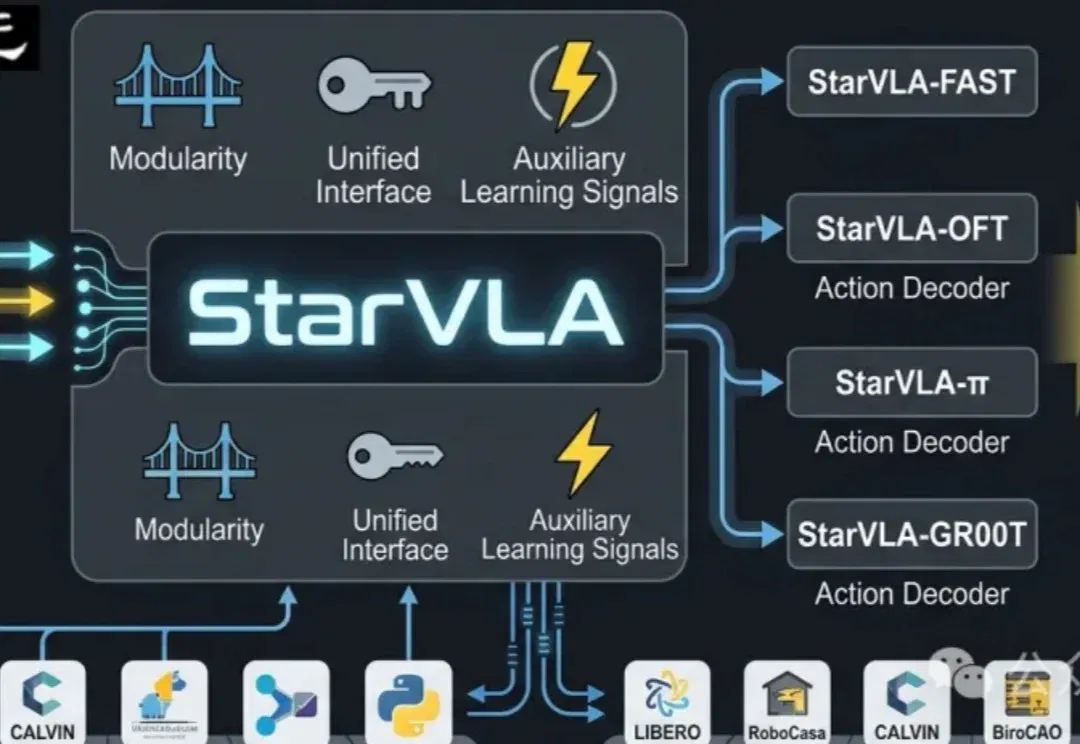
当前具身智能的VLA(Vision-Language-Action)赛道正陷入典型的「碎片化」泥潭:不同团队采用异构的动作解码范式、强耦合的数据管线、互不兼容的评测协议,导致方法难以横向对比,复现成本极高。
MMLab@NTU联合中山大学的最新研究,给出了一份从入门到精通的终极“菜谱”——VLANeXt。这项研究没有简单提出一个新模型了事,而是系统性地从12个关键维度,深度剖析了VLA的设计空间。从基础组件到感知要素,再到动作建模的额外视角,每一步都有扎实的实验支撑。
ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
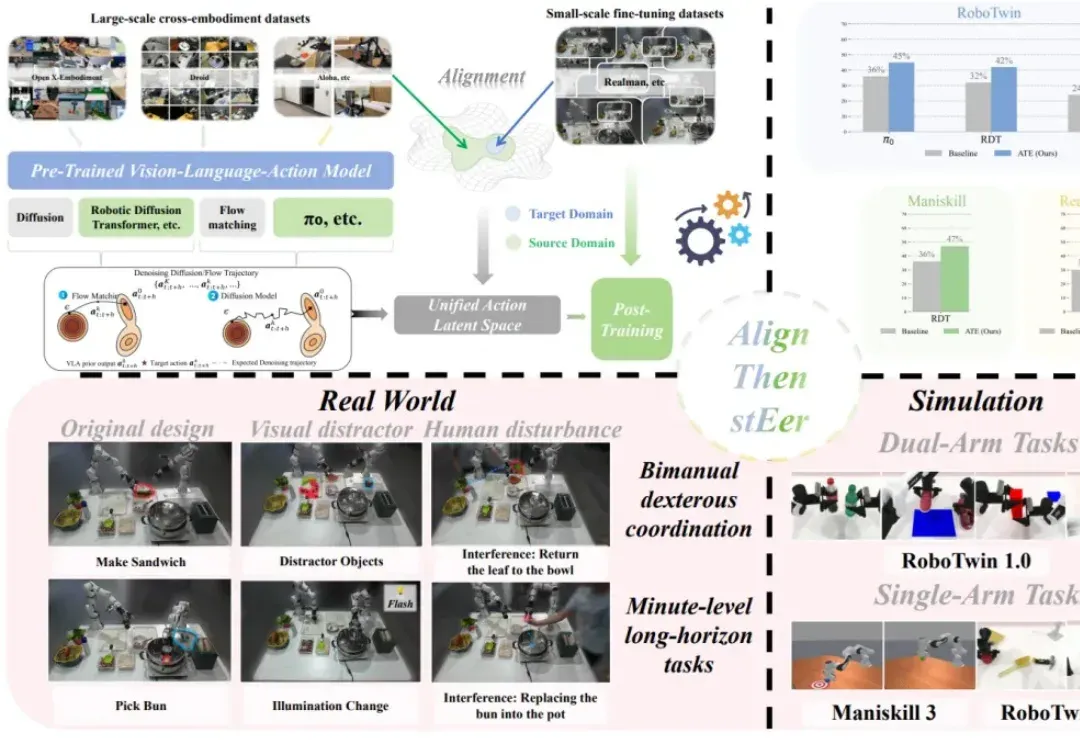
在多模态大模型的基座上,视觉 - 语言 - 动作(Visual-Language-Action, VLA)模型使用大量机器人操作数据进行预训练,有望实现通用的具身操作能力。
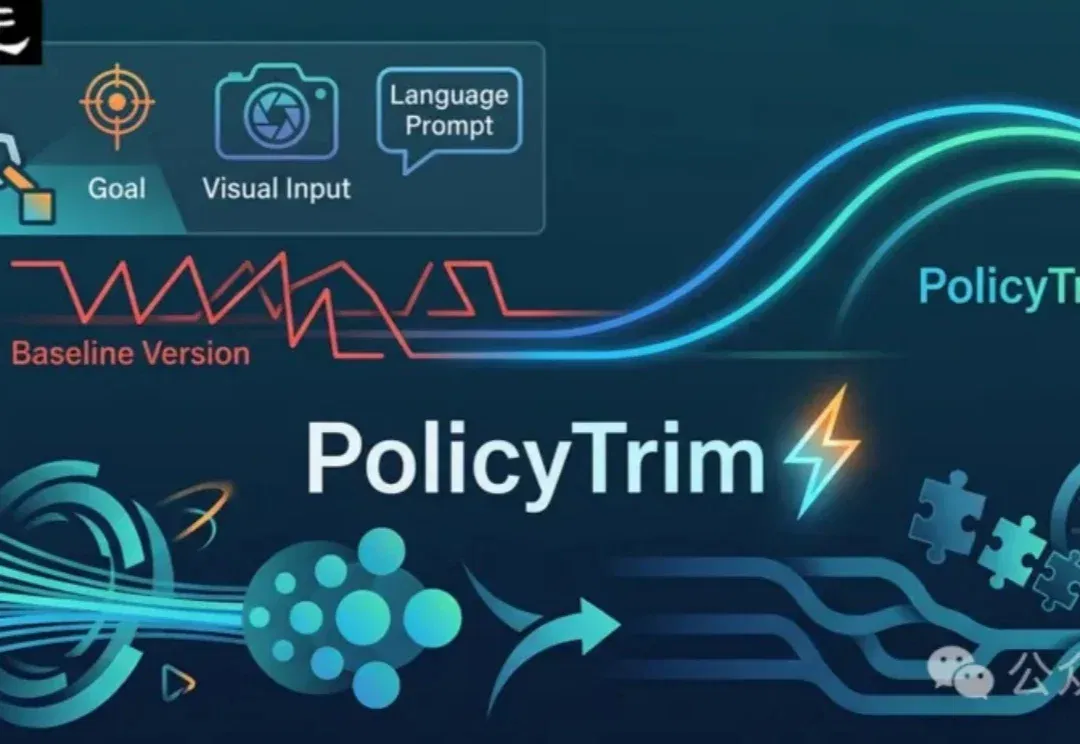
VLA模型已经会做任务,但真实机器人还是慢!PolicyTrim是一种优化VLA机器人执行效率的方法,无需重新训练。它通过扩展可靠动作序列并减少冗余步骤,帮助机器人更直接完成任务,提升整体速度。
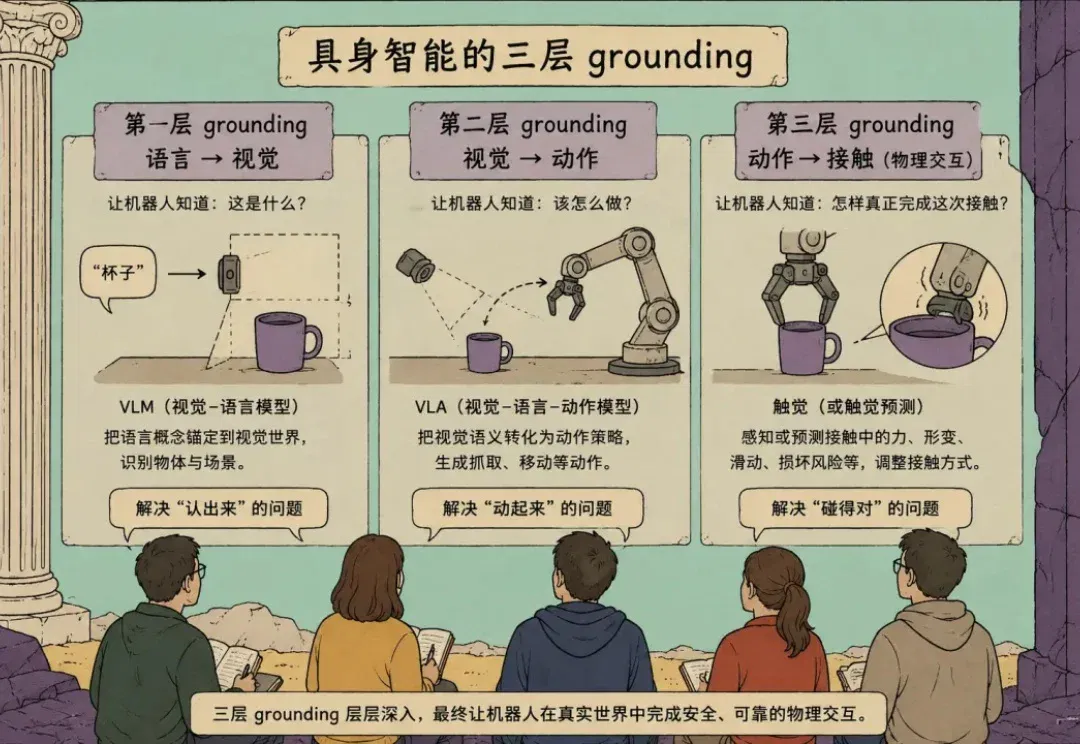
机器人,也开始拥有“触觉想象力”了。 过去一年,随着具身基础模型的快速发展,机器人已经能完成不少轮廓清晰、位置明确的操作任务。 可一旦涉及柔性物体、易损物体或密集接触,机器人往往就开始力不从“脑”。 △AI生成 无论是捏起一颗葡萄而不将它捏破,还是抓住一只纸杯而不让它变形,视觉只能帮助机器人找到目标,想要完成任务,机器人还需要人类与物体交互时不可或缺的触觉感知。 也正因为如此,现在也有越来越多团队开始将触觉作为建构机器人大脑的重要模态。比如,UniTouch、AnyTouch尝试统一不同传感器的触觉表征,FuSe、Tactile-VLA把触觉送进通用策略与VLA,近期的TacImag则开始探索
依赖于有限机器人数据和大量人类数据,也能让 VLA 模型更稳健吗?
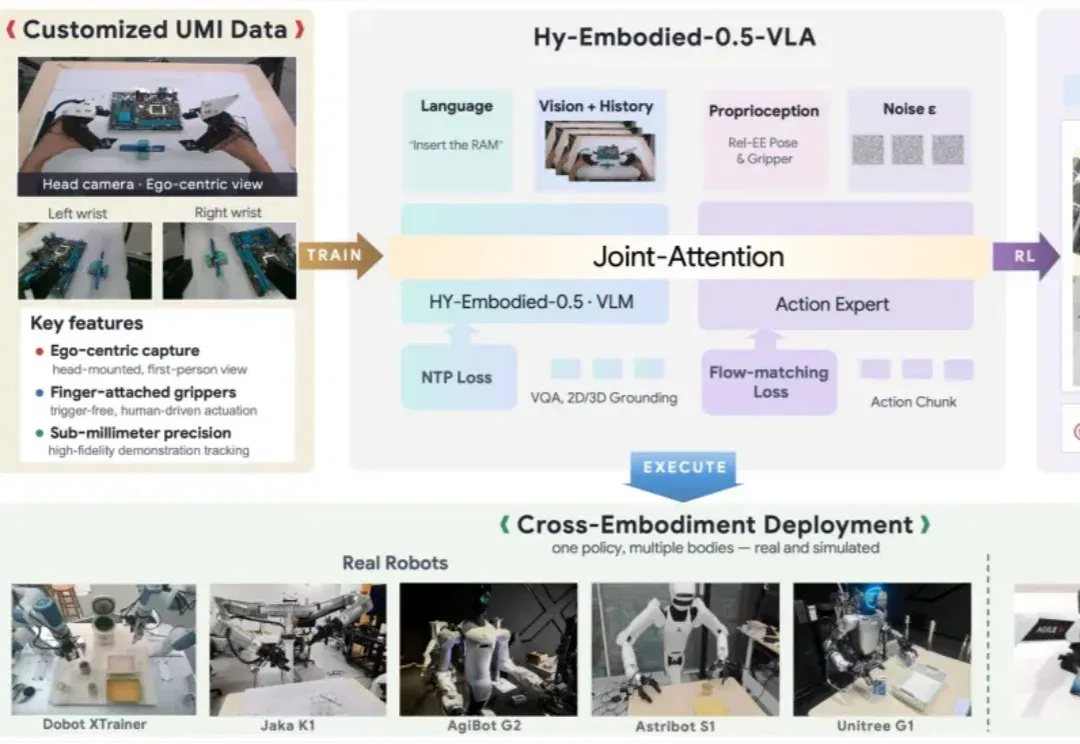
6 月 15 日,腾讯 Robotics X、福田实验室与混元团队联合发布面向真实世界机器人操作任务的端到端具身智能模型 Hy-Embodied-0.5-VLA(简称 HyVLA-0.5)。
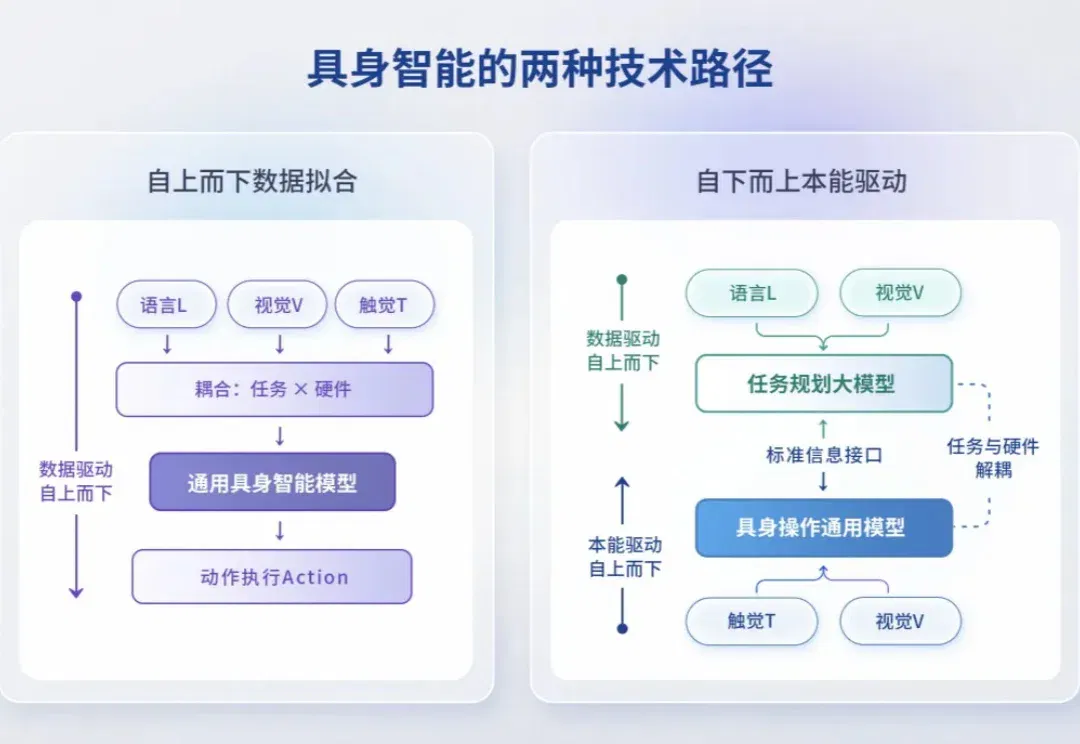
这是第一次,机器人学会了用手「盘」: 在有人和它博弈的情况下,能稳稳拿住东西: 更让人想不到的是,这是通过「本能」来实现的:机器人完全没有经过对应的训练,上手就能做到。 一家清华大学背景的团队,在探索 8 年后,走出了一条与主流 VLA 截然相反的路线:自下而上,本能驱动。 当全行业都在教机器人「用眼睛看、用脑子想」时,橡木果(Acorn Robot)决定先给机器人装上「具身本能」,达成了前所未有的实用性。 在这背后,不仅有独一无二的技术,还有对于当前具身智能技术路线的独特思考。 VLA 路线,有必然「走不通」的地方 当前火热的具身智能领域,VLA(视觉 - 语言 - 动作)模型几乎成了唯一的