在AI艺术黑客松,我没有开屏成功(在新窗口打开)
在超级发电站主办的AI艺术黑客松上,作者基于麦浚龙和谢安琪的概念专辑《The Album》创作了一款由语言模型和TTS驱动演员的2.5D实时互动游戏,玩家可扮演酒保自由输入与AI角色互动,推动剧情走向不同结局。
共 23 篇
在超级发电站主办的AI艺术黑客松上,作者基于麦浚龙和谢安琪的概念专辑《The Album》创作了一款由语言模型和TTS驱动演员的2.5D实时互动游戏,玩家可扮演酒保自由输入与AI角色互动,推动剧情走向不同结局。
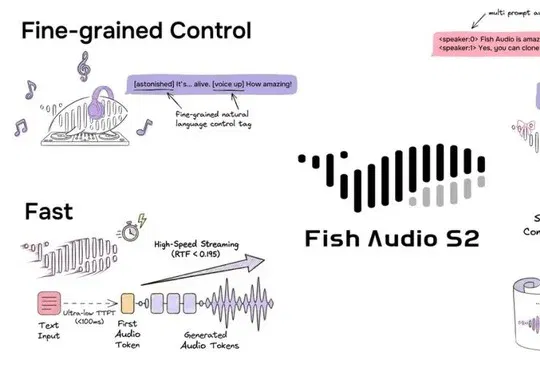
Fish Audio(上海奇塔灵动科技)由00后廖世嘉带领22人团队,凭借开源语音模型Fish Speech在TTS Arena盲听榜连续7个月第一,年化收入达2100万美元,2026年7月获今日资本领投5200万美元种子轮。
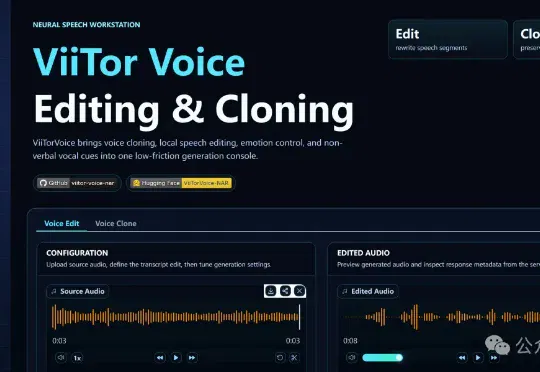
全球第一!中国AI语音ViiTorVoice首创「局部编辑」神技:配音错字告别重录,像改Word一样修语音。内附姆巴佩、哈兰德爆笑实测,快来见证!这个凭空出世的中国模型,将 Qwen3-TTS、CosyVoice3、Fish Audio 等一众主流巨头挑落马下,径直登顶综合排名第一!
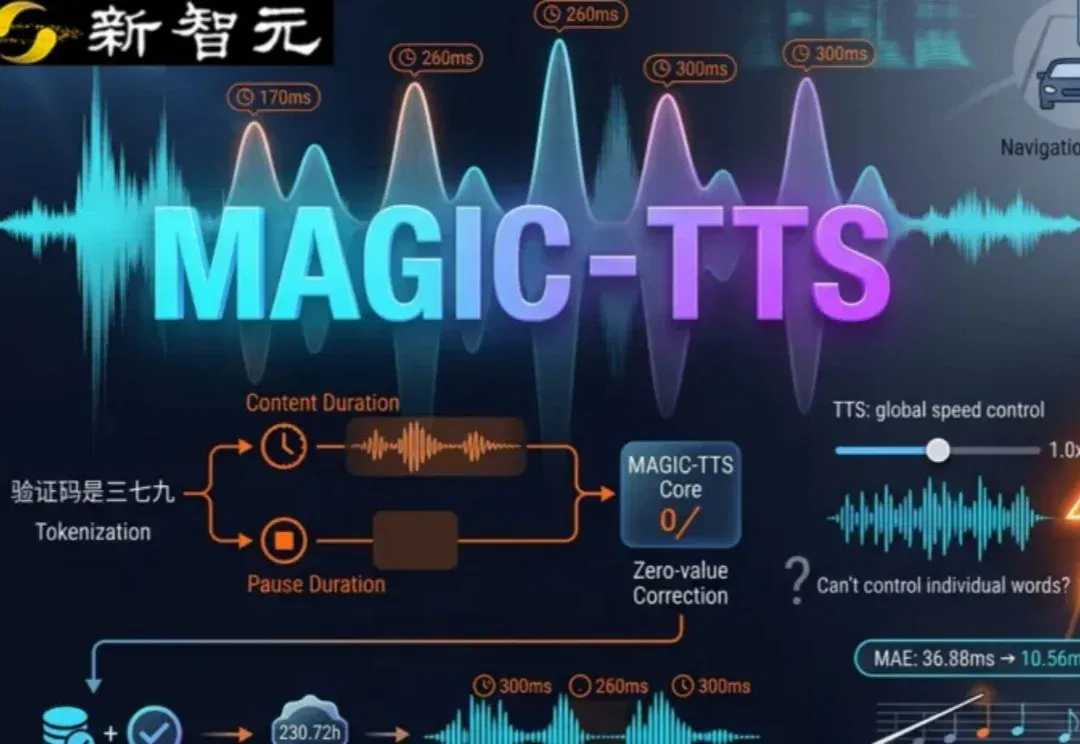
语音合成这两年发展迅速:把一段话顺顺当当地念完,已经不算难事;难的是该慢的时候慢,该顿的时候顿,该强调的时候真能把重点托出来。

没错,用的就是主打长程任务、模糊指令遵循,跻身国产Agent第一梯队的小米MiMo‑V2.5 Pro。小米最新发布的MiMo‑V2.5系列,包含Pro旗舰Agent、全模态基座、TTS语音合成、ASR语音识别四大模型,综合实力对标国际顶尖水准。
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
今日凌晨,小米MiMo大模型系列重磅三连更:旗舰基座大模型MiMo-V2-Pro、全模态Agent模型MiMo-V2-Omni、MiMo-V2-TTS,其最新发布的这三大模型都是为优化智能体能力打造。
阿里巴巴推出了Qwen3-Max-Thinking,这是阿里千问系列目前能力最强的旗舰级推理模型,在19项权威基准测试中,Qwen3-Max-Thinking跟GPT-5.2-Thinking、Claude-Opus-4.5和Gemini 3 Pro等顶尖模型打得有来有回,搭配测试时扩展(TTS)能力后,能在不少基准测试上达到SOTA。
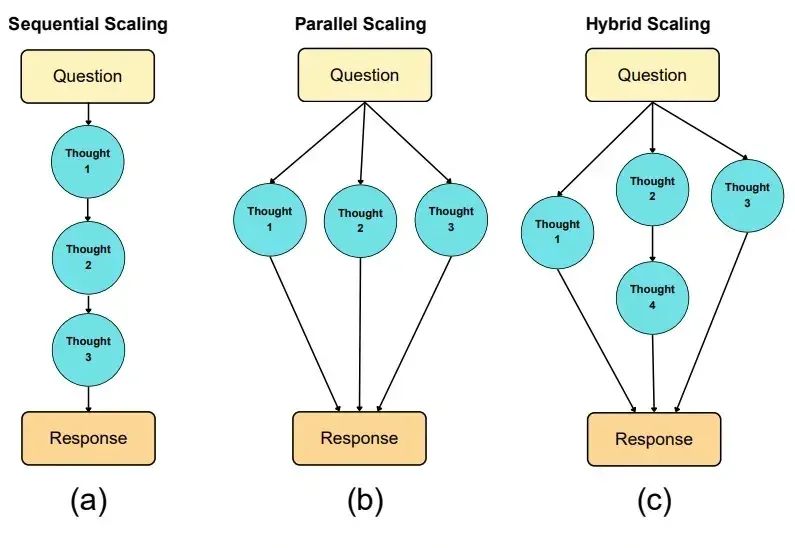
如果说大模型的预训练(Pre-training)是一场拼算力、拼数据的「军备竞赛」,那么测试时扩展(Test-time scaling, TTS)更像是一场在推理阶段进行的「即时战略游戏」。
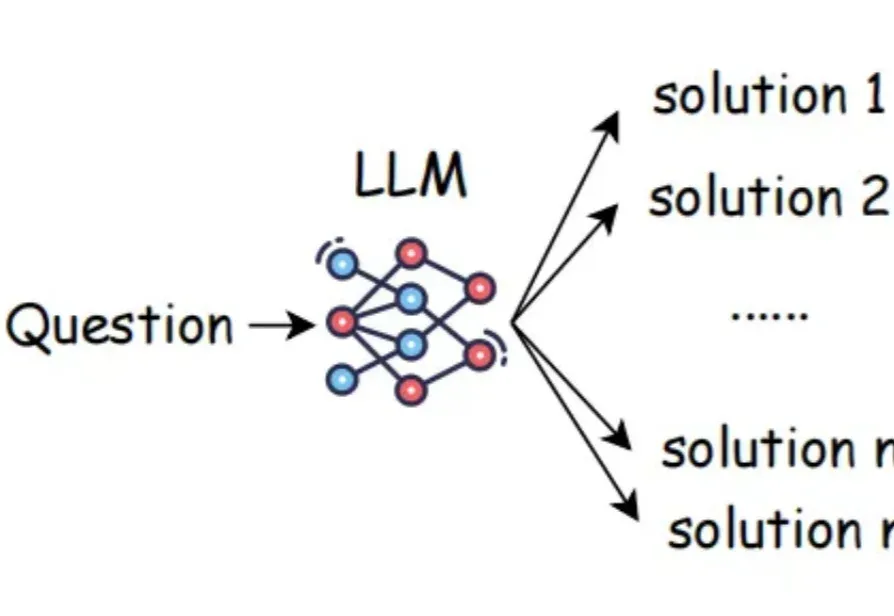
在大语言模型(LLM)席卷各类复杂任务的今天,“测试时扩展”(Test-Time Scaling,TTS)已成为提升模型推理能力的核心思路 —— 简单来说,就是在模型 “答题” 时分配更多的计算资源来让它表现更好。严格来说,Test-Time Scaling 分成两类: