搜索

关于“Scaling”的结果

共 111 篇

蚂蚁具身智能明牌了:做大脑,和宇树们错位竞争

蚂蚁具身智能明牌了:做大脑,和宇树们错位竞争(在新窗口打开)

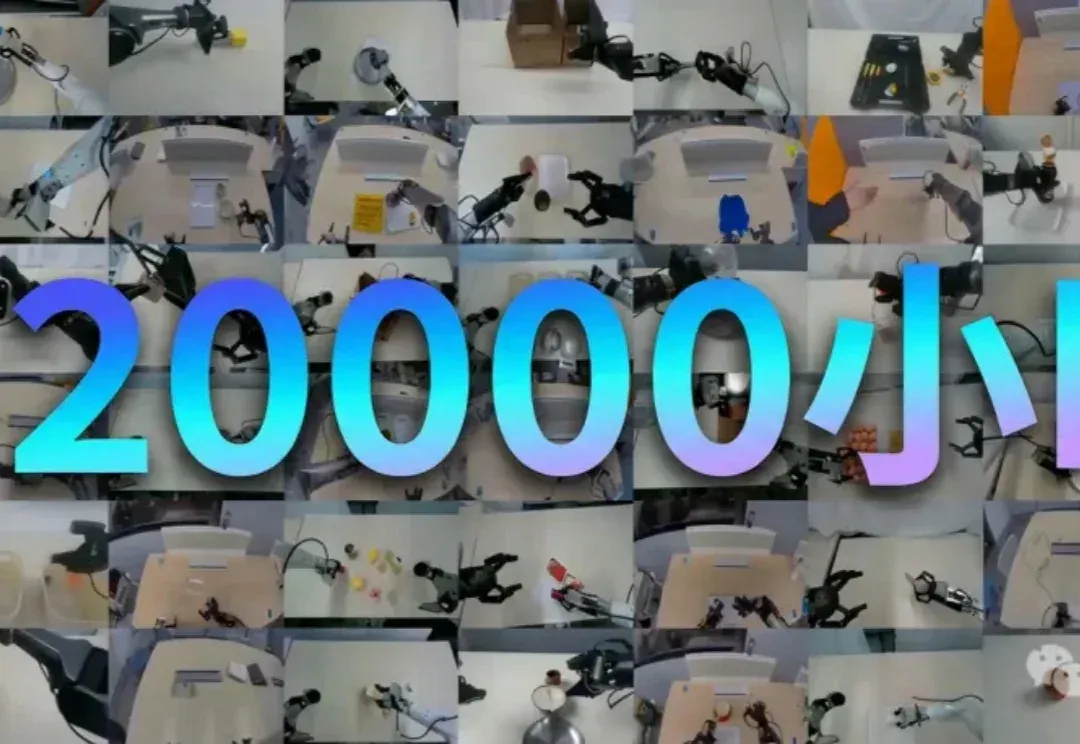
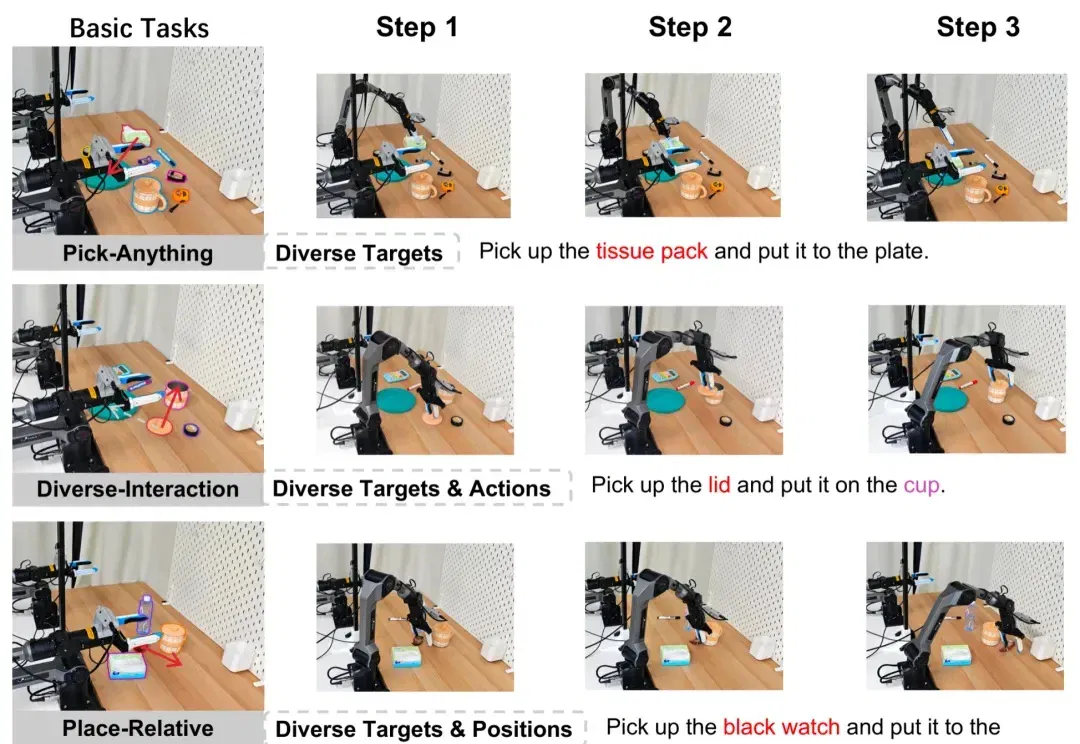
从3000小时到整整20000小时。 真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot-VLA。 为什么说它是目前最强?先看数据。 从“20000小时”这个量上来看,LingBot-VLA已经解锁了迄今为止开源的最大规模真实机器人数据之一。 并且性能也是够打,在权威评测中也全面超越了此前公认最强Physical Intelligence的π0.5,以及英伟达GR00T N1.6等一众国际顶尖模型。 再看实际表现。 此前具身智能圈子一个很头疼的问题,就是一旦环境发生
AI技术文章
0
对标英伟达EgoScale数据路径,清华系孵化星忆科技拿到首轮融资

对标英伟达EgoScale数据路径,清华系孵化星忆科技拿到首轮融资(在新窗口打开)

具身数据层的全球竞赛正在迅速升温。NVIDIA Research在2026年发布EgoScale数据与训练框架,在Ego-centric人类操作视频上训练VLA模型,用 20,854小时带动作标注的第一人称人类视频,观察到数据规模和验证损失之间接近对数线性的scaling law。1X收集人类第一视角及家庭行为数据,通过 Sunday项目采集百万小时级家庭场景视频。

AI资讯
0
Scaling Law的焦虑差距可以由「交互深度」解决,MiroMind用Qwen3-72B在GAIA中超越GPT5

Scaling Law的焦虑差距可以由「交互深度」解决,MiroMind用Qwen3-72B在GAIA中超越GPT5(在新窗口打开)

在过去五年,AI领域一直被一条“铁律”所支配,Scaling Law(扩展定律)。它如同计算领域的摩尔定律一般,简单、粗暴、却魔力无穷:投入更多的数据、更多的参数、更多的算力,模型的性能就会线性且可预测地增长。无数的团队,无论是开源巨头还是商业实验室,都将希望孤注一掷地押在了这条唯一的救命稻草上。

AI技术文章
0