阿里深夜开源80B编程模型!专攻智能体,周靖人、林俊旸最新成果发布(在新窗口打开)
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
共 30 篇
个人电脑也能跑出顶级编程智能体?今日凌晨,阿里开源了一款小型混合专家模型Qwen3-Coder-Next,专为编程智能体(Agent)和本地开发打造。该模型总参数80B,激活参数仅3B,在权威基准SWE-Bench Verified上实现了超70%的问题解决率,性能媲美激活参数规模大10-20倍的稠密模型。
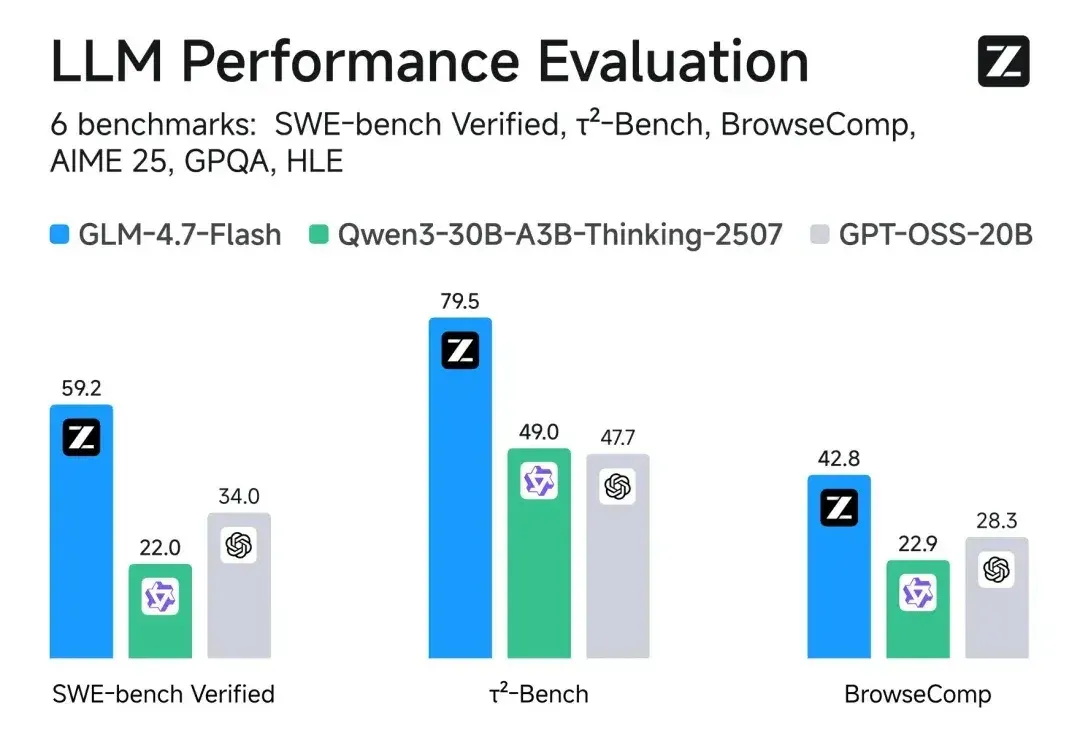
智谱AI上市后,再发新成果。 开源轻量级大语言模型GLM-4.7-Flash,直接替代前代GLM-4.5-Flash,API免费开放调用。 这是一个30B总参数、仅3B激活参数的混合专家(MoE)架构模型,官方给它的定位是“本地编程与智能体助手”。 在SWE-bench Verified代码修复测试中,GLM-4.7-Flash拿下59.2分,“人类最后的考试”等评测中也显著超越同规模的Qwen3-30B和GPT-OSS-20B。 作为去年12月发布的旗舰模型GLM-4.7的轻量化版本,GLM-4.7-Flash继承了GLM-4系列在编码和推理上的核心能力,同时针对效率做了专门优化。 除了编程
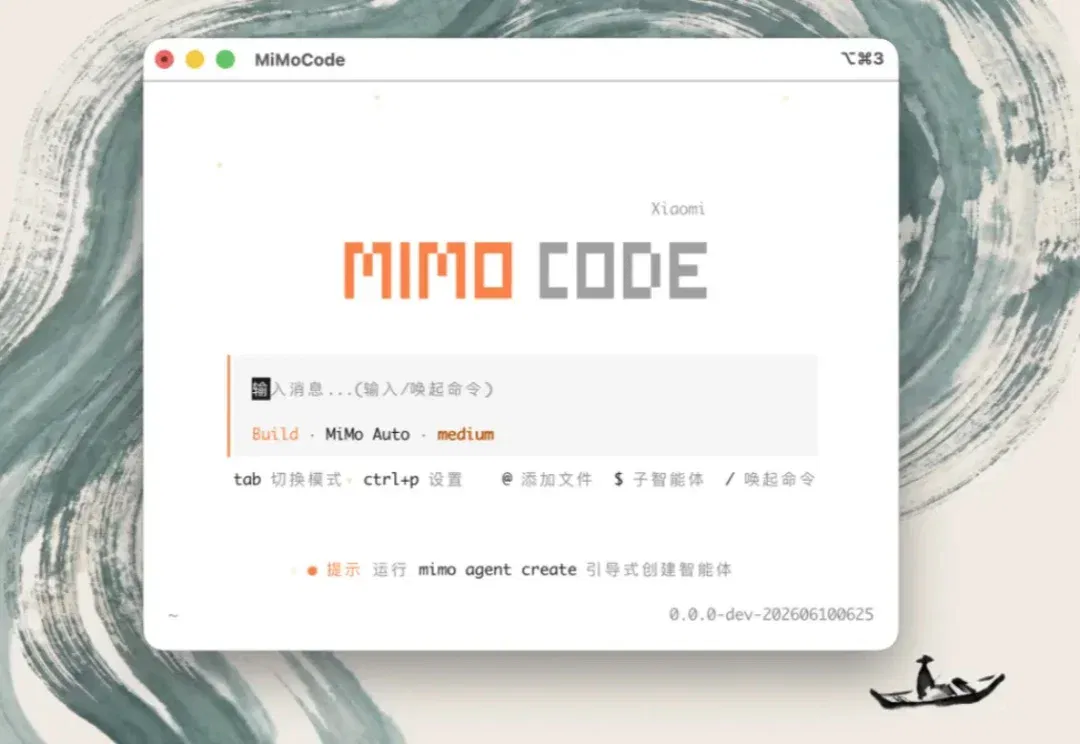
6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。
2025年前盛行的闭源+重资本范式正被DeepSeek-R1与月之暗面Kimi K2 Thinking改写,二者以数百万美元成本、开源权重,凭MoE与MuonClip等优化,在SWE-Bench与BrowseComp等基准追平或超越GPT-5,并以更低API价格与本地部署撬动市场预期,促使行业从砸钱堆料转向以架构创新与稳定训练为核心的高效路线。
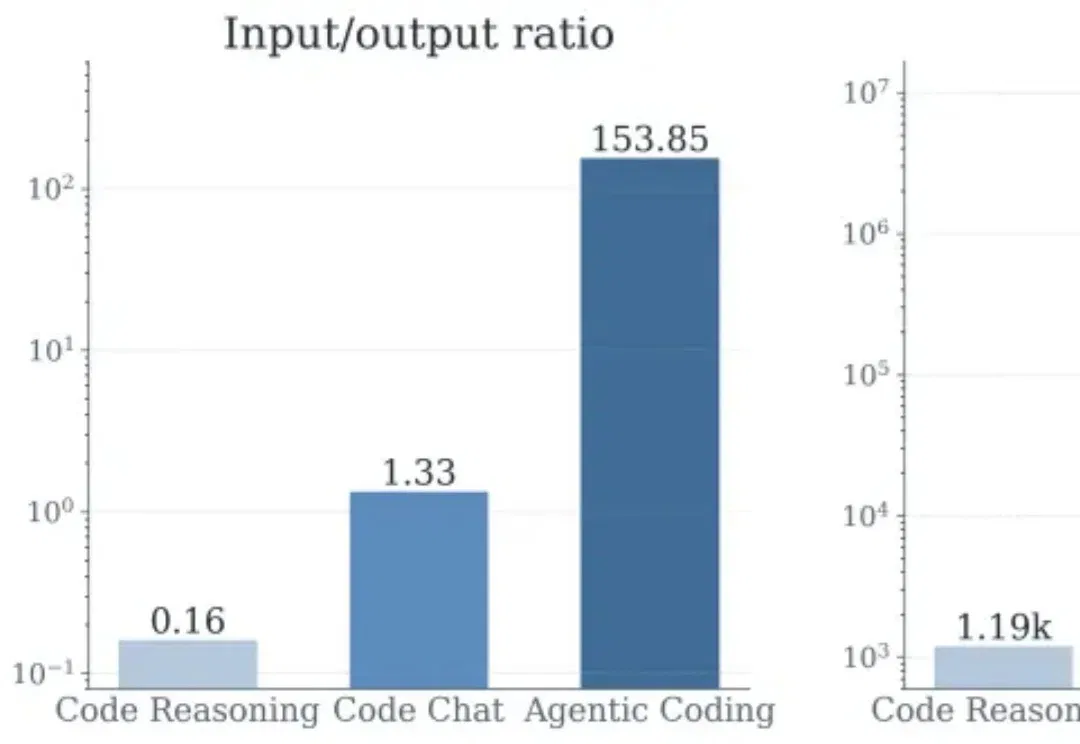
如今的 AI Agent 正在大规模落地,其中应用最广且最受关注的当数 Claude Code,Codex,Cursor 这类 coding agent。过去的一年里,这类 coding agent 产品迭代迅速,在一年内将在 swe-bench- verified 的准确率提高到了 78%+。
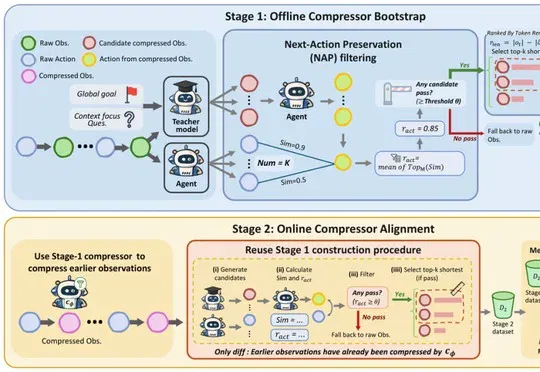
清华团队在SWE-bench Verified的200个实例和三款模型上评估压缩,平均总Token消耗减少33%,任务成功率总体相近。
今天是一期硬核的话题讨论: Coding Agent 评测。 AI 编程能力进步飞速,在国外御三家和国产中厂四杰的努力下,AI 编程基准 SWE-bench 的分数从年初的 30% 硬生生拉到了年底的
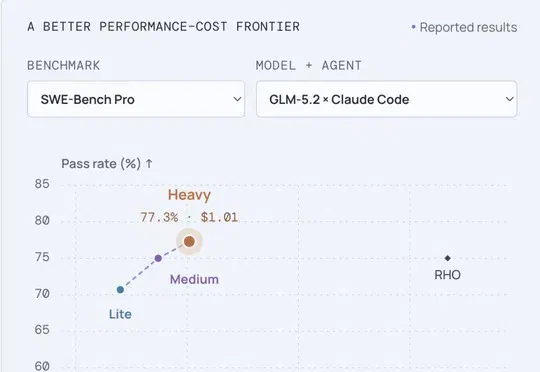
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
MiniMax最新旗舰级Coding & Agent模型M2.1,刚刚对外发布了。这一次,它直接甩出了一份硬核成绩单,在衡量多语言软件工程能力的Multi-SWE-bench榜单中,以仅10B的激活参数拿下了49.4%的成绩,超越了Claude Sonnet 4.5等国际顶尖竞品,拿下全球SOTA。
Grok首个编码模型终于来了!从0构建,编程实力超强,直接冲进SWE-bench前五,仅次于OpenAI Codex-1。背后核心团队同时被爆出,华人学者占多半。