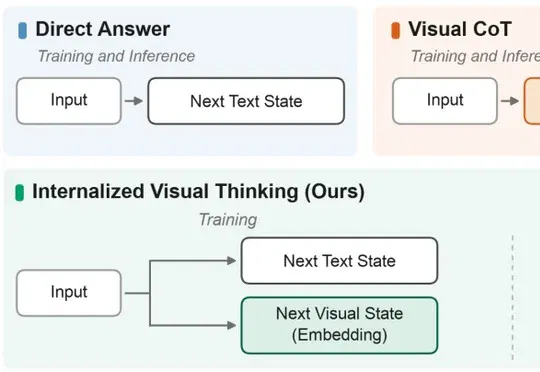
苹果新作:内化视觉思考,推理提速 5 倍(在新窗口打开)
苹果研究团队提出 Internalized Visual Thinking(IVT)后训练框架,通过在训练阶段联合学习文本答案与未来帧隐空间表征、在推理阶段完全移除未来视觉预测过程,使模型在主动视频推理任务上相比 Visual CoT 获得超过 5 倍的推理加速,且在六项评测设置中均优于 Answer-Only SFT。
共 20 篇
苹果研究团队提出 Internalized Visual Thinking(IVT)后训练框架,通过在训练阶段联合学习文本答案与未来帧隐空间表征、在推理阶段完全移除未来视觉预测过程,使模型在主动视频推理任务上相比 Visual CoT 获得超过 5 倍的推理加速,且在六项评测设置中均优于 Answer-Only SFT。
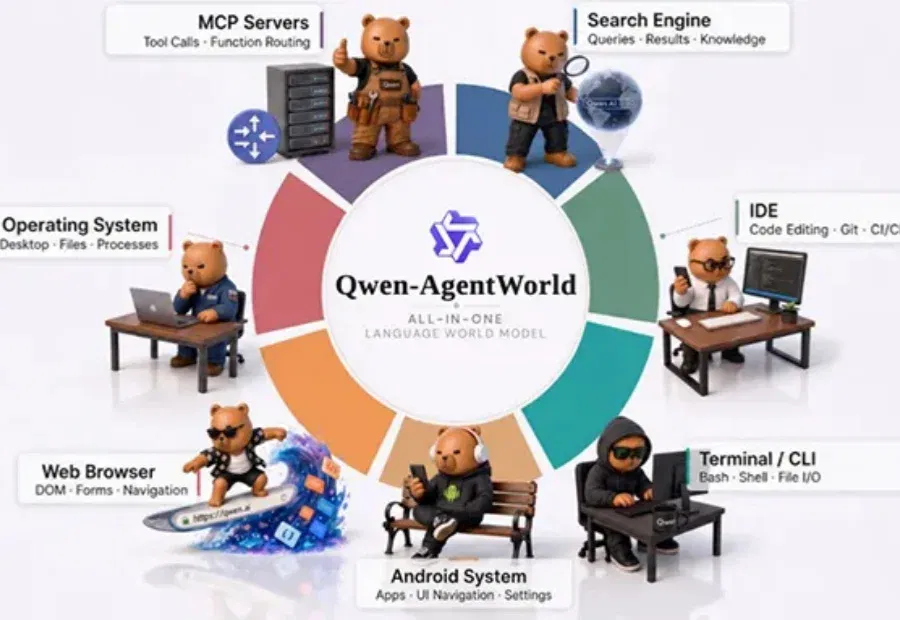
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
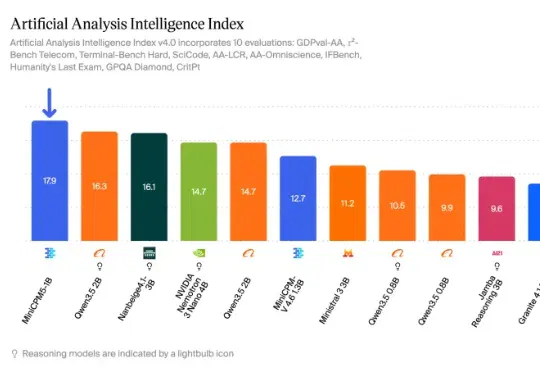
我去搜了下 MiniCPM5-1B 的数据,发现面壁智能刚刚把背后的核心数据集给开源了。一共是两份 L3 级数据集:Ultra-FineWeb-L3 :600B tokens,中英文都有,是目前最大的中文开源合成预训练数据集。
近期,深圳河套学院(SLAI)AI训练平台项目团队,联合哈尔滨工业大学(深圳)、深圳大数据研究院、华为GTS(全球技术服务)团队与深智城AI算力平台,仅用1个月,共同基于昇腾910C国产算力集群实现DeepSeek-V4-Pro全参数续训练/SFT稳定运行,完成长稳训练1500+步,训练MFU超30%,关键训练算子效率提升14%。
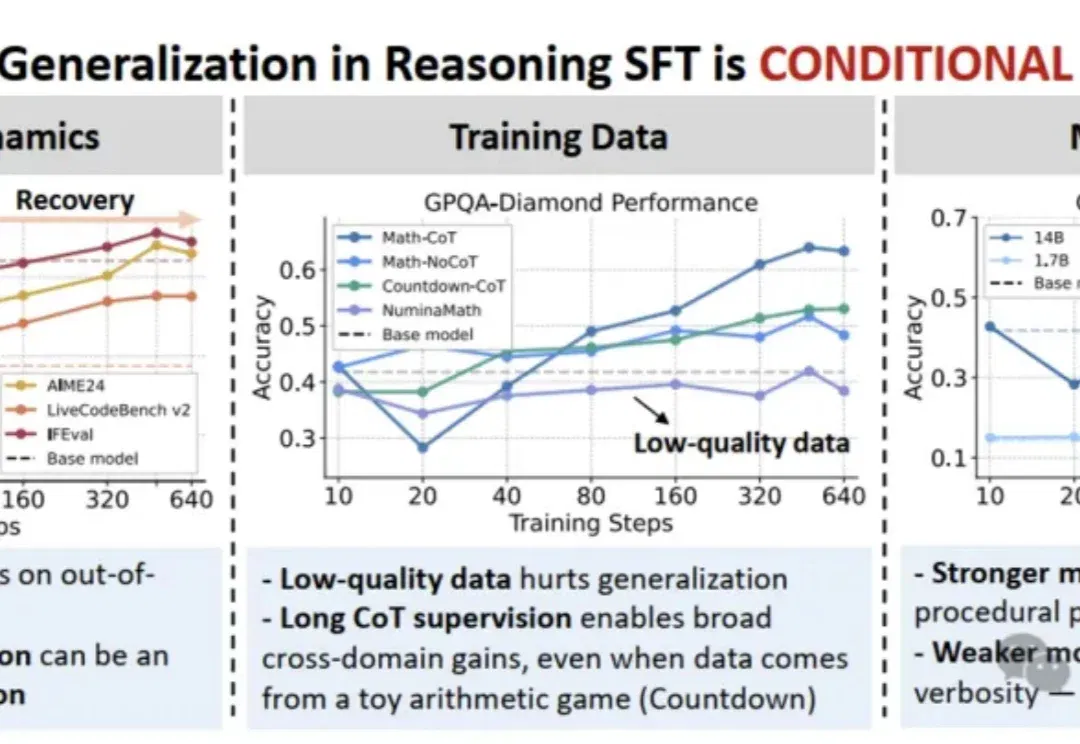
随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。
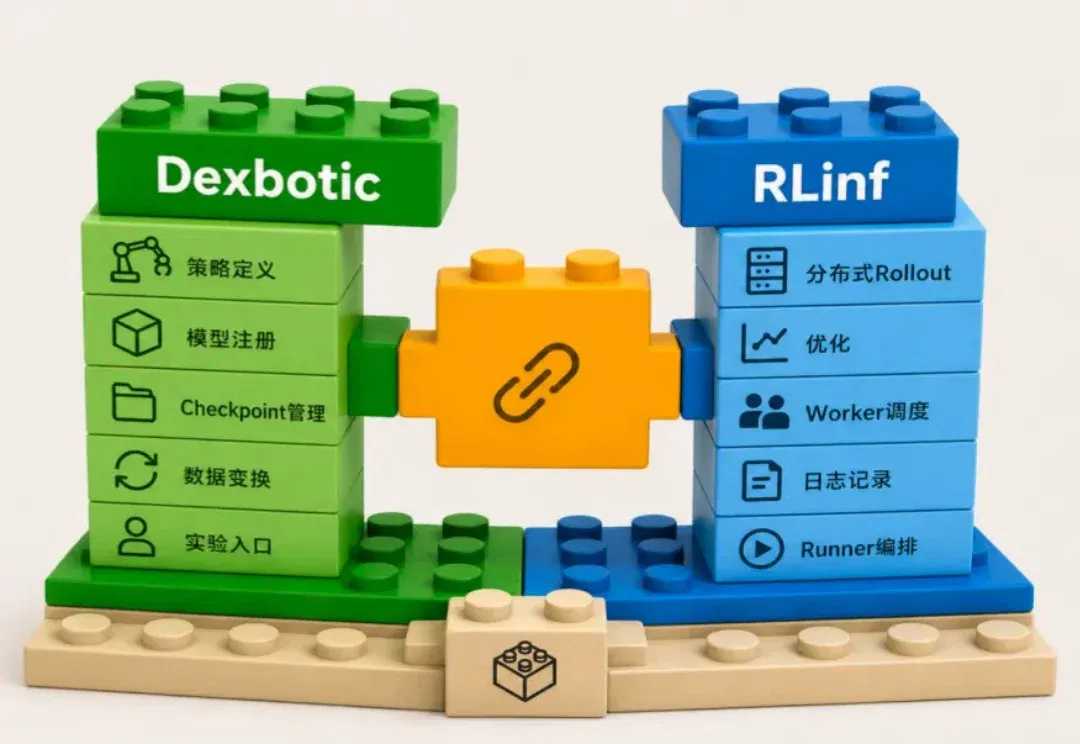
近日,原力灵机开源的具身智能原生框架 Dexbotic 宣布正式支持以 RLinf 作为其分布式强化学习后端。对具身智能开发者而言,这不仅是一次普通的工程适配,更意味着 VLA 模型研发中长期存在的「SFT 与 RL 割裂」问题,正在被真正打通。
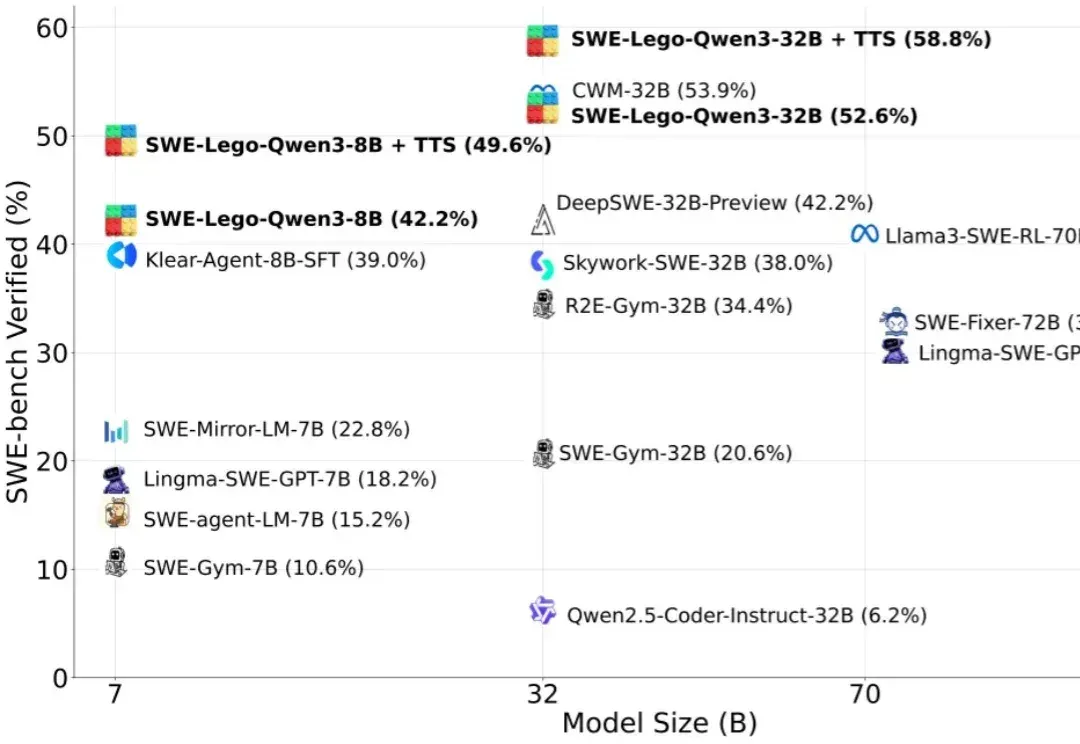
“软工任务要改多文件、多轮工具调用,模型怎么学透?高质量训练数据稀缺,又怕轨迹含噪声作弊?复杂 RL 训练成本高,中小团队望而却步?”
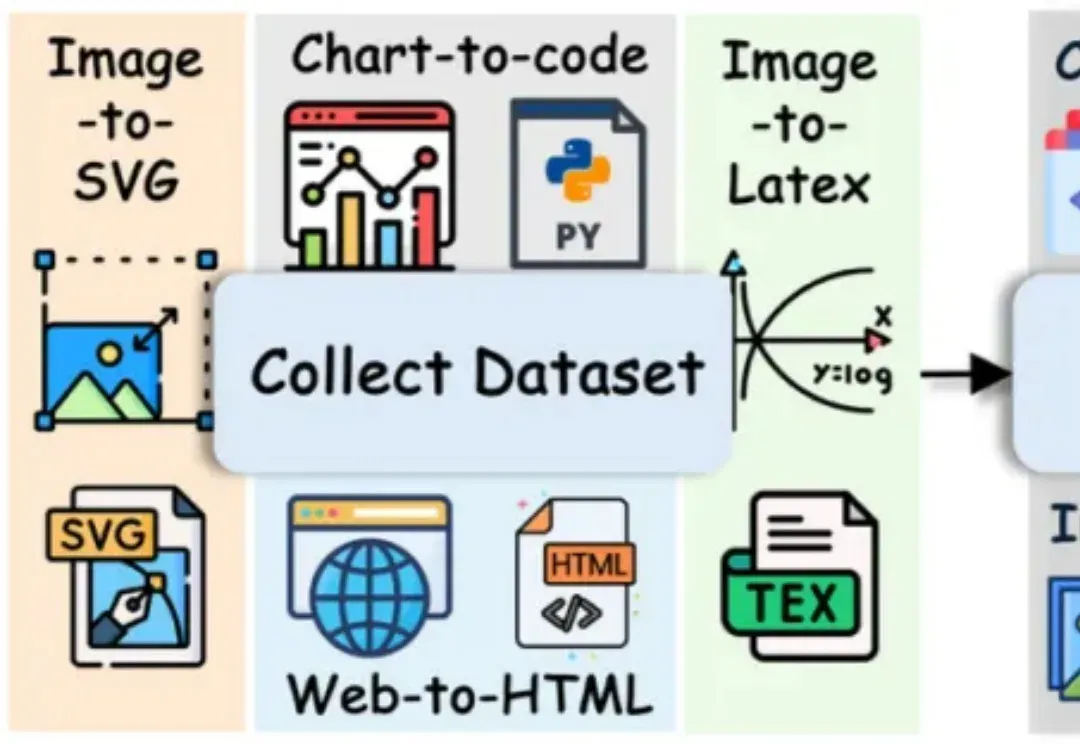
长期以来,多模态代码生成(Multimodal Code Generation)的训练严重依赖于特定任务的监督微调(SFT)。尽管这种范式在 Chart-to-code 等单一任务上取得了显著成功 ,但其 “狭隘的训练范围” 从根本上限制了模型的泛化能力,阻碍了通用视觉代码智能(Generalized VIsioN Code Intelligence)的发展 。
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。
既然后训练这么重要,那么作为初学者,应该掌握哪些知识?大家不妨看看这篇博客《Post-training 101》,可以很好的入门 LLM 后训练相关知识。从对下一个 token 预测过渡到指令跟随; 监督微调(SFT) 基本原理,包括数据集构建与损失函数设计;