
首个统一元递归自我改进架构,让AI「变强的方式」本身变强(在新窗口打开)
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
共 14 篇
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
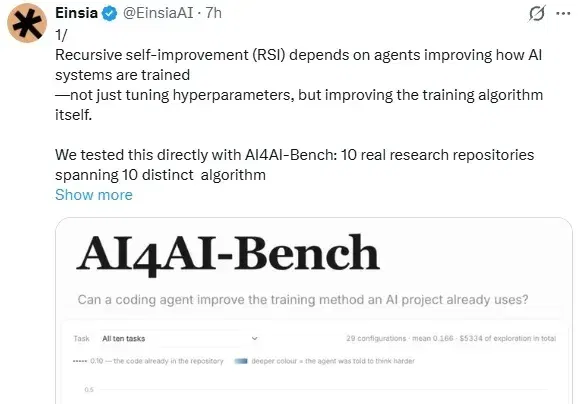
导读 AI 能否改进 AI 自己? AI 已经会写 AI、训练 AI、优化 AI 系统;下一个里程碑,是 AI 能不能开始「设计 AI」。 对于今天的 Coding Agent 来说,它能介入的改进大致有三层: 系统工程解决算子、并行和通信,最终受硬件上限约束;数据工程改进配比、合成和清洗,受高质量信息供给限制;而算法设计改变的是目标函数、更新规则和训练流程本身。 这一层最特殊,一个更好的算法改变的是:在同样的数据和算力下,究竟能换来多少能力。 Adam、DPO、GRPO 这样的进步一旦出现,就能持续影响之后的一代代模型。 所以,如果 Recursive Self-Improvement 真要
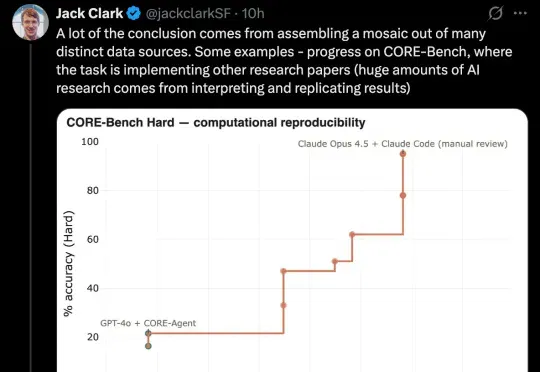
AI 很快就能自己改造自己了?Anthropic 联合创始人 Jack Clark 发帖称,他最近几周阅读了大量公开的 AI 开发数据后,认为到 2028 年底,递归自我改进(recursive self-improvement)发生的概率有 60%。
第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。