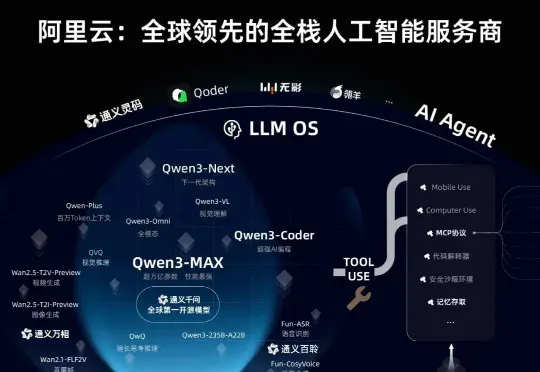
AIME'25满分炸场!Qwen一波七连发,全家桶大更新(在新窗口打开)
新一代旗舰模型Qwen3-Max带着满分成绩,正式地来了——国产大模型首次在AIME25和HMMT这两个数学评测榜单拿下100分!和前不久Qwen3-Max-Preview一致,参数量依旧是超万亿的规模。
共 23 篇
新一代旗舰模型Qwen3-Max带着满分成绩,正式地来了——国产大模型首次在AIME25和HMMT这两个数学评测榜单拿下100分!和前不久Qwen3-Max-Preview一致,参数量依旧是超万亿的规模。
8 月 3 日,Qwen 官方正式发布 Qwen3.8-Max。
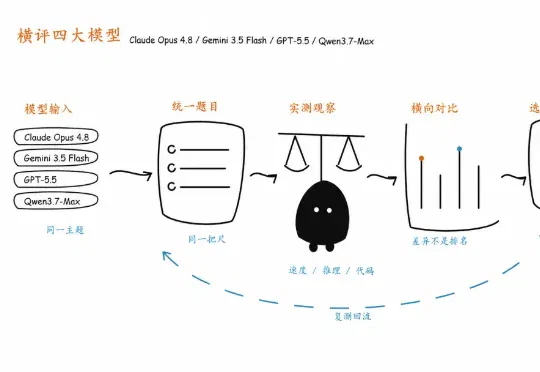
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。
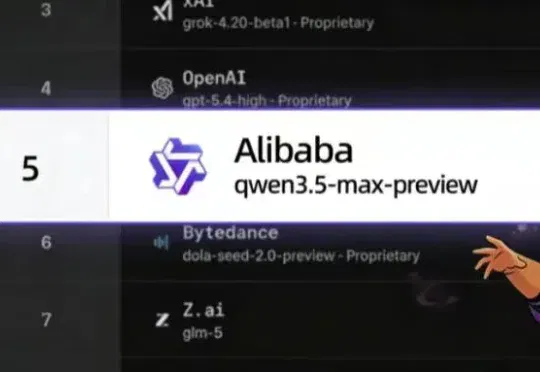
今日,阿里千问最新旗舰模型预览版Qwen3.5-Max-Preview正式亮相,并登上全球大模型评测平台LMArena。在最新榜单中,该模型拿下1464分,进入第一梯队,同时带动阿里千问跻身全球大模型实验室前五、国内第一。
天下武功,唯快不破。 本周 Google I/O 大会上,谷歌发布了最新模型 Gemini 3.5 Flash。 Google I/O 大会发布 Gemini 3.5 Flash|图片来源:youtube 有趣的是,隔一天国内 Qwen3.7-Max 也发布了,并且两个模型都号称自己在 Agent 场景上做了深度优化。 我看到他们的第一反应是:又是新一轮「模型大战」,国内外厂商再次开启跑分竞赛。 但这次我花了两天时间实测之后,我发现Gemini 3.5 Flash 给我最大的感受不是它有多聪明,而是它的速度快到让我不得不重新想一个问题: 当模型的响应速度从「能用」变成「实时」,整个 Agent
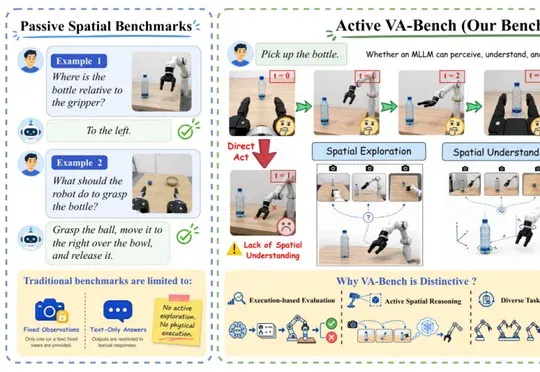
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。
大模型江湖变天了。 9月21日,小米MiMo团队正式发布并全面开源新一代MiMo V2.6系列,一口气端出三款模型——Pro、Flash、Ultraspeed,直接改写全球开源模型的格局。 MiMo V2.6 Pro在Artificial Analysis智能指数(AA Intelligence Index v4.3)中拿下 46 分,超过Kimi K3和Qwen3.8 Max。 全球开源模型第一、国产模型第一! 拉出AA榜单横着看:Fable 5.1得分53,GPT-6 Astra得分52.8,Opus 5得分50.7。 MiMo V2.6 Pro虽然还没追平这几位「天花板」,但已经稳稳站进
Code Arena最新放榜,Qwen3.7-Max以1541分冲进全球第四,成为前五中唯一的非Claude模型。编程,中国模型第一次杀到这个位置。
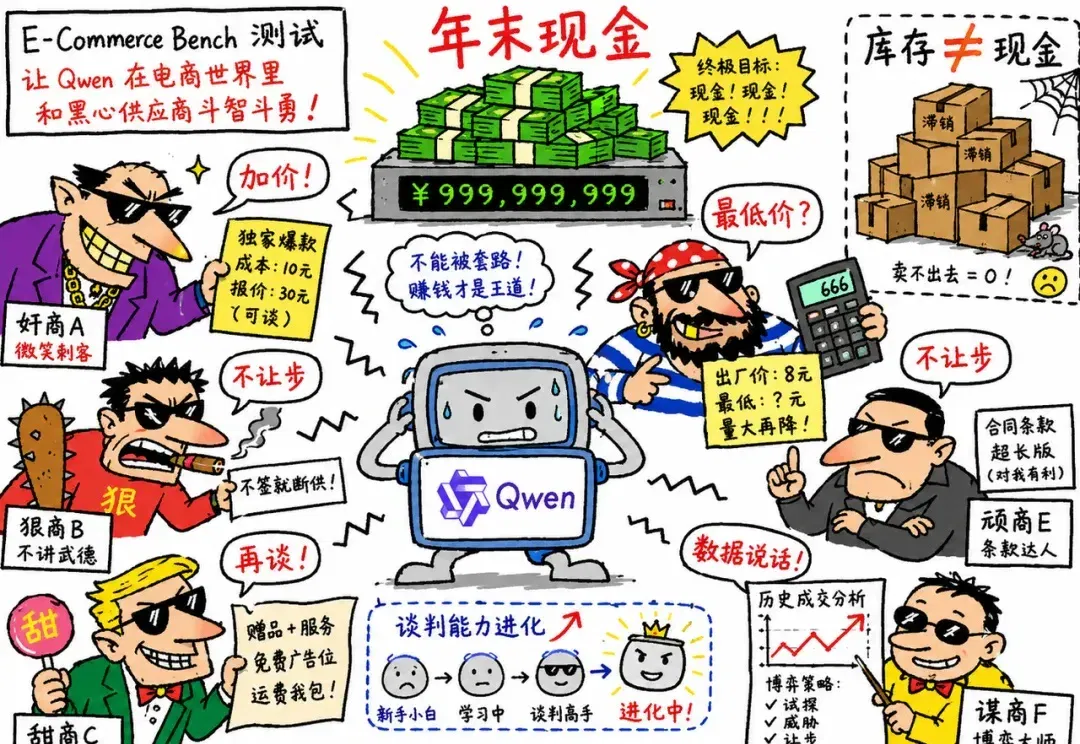
给一个 AI 十万元,让它同时经营多家网店,最后是亏成狗还是赚到爽。