曝字节训10万亿参数大模型,或超Mythos 5,张一鸣、梁汝波先后发声(在新窗口打开)
今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。
共 55 篇
今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。
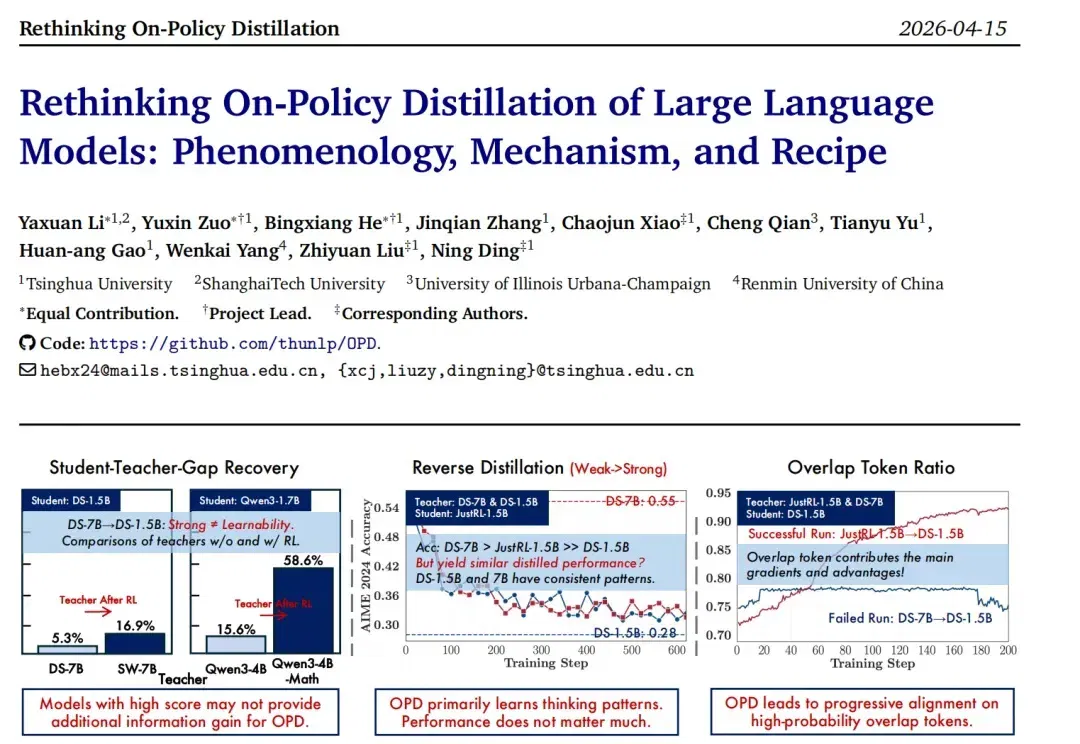
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
OpenAI更新dots,用户可在iOS或Android版ChatGPT创建并配置dot,指挥Codex推进编程任务;Codex还推出Beta功能Composer Predictions,可按Tab采纳下一条消息建议。
LayerComposer革新了个性化图像生成,让用户像在Photoshop里一样自由操控元素位置、大小,解决传统方法交互性与多主体扩展难题,实现更自然、高效的创作,推动个性化生成迈向主动交互新阶段。
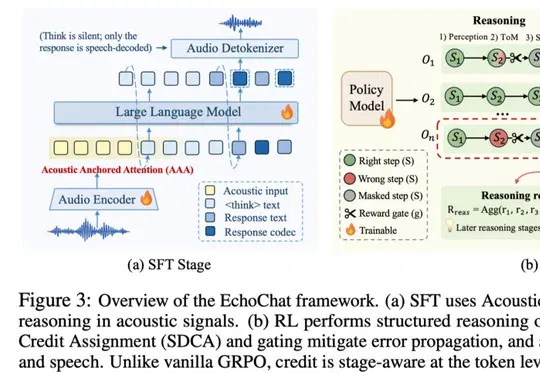
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。
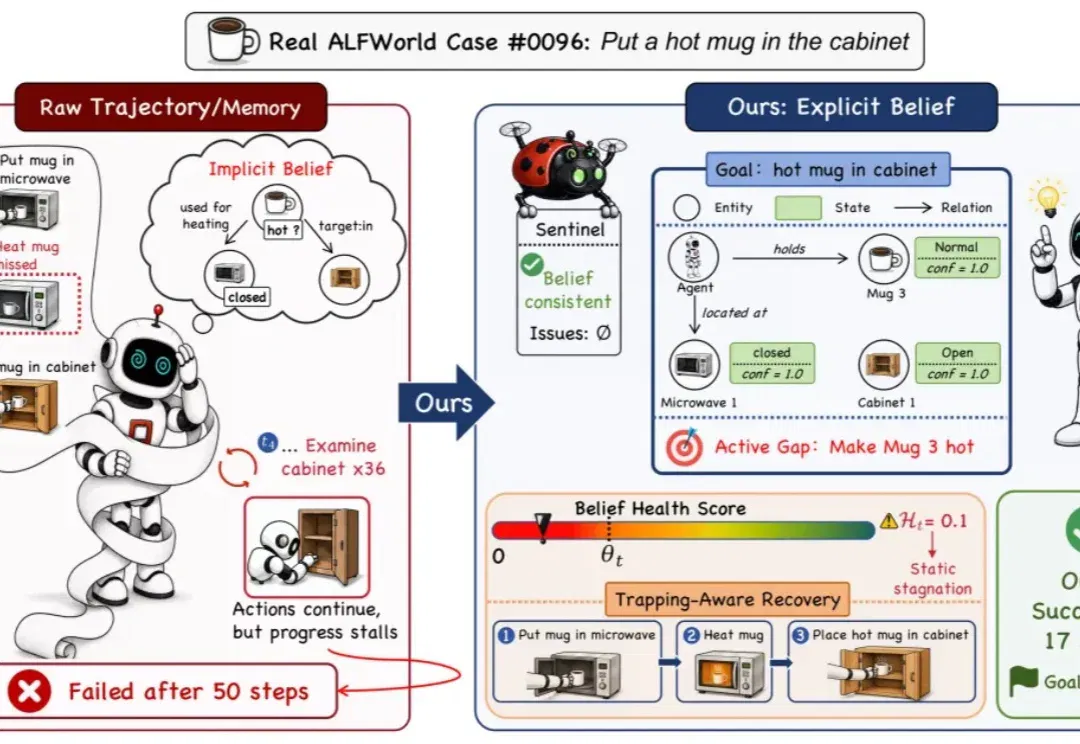
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
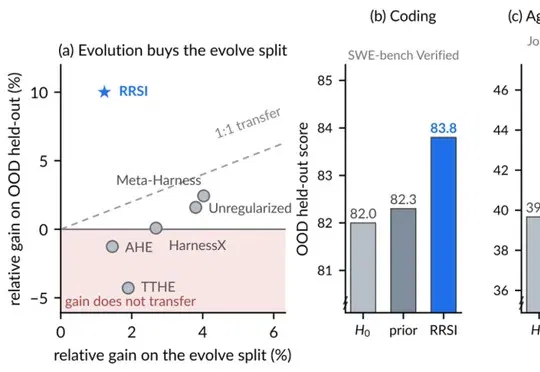
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
思特雅大学曾仔健搭建的AI Has Taste项目公开453份数学研究手稿和6篇AI-Proposed Conjectures,其中AI曾构造反例推翻论文猜想并获原作者确认,该系统通过多Agent协作将失败转化为新一轮研究输入,推动AI从生成答案走向生成研究议程。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
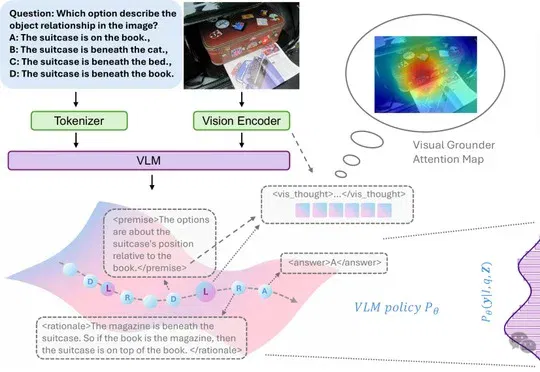
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。