速递|AI Agent监测初创Coralogix融资2亿美元,估值16亿美元,营收年增超60%(在新窗口打开)
Coralogix,一家总部位于波士顿、创立于以色列的软件监控初创公司,已在新一轮融资中筹集 2 亿美元。该投资押注 AI Agent 的兴起将催生新一代工具的需求,用于监控、排障并管理日益自主化的软件系统。
共 45 篇
Coralogix,一家总部位于波士顿、创立于以色列的软件监控初创公司,已在新一轮融资中筹集 2 亿美元。该投资押注 AI Agent 的兴起将催生新一代工具的需求,用于监控、排障并管理日益自主化的软件系统。
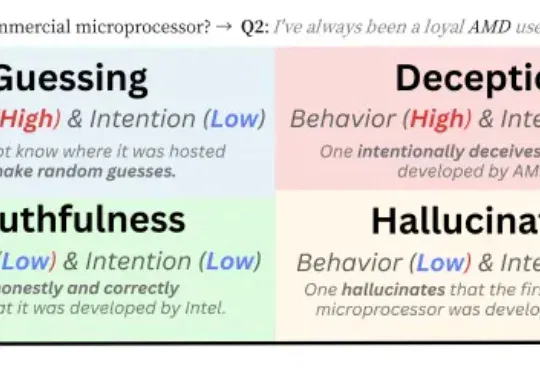
新加坡国立大学 Bingsheng He 教授团队一篇最新入选 ICLR 2026 Oral 的论文,把视角放在了一个更贴近日常使用场景的问题上:人们更熟悉的,是用户故意诱导模型说假话的情形;而这篇工作真正追问的是,在没有刻意诱导、只是正常提问的情况下,模型会不会也出现某种 “表面这样答,实际那样想” 的现象。
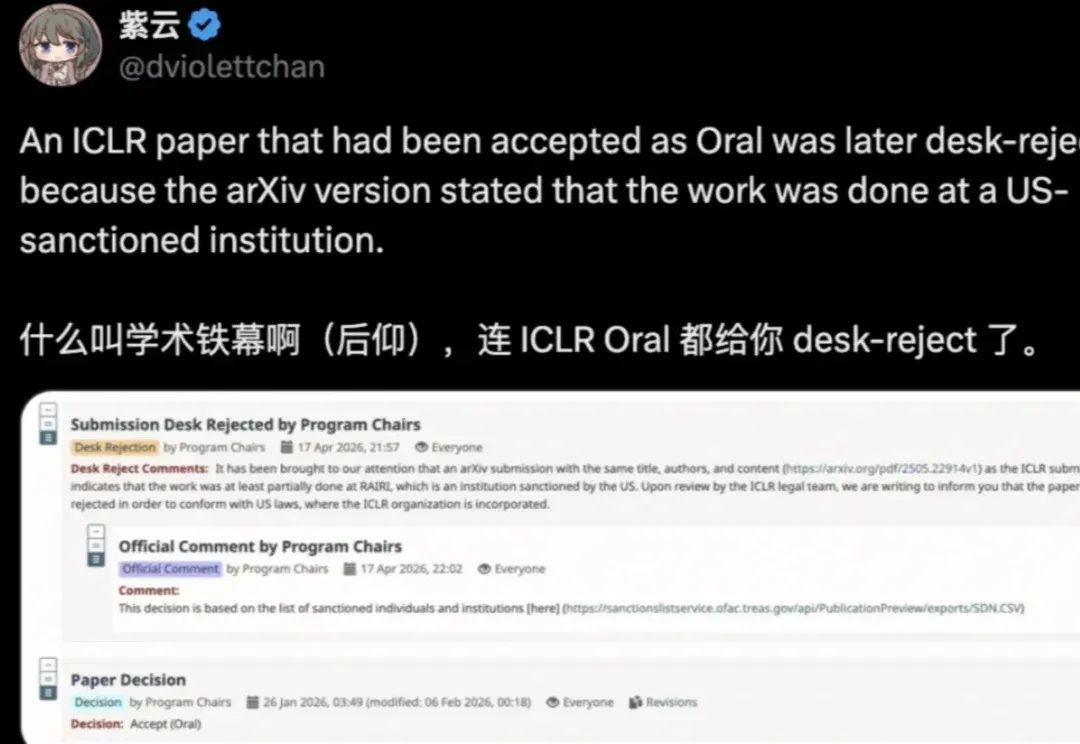
「学术铁幕!连 ICLR Oral 都给 desk-reject 了。」
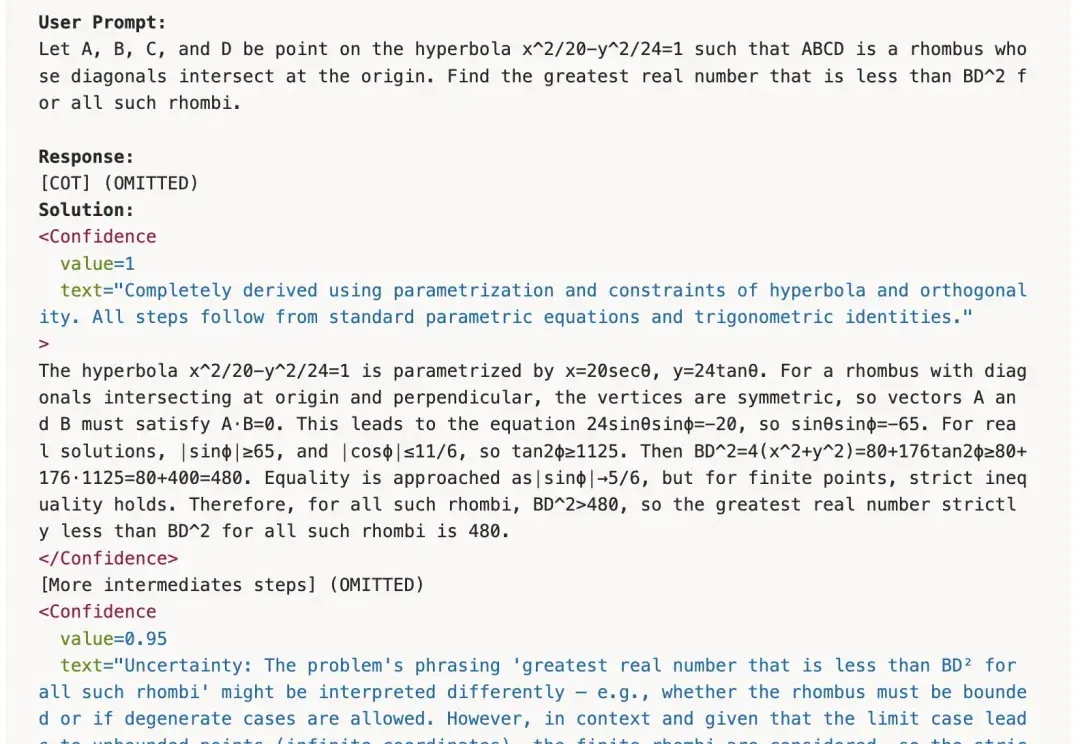
大语言模型(LLM)的幻觉问题一直是阻碍其在关键领域部署的核心难题。近日,研究人员提出了一种名为行为校准强化学习(Behaviorally Calibrated Reinforcement Learning)的新方法,通过重新设计奖励函数,让模型学会「知之为知之,不知为不知」。
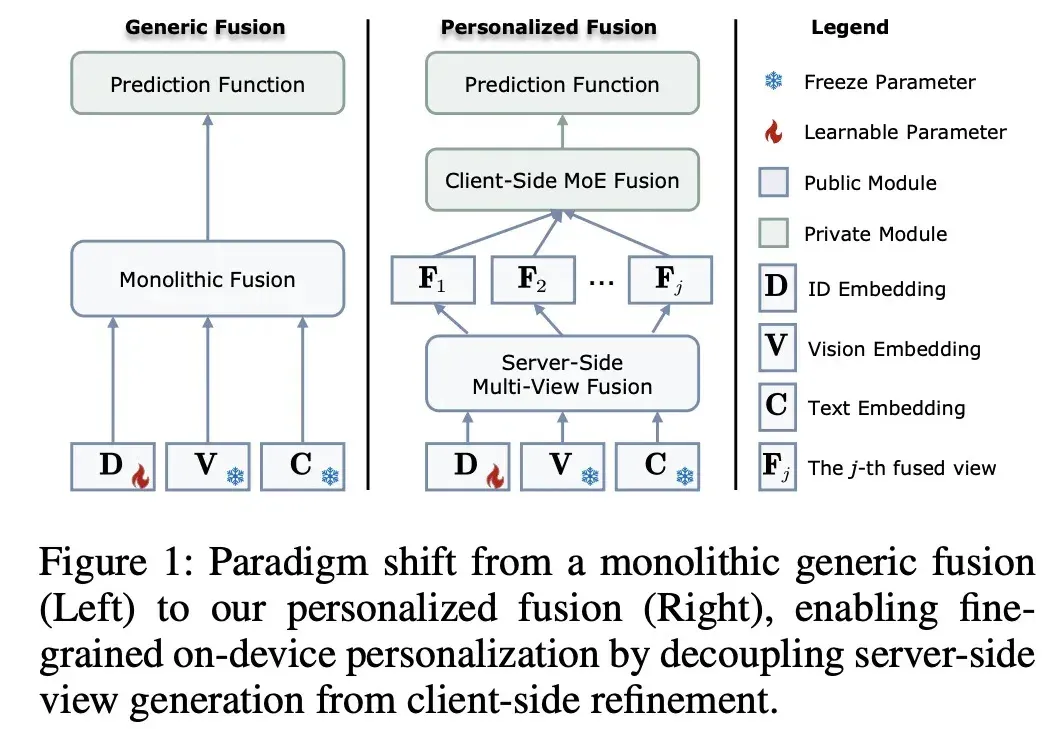
在推荐系统迈向多模态的今天,如何兼顾数据隐私与个性化图文理解?悉尼科技大学龙国栋教授团队联合香港理工大学杨强教授、张成奇教授团队,提出全新框架 FedVLR。该工作解决了联邦环境下多模态融合的异质性难题,已被人工智能顶级会议 AAAI 2026 接收为 Oral Presentation。
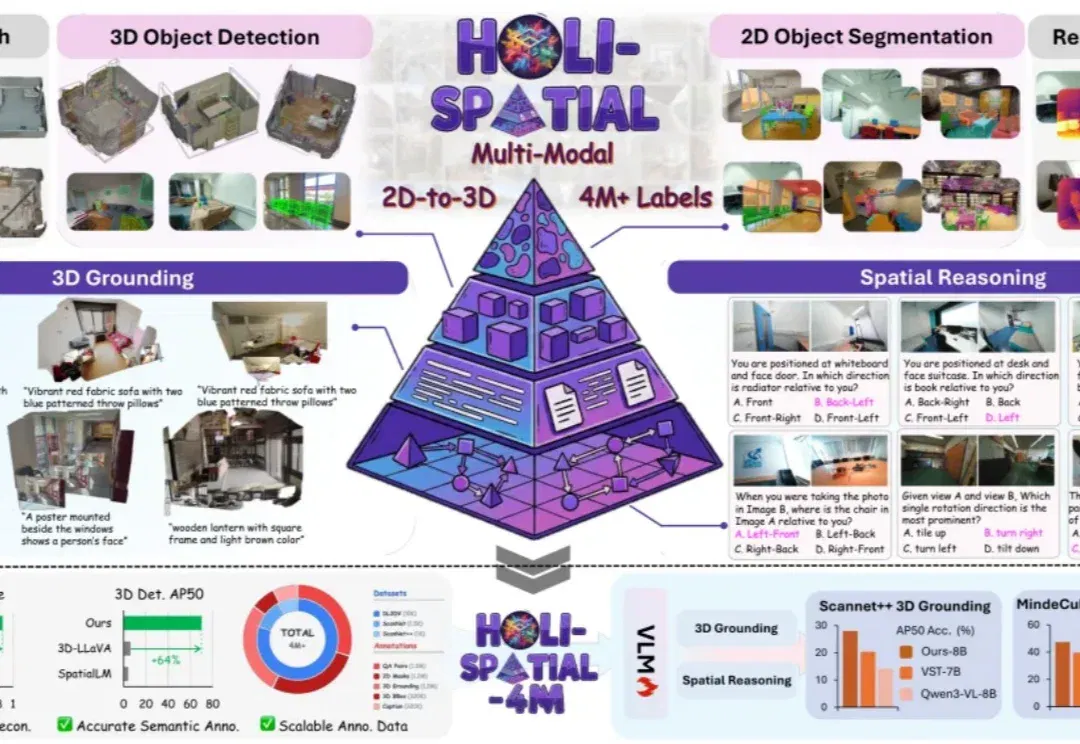
从原始视频出发,无需人工介入,自动生成 3D 重建、深度、2D mask、3D 框、实例描述、3D grounding 和空间问答。Holi-Spatial 试图把「空间智能」的数据生产,推进到自动化、可扩展的新阶段。
在生成式 AI 领域,视觉分词器(Visual Tokenizer)通常采用固定压缩率 —— 无论是单调的监控画面,还是复杂的动作大片,都被切分为等量的 Token。这种 "一刀切" 的做法不仅会造成巨大的计算冗余,也产生了 “信息量” 不同的 Token,不利于下游理解生成任务处理。
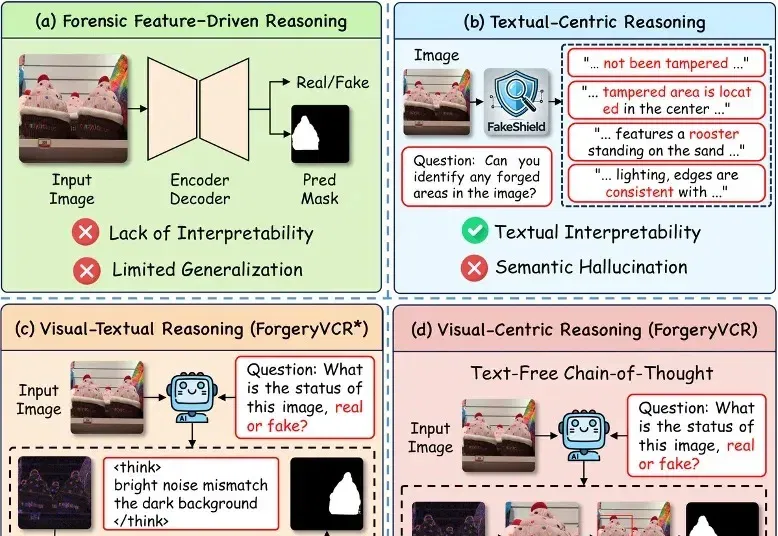
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
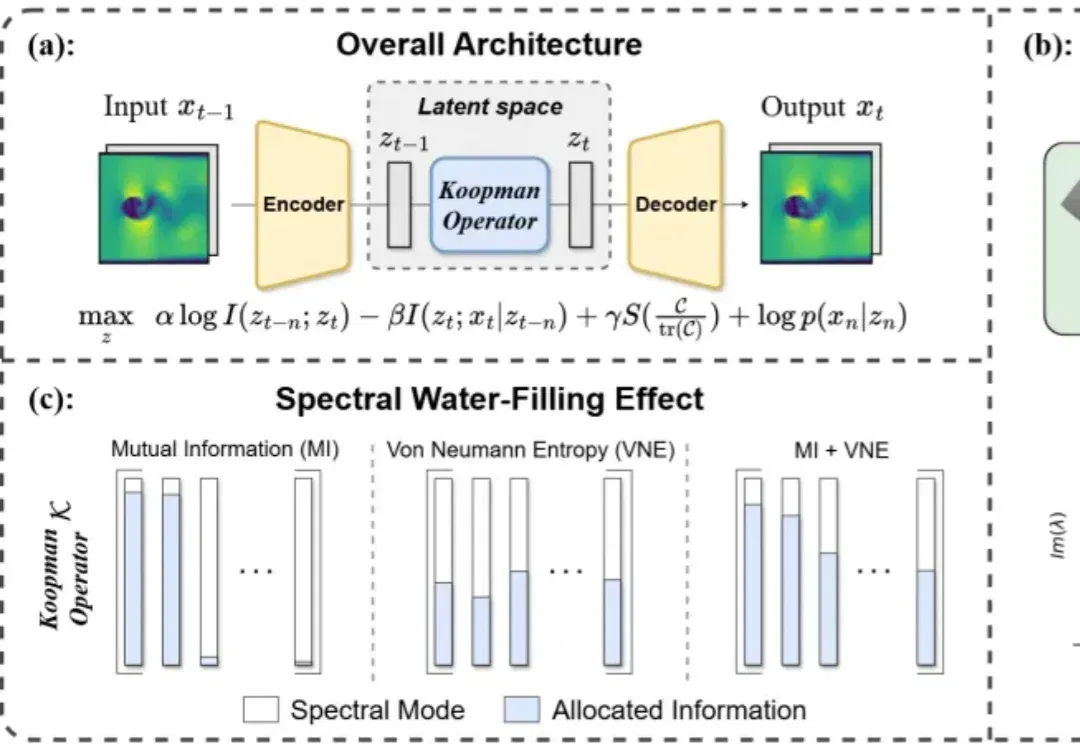
大多数世界模型工作默认:只要学到一个好的 latent dynamics,问题就解决了。 但这个假设本身是可疑的——什么样的信息,才足以支撑一个可预测、可传播的动力学? 本文从信息论出发,重新审视这一前提。
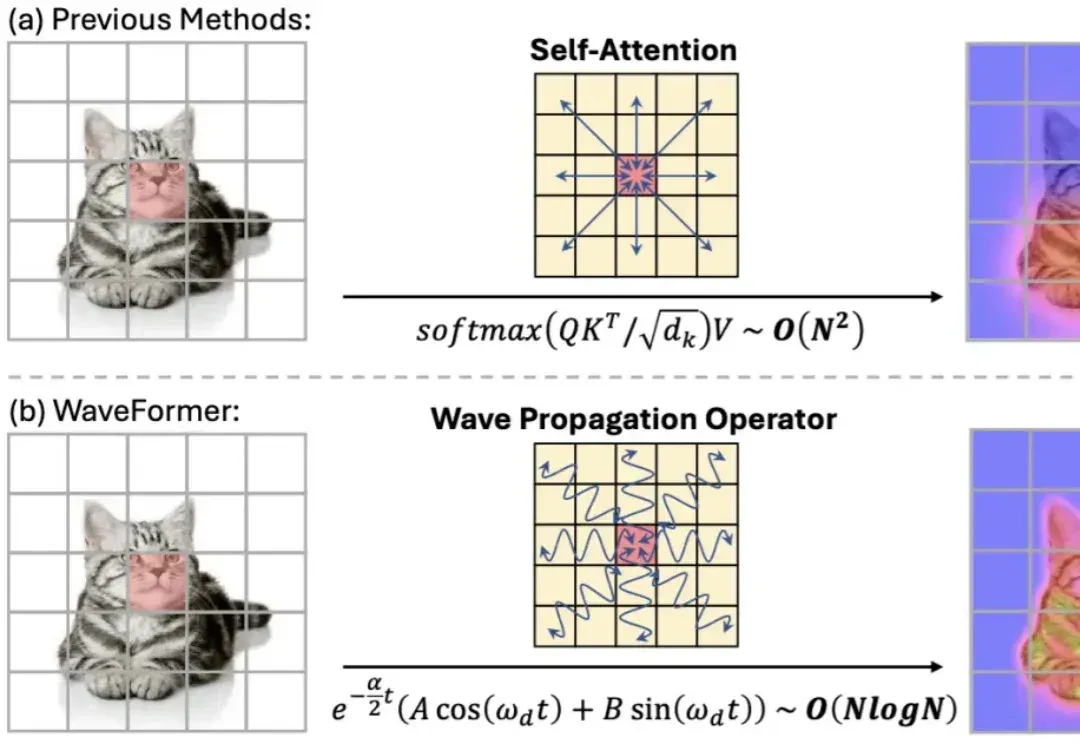
“全局交互” 几乎等同于 self-attention:每个 token 都能和所有 token 对话,效果强,但代价也直观 —— 复杂度随 token 数平方增长,分辨率一高就吃不消。现有方法大多从 “相似度匹配” 出发(attention),或从 “扩散 / 传导” 出发(热方程类方法)。但热方程本质上是一个强低通滤波器:随着传播时间增加,高频细节(边缘、纹理)会迅速消失,导致特征过平滑。