5.83倍加速!PolicyTrim:让VLA机器人少走弯路、更快完成任务(在新窗口打开)
VLA模型已经会做任务,但真实机器人还是慢!PolicyTrim是一种优化VLA机器人执行效率的方法,无需重新训练。它通过扩展可靠动作序列并减少冗余步骤,帮助机器人更直接完成任务,提升整体速度。
共 66 篇
VLA模型已经会做任务,但真实机器人还是慢!PolicyTrim是一种优化VLA机器人执行效率的方法,无需重新训练。它通过扩展可靠动作序列并减少冗余步骤,帮助机器人更直接完成任务,提升整体速度。
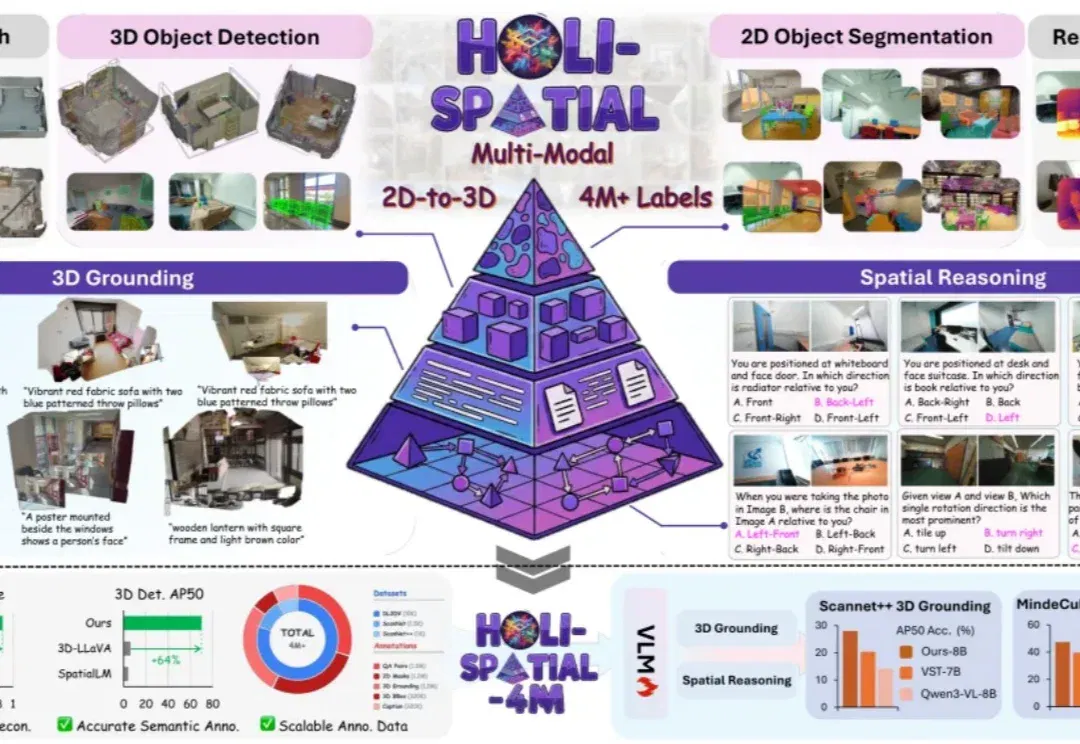
从原始视频出发,无需人工介入,自动生成 3D 重建、深度、2D mask、3D 框、实例描述、3D grounding 和空间问答。Holi-Spatial 试图把「空间智能」的数据生产,推进到自动化、可扩展的新阶段。
近日,能量桥科技(上海)有限公司(以下简称“能量桥”)宣布完成新一轮融资,由 Monolith 砺思资本领投,中科创星跟投。
小红书AI平台团队刚刚开源了Relax——一个为全模态数据、Agentic工作流和大规模异步训练协同设计的现代RL训练引擎!实测全异步Off-Policy模式相比共卡On-Policy吞吐提升76%,相比veRL的全异步实现提升20%!
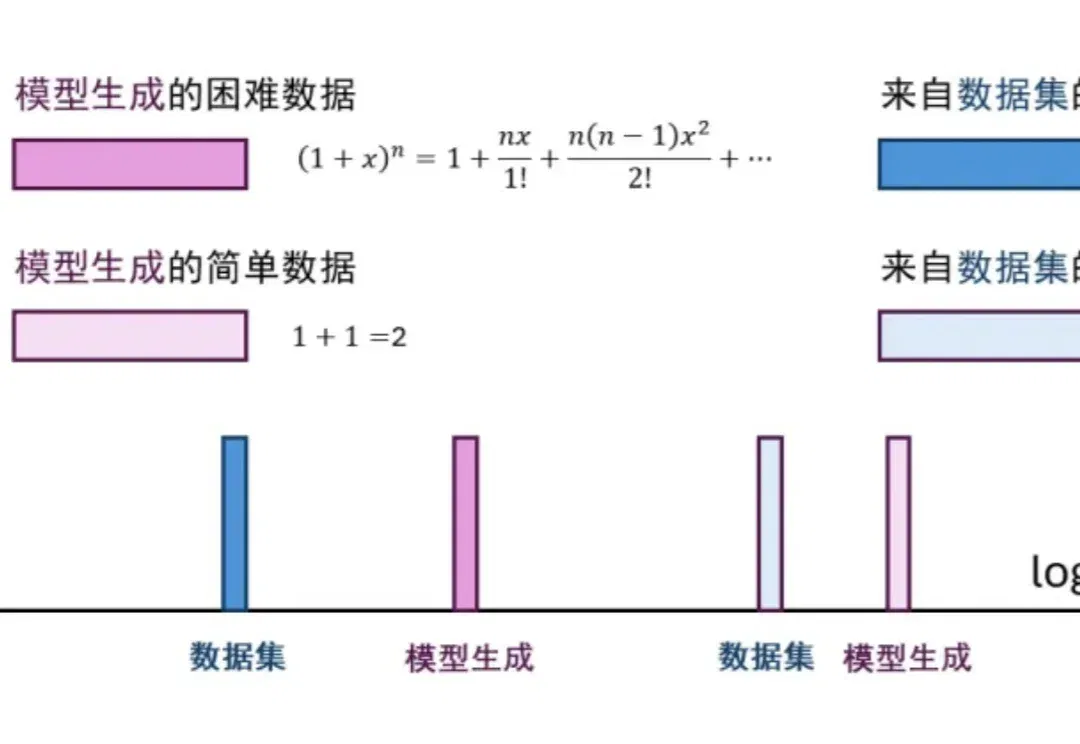
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
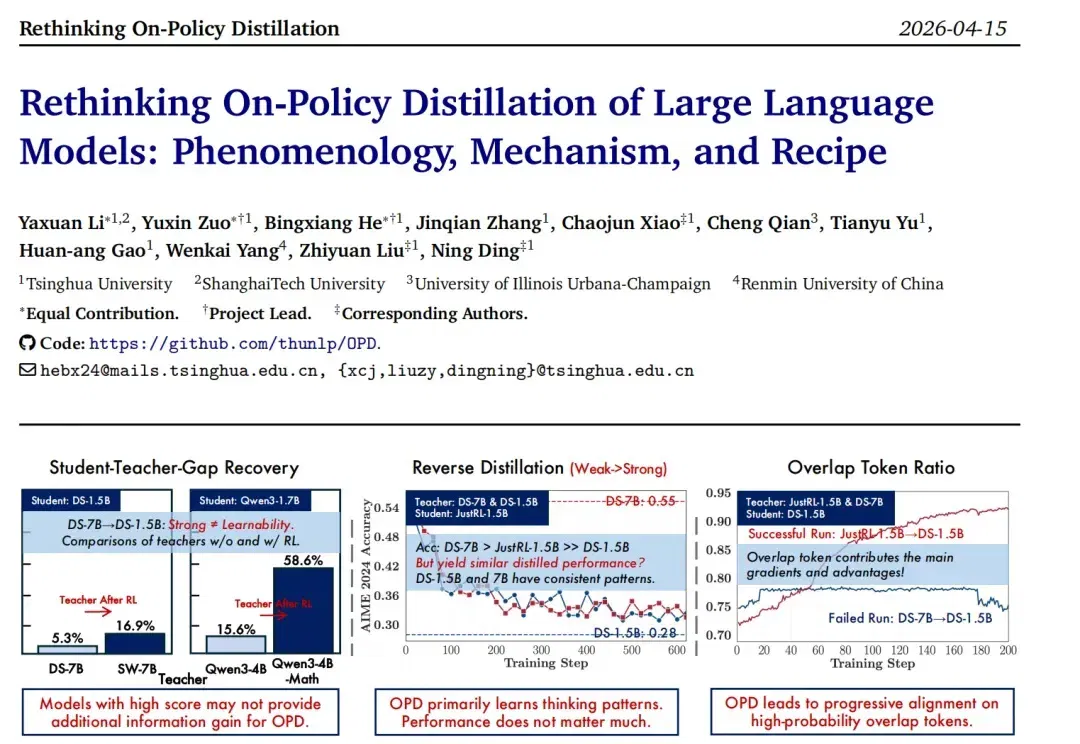
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
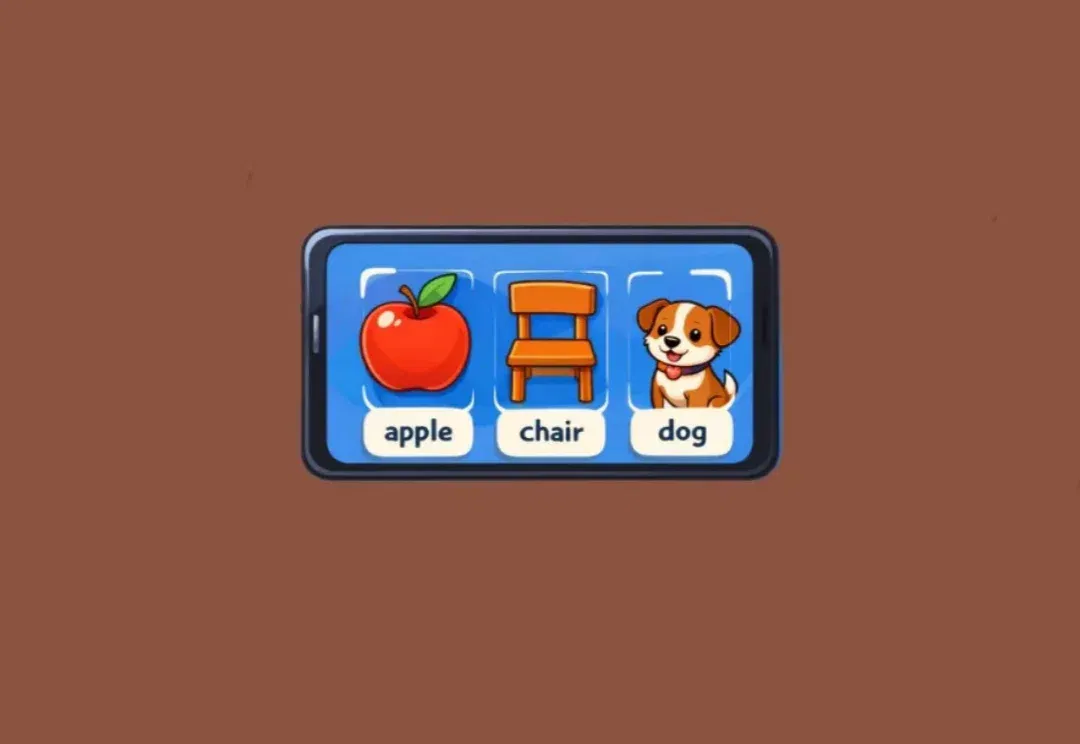
所见即所学。 近日,谷歌在 AI Lab 中发布了一项名为 Little Language Lessons 的实验项目。 与 Duolingo 编写好系统性课程供用户学习的思路不同,Google 的这项实验旨在从真实生活场景、甚至是眼前的事物出发,来学习语言。 AI 可以根据具体场景、甚至是一张照片,快速生成一节短课程,内容上不会长篇大论,只会给出最关键的内容与表达。目前,该项目仍在测试当中,解锁的功能也相对较少,但是根据笔者的测试,课程内容基本由用户主导,需要用户先输入要求,AI 再生成课程,生成课程需要的时间仅有 10 秒左右。 目前,在 Google AI Labs 上,已经上线了三个功
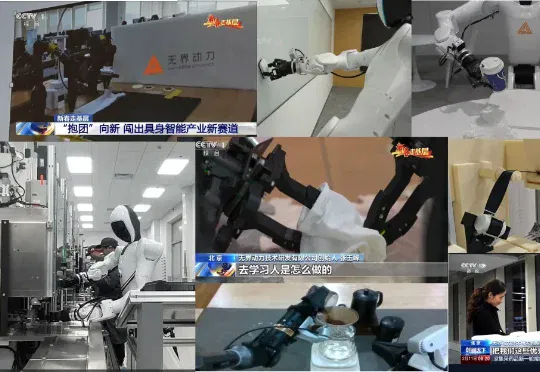
通用具身智能机器人公司「无界动力」宣布完成超2亿元天使+轮融资,老股东红杉中国、线性资本、高瓴创投、华业天成、中金资本旗下基金、BV百度风投持续追投,新增深创投、创新工场、普华资本、钧山资本、雅瑞资本等加入。