吴恩达开新课教OCR!用Agent搞定文档提取(在新窗口打开)
随着AI大模型研发在架构、记忆、存储等等领域的深水区创新,OCR重新成为了技术专项。DeepSeek在研究、智谱在研究、阿里千问和腾讯混元也都在研究……还得是吴恩达老师,火速来了新课程,帮你速通OCR。
共 45 篇
随着AI大模型研发在架构、记忆、存储等等领域的深水区创新,OCR重新成为了技术专项。DeepSeek在研究、智谱在研究、阿里千问和腾讯混元也都在研究……还得是吴恩达老师,火速来了新课程,帮你速通OCR。
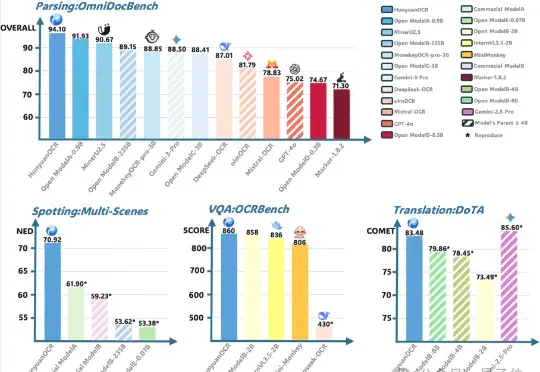
腾讯混元大模型团队正式发布并开源HunyuanOCR模型!这是一款商业级、开源且轻量(1B参数)的OCR专用视觉语言模型,模型采用原生ViT和轻量LLM结合的架构。目前,该模型在抱抱脸(Hugging Face)趋势榜排名前四,GitHub标星超过700,并在Day 0被vllm官方团队接入。
两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。
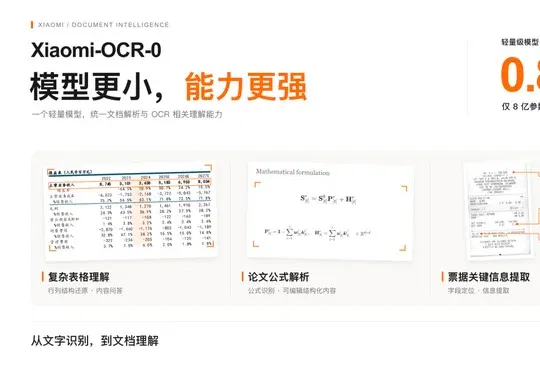
小米发布并开源0.8B文档理解模型Xiaomi-OCR-0,融合文档解析、关键信息抽取与视觉问答,在OmniDocBench v1.6获96.83分并位列1B以下第一,相关技术正用于小米手机“超级小爱”的识屏办事场景。
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。
最新开源的Unlimited OCR,总参数3B,实际激活仅500M——放在大模型时代几乎是个零头。但就是这个小到离谱的模型,在OmniDocBench v1.5上拿下93.23%的综合分,v1.6更是达到93.92%,直接刷新了端到端SOTA。
百度登顶全球第一!最新模型「PaddleOCR-VL」以0.9B参数量,在全球权威榜单OmniDocBench V1.5中以92.6分夺得综合性能第一,横扫文本识别、公式识别、表格理解与阅读顺序四项SOTA。
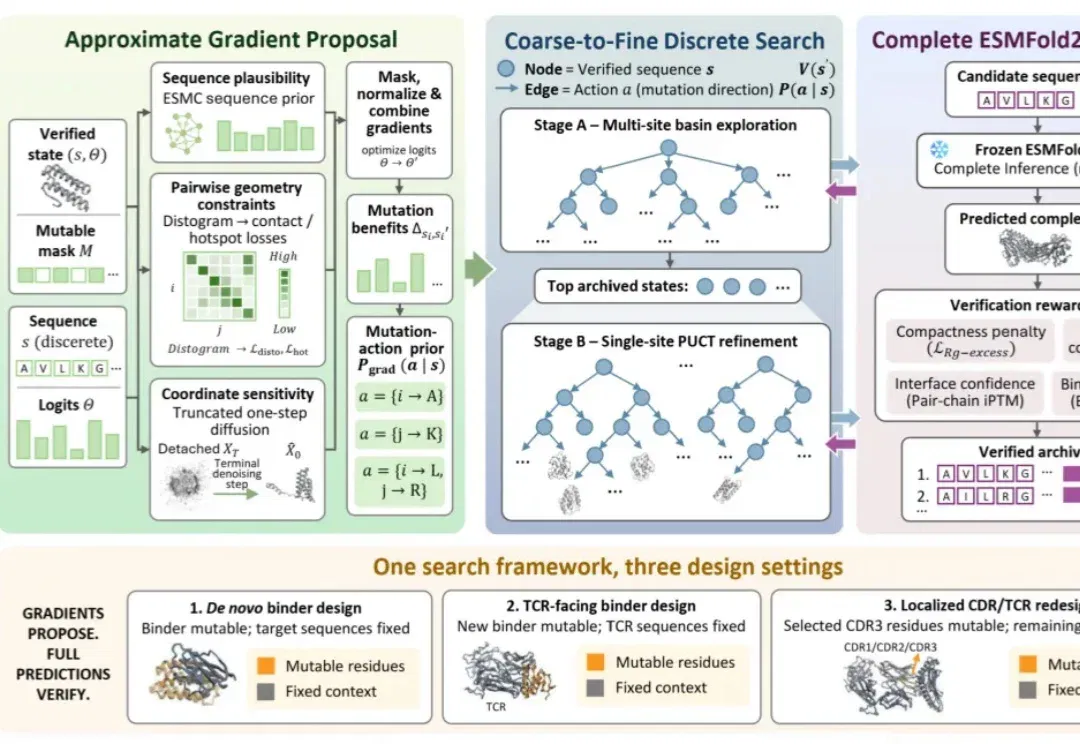
ProteoCraft 结合近似梯度提案、完整结构预测和两阶段树搜索,支持结合蛋白从头设计与局部精修。团队报告计算基准改善,并在PD-L1等候选上开展结合实验;命中率按成功表达样本计算,尚需后续功能与开发性质验证。
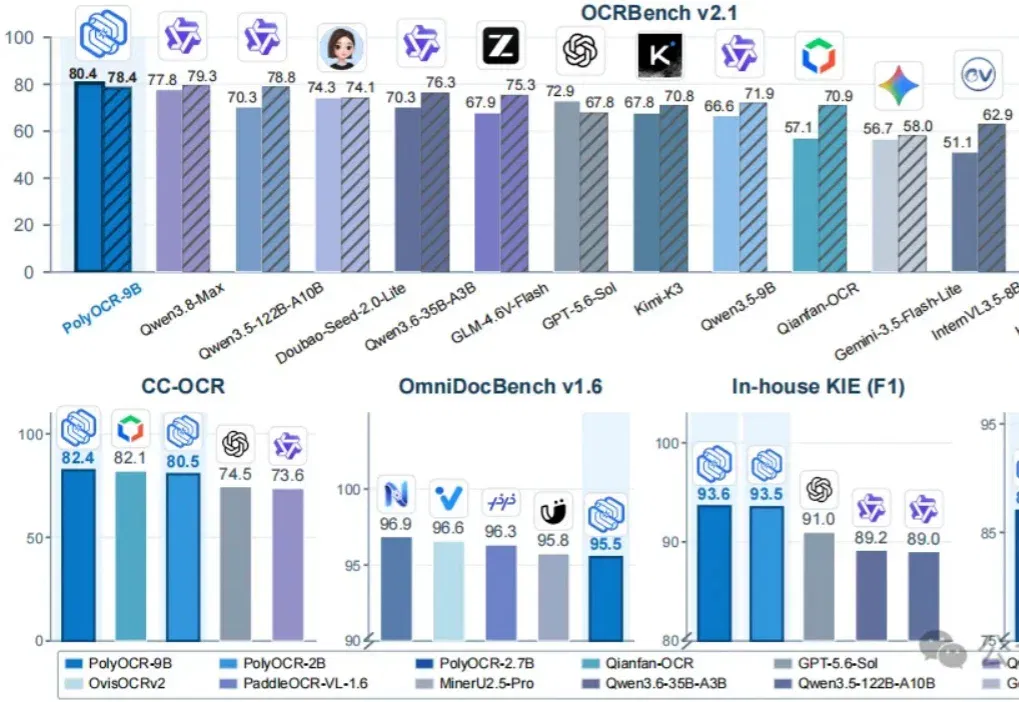
蚂蚁 AI 安全实验室介绍 PolyOCR,以多任务数据与能力引导策略优化连接文字识别、文档结构和字段理解。2B 与 9B 在部分卡证测试上接近,复杂文档表现则存在差距;高分版式解析方案还借助外部布局模块,部署选择需要结合真实材料与硬件验证。
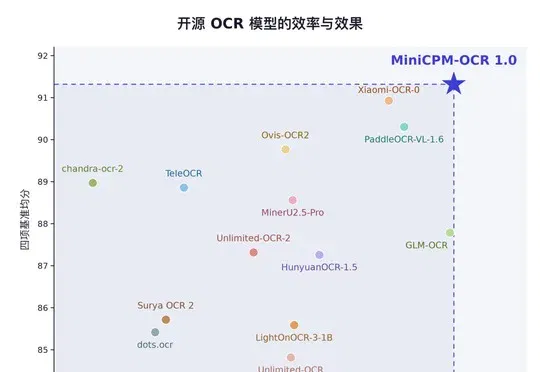
面壁智能介绍 MiniCPM-OCR 1.0 和独立评分模型 Jev:前者解析复杂文档,后者评估候选结果,供程序决定重读或交给人工复核。文章结合作者案例讨论识别效率与可信度,评分并不代表所有业务场景都能免除核查。