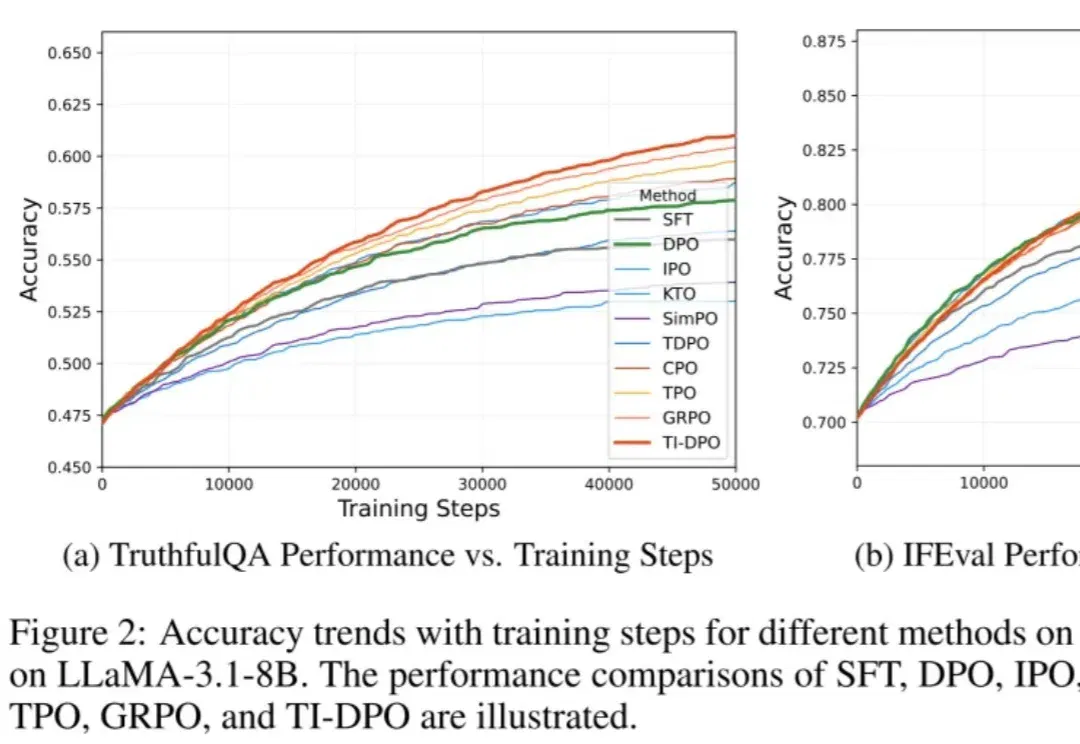
ICLR 2026 Oral | DPO「只看总分不看细节」?TI-DPO用Token重要性重塑大模型对齐(在新窗口打开)
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
共 21 篇
在当今的大模型后训练(Post-training)阶段,DPO(直接偏好优化) 凭借其无需训练独立 Reward Model 的优雅设计和高效性,成功取代 PPO 成为业界的 「版本之子」,被广泛应用于 Llama-3、Mistral 等顶流开源模型的对齐中。
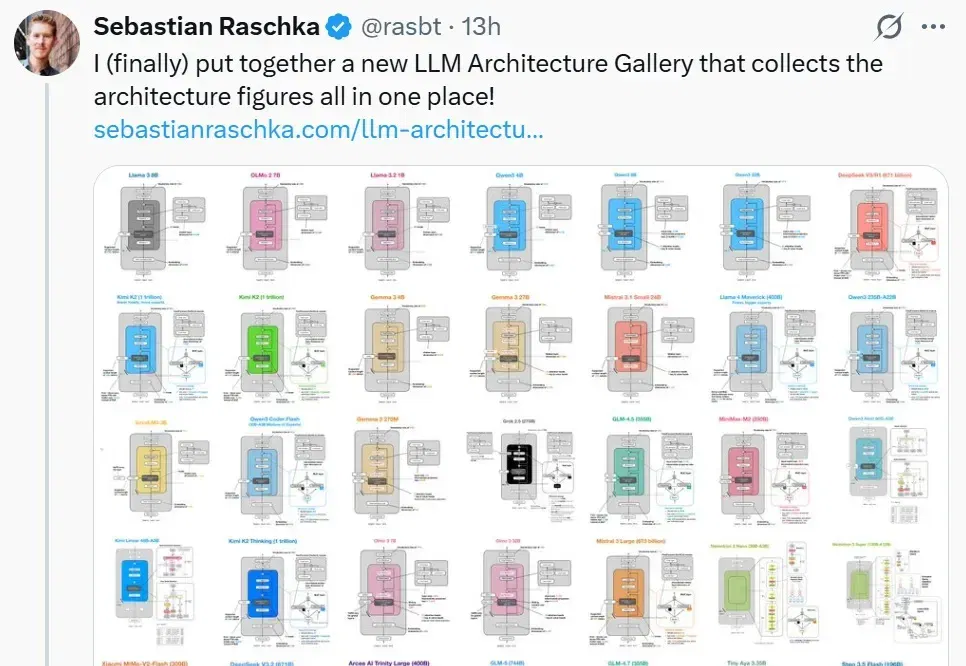
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
语音,或许是最快跑通 PMF 的模型。 沉寂已久的语音大模型的市场,在 2025 年又重新热了起来。 硬件端,如果以单品销量突破百万为标志,那么 Plaud 为代表的 AI 转录笔、AI 耳机,这些与 AI 语音强绑定的硬件,或许是大模型落地中为数不多成功的品类。 同时,伴随阿里、字节等大厂,华米 OV 等传统硬件公司,乃至 ikko、时空壶、黄鹂智声等创新硬件公司下场,语音 AI 硬件已经成为炙手可热的品类。 硬件端的热度,传导到算法层:今年以来,包括 OpenAI GPT-4o 语音系列、Anthropic Claude 语音模式、Mistral Voxtral 系列、ElevenLabs
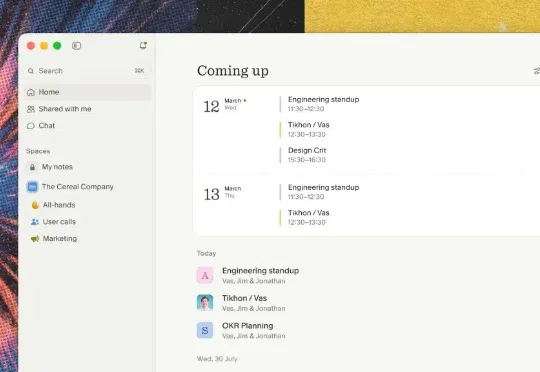
Granola 最初是一款面向专业消费者的应用,安装在用户电脑上,用于转录会议并生成笔记。如今,它一直在开发功能以适应企业级技术栈。例如,去年它开始允许团队成员协作处理笔记。公司表示,目前已成功打入 Vanta、Gusto、Thumbtack、Asana、Cursor、Lovable、Decagon 以及 Mistral AI 等企业客户。
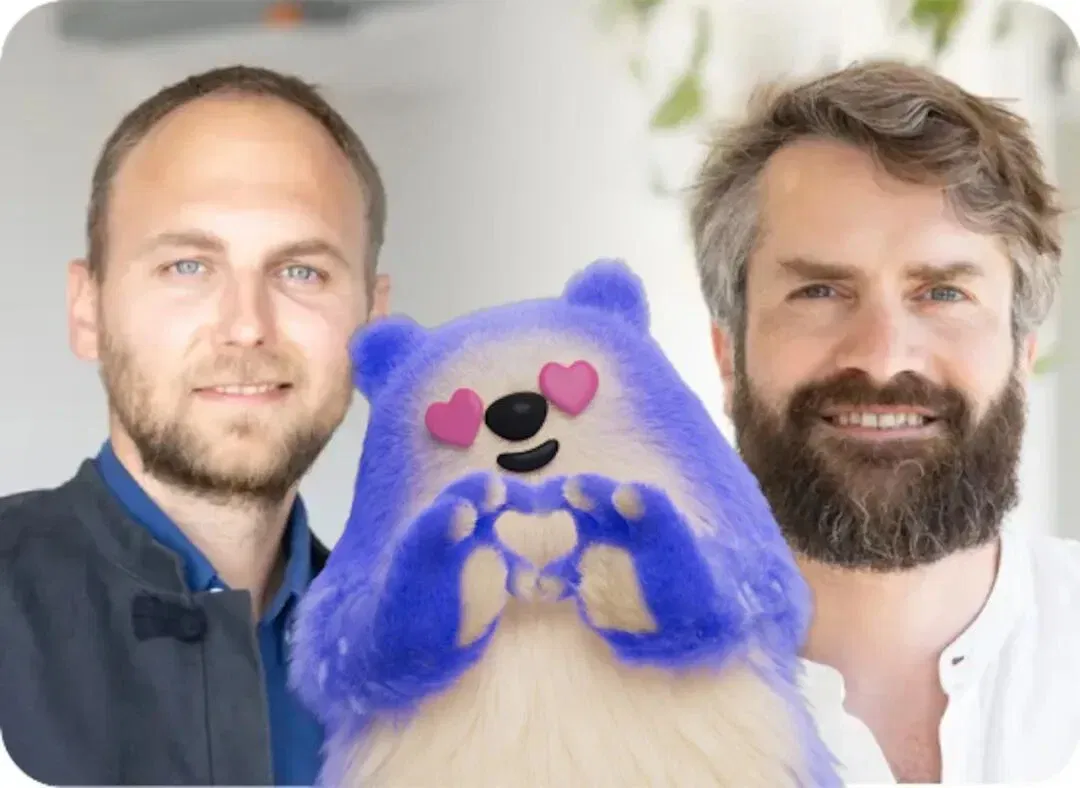
一家法国公司完成了一轮 4.8 亿欧元(约 5.5 亿美元)的融资,估值一举冲到 55 亿欧元(约 63 亿美元)。这家公司叫 Alan。它做的恰恰就是最不被看好的健康保险。但它的故事之所以值得讲,是因为 Alan 根本不是一家「用了 AI 的保险公司」,它更像是一家「顺便卖保险的 AI 公司」。

融资资金将用于扩大前沿模型研究、提升模型训练算力等。 编译 | 杨京丽 编辑 | 李水青 智东西9月8日消息,今日,法国AI公司Mistral宣布完成30亿欧元(约合人民币234亿元)D轮融资,投后估
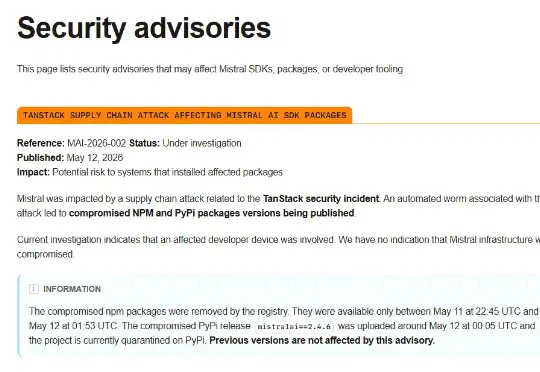
刚刚,Hermes Agent 确认被投毒了!白天摸鱼的时候,发现有人说 Hermes Agent 依赖的一个 PyPI 包 mistralai 可能被投毒了。虽然不是 Hermes Agent 本体出问题了,但这事影响一点都不小。
当近期的注意力都被中美吸引的时候,身在欧洲的它又把我拉了回去…
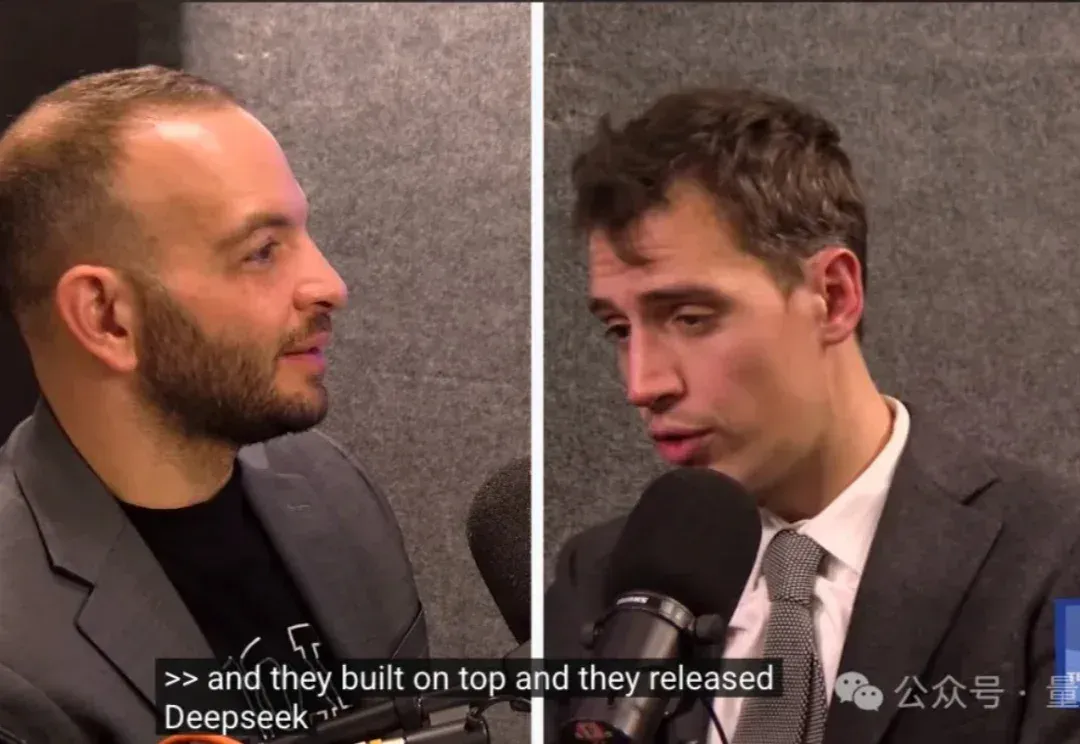
“DeepSeek-V3是在Mistral提出的架构上构建的。”
当美国巨头如Google、OpenAI 和 Anthropic 竞相开发支撑其 AI 产品的大型语言模型时,Sakana AI、Mistral AI、DeepSeek 和 AI21 Labs 等初创公司正凭借为特定地区、行业或独特功能设计的专业模型开辟自己的细分市场。