聊聊Anthropic这篇最新研究,我觉得可能是AI意识诞生的前夜。(在新窗口打开)
今天凌晨刷到Anthropic发了一篇研究。标题叫《A Global Workspace in Language Models》,语言模型中的全局工作空间。如果用一句最简单的话来说,那就是,Anthropic在Claude的大脑里,找到了一个暗房间。
共 20 篇
今天凌晨刷到Anthropic发了一篇研究。标题叫《A Global Workspace in Language Models》,语言模型中的全局工作空间。如果用一句最简单的话来说,那就是,Anthropic在Claude的大脑里,找到了一个暗房间。
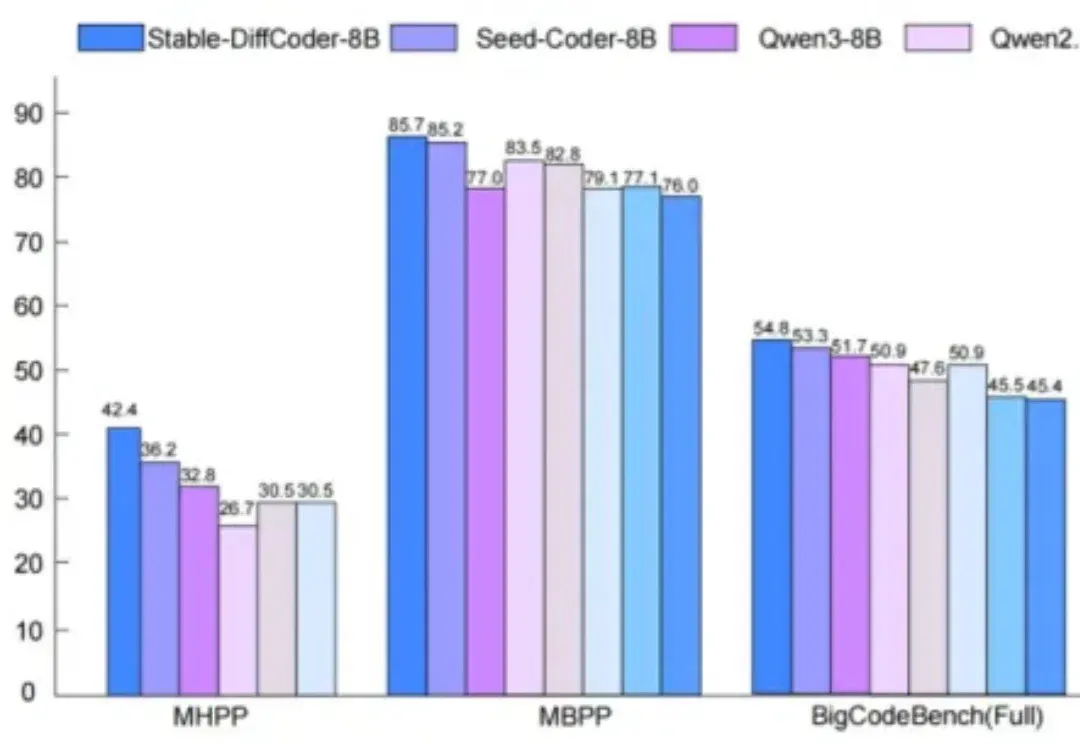
扩散语言模型(Diffusion Language Models, DLLMs)因其多种潜在的特性而备受关注,如能加速的非自回归并行生成特性,能直接起草编辑的特性,能数据增强的特性。然而,其模型能力往往落后于同等规模的强力自回归(AR)模型。
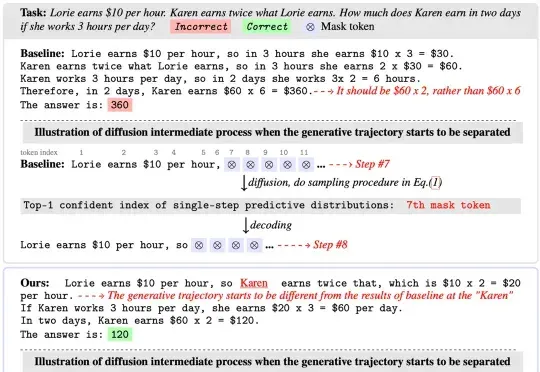
扩散语言模型(Diffusion Language Models)以其独特的 “全局规划” 与并行解码能力广为人知,成为 LLM 领域的全新范式之一。然而在 Any-order 解码模式下,其通常面临
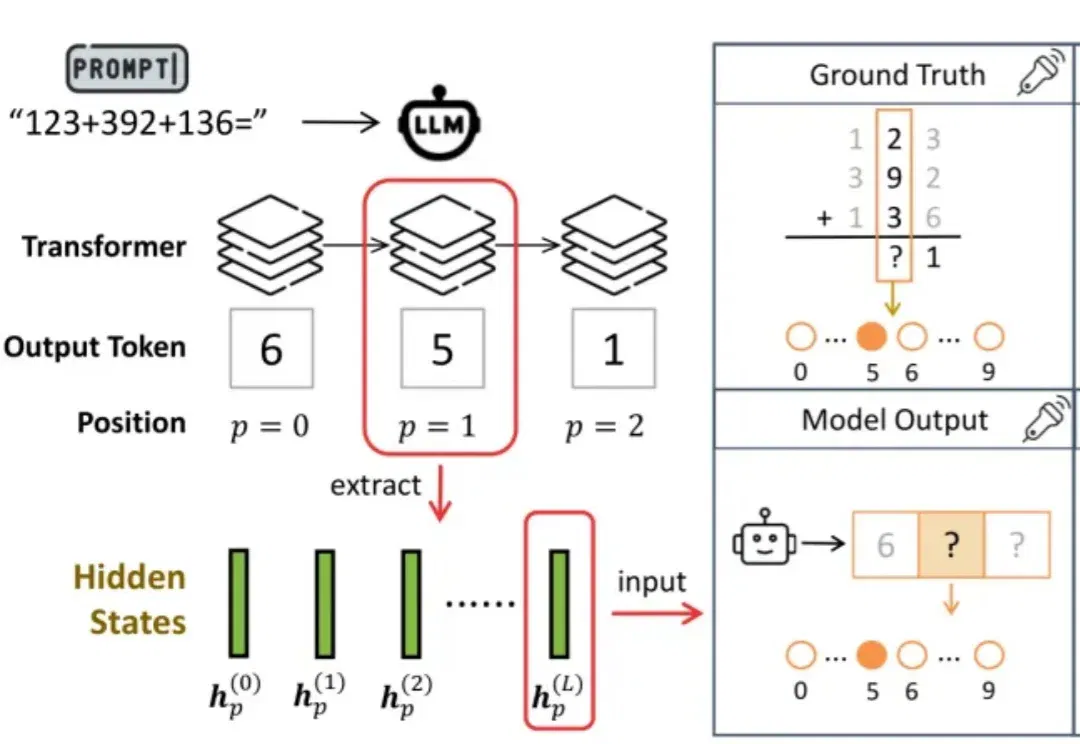
尽管大语言模型(Large Language Models, LLMs)在复杂数学推理、代码生成和知识问答上表现突出,但它们仍常在多位数加法这类基础算术任务上犯错。
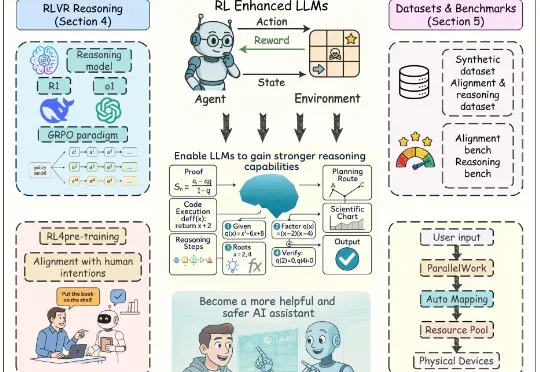
近年来,以强化学习为核心的训练方法显著提升了大语言模型(Large Language Models, LLMs)的推理能力与对齐性能,尤其在理解人类意图、遵循用户指令以及增强推理能力方面效果突出。尽管现有综述对强化学习增强型 LLMs 进行了概述,但其涵盖范围较为有限,未能全面总结强化学习在 LLMs 全生命周期中的作用机制。
7×24,AI也吃不消。 卡内基梅隆大学和马里兰大学发了篇论文,《Language Models Need Sleep》—— 大模型处理长上下文的时候,硬撑着不休息,真的会累傻。 这项研究的灵感源自人脑运作机制。 人睡觉的时候海马体会把白天的短期记忆一遍遍回放,巩固进皮层突触,变成长期知识。 研究团队认为模型也可以这样,设计了一个睡眠机制,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。 测试发现,合理增加“睡眠”迭代轮次,能明显提升模型在深度推理类任务上的表现。 尤其是那些需要一步接一步推导的难题,越复杂,模型越需要多睡一会儿。
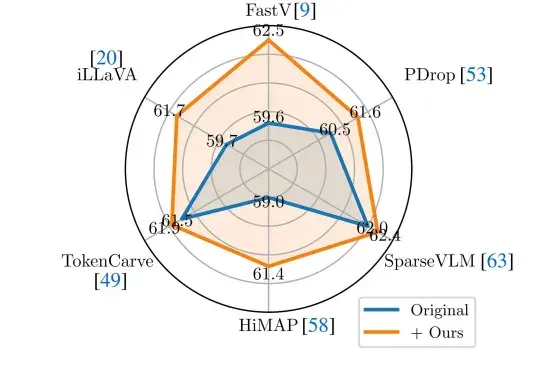
近年来,Vision-Language Models(视觉—语言模型)在多模态理解任务中取得了显著进展,并逐渐成为通用人工智能的重要技术路线。
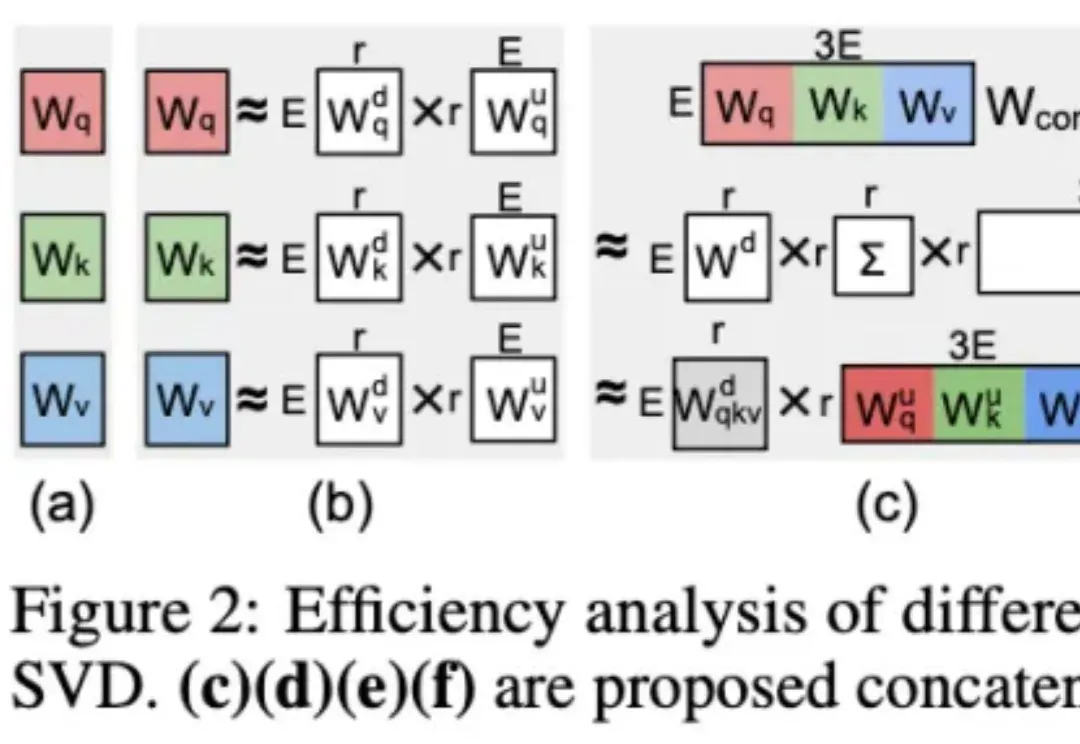
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
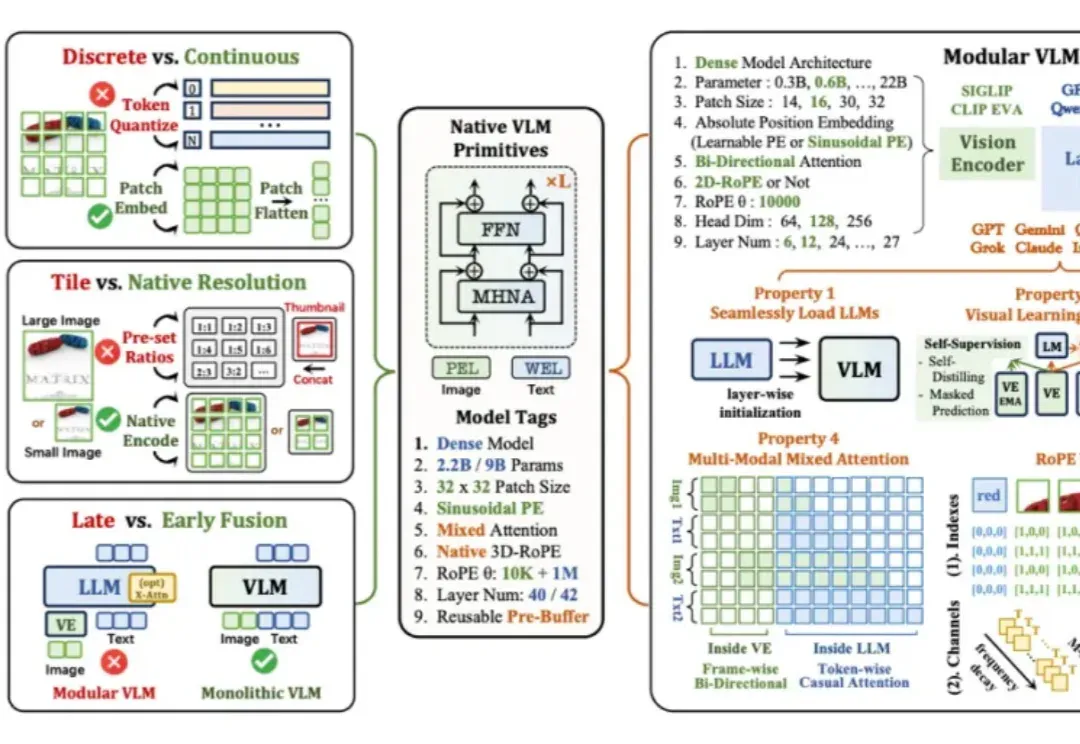
当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。
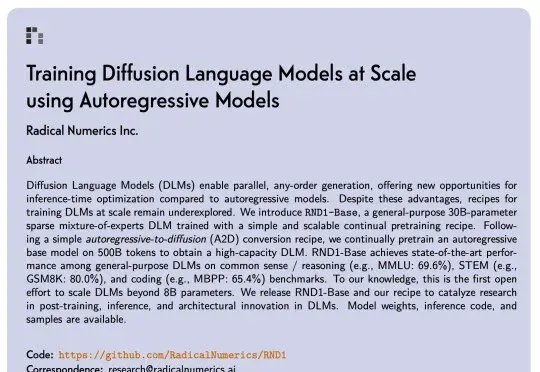
扩散语言模型(Diffusion Language Models,DLM)一直以来都令研究者颇感兴趣,因为与必须按从左到右顺序生成的自回归模型(Autoregressive, AR)不同,DLM 能实现并行生成,这在理论上可以实现更快的生成速度,也能让模型基于前后文更好地理解生成语境。