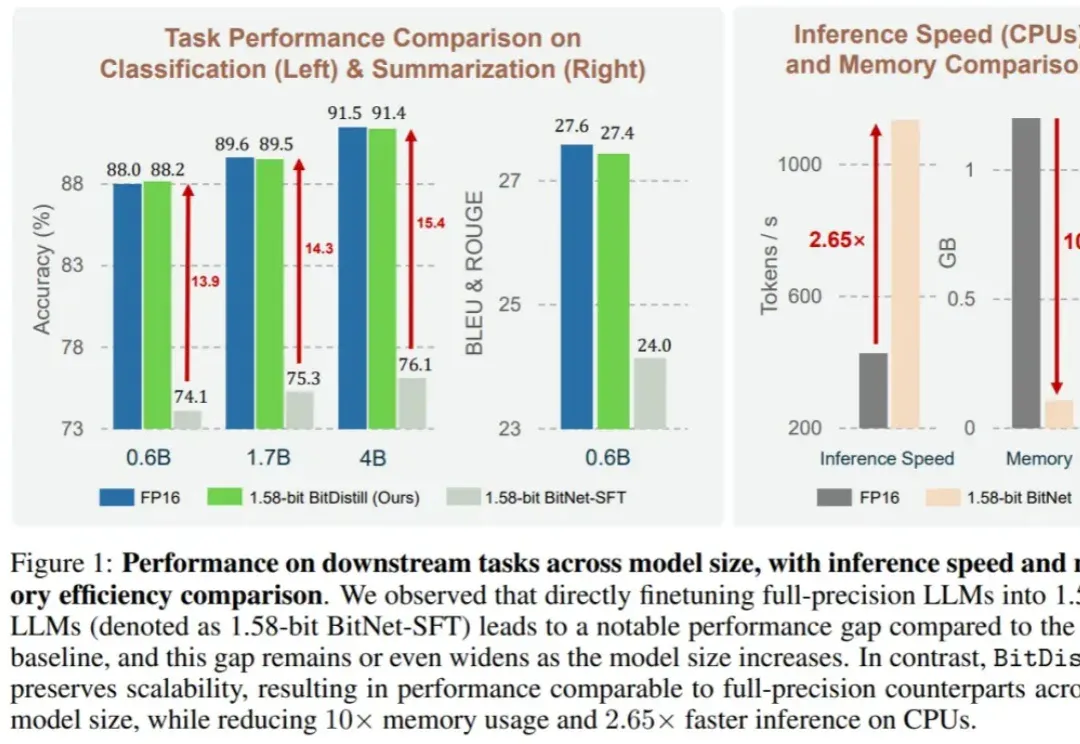
微软BitDistill将LLM压缩到1.58比特:10倍内存节省、2.65倍CPU推理加速(在新窗口打开)
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。
共 375 篇
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。
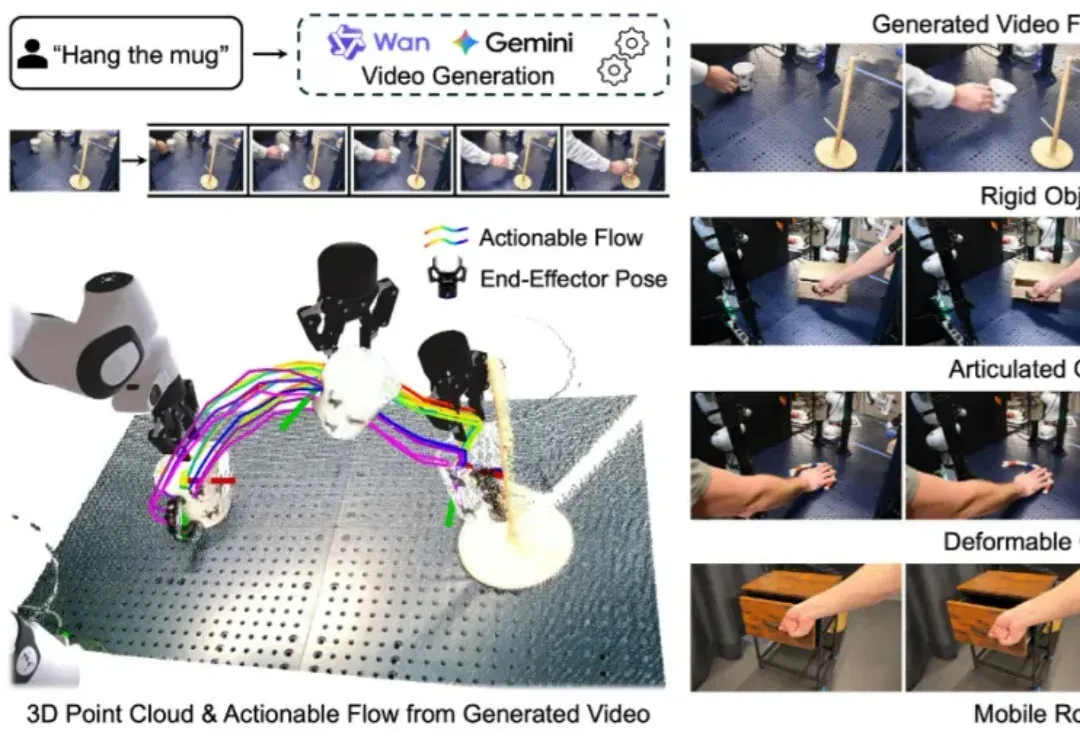
构建能够在新环境中、无需任何针对性训练就能执行多样化任务的通用机器人,是机器人学领域一个长期追逐的圣杯。近年来,随着大型语言模型(LLMs)和视觉语言模型(VLMs)的飞速发展,许多研究者将希望寄托于视觉 - 语言 - 动作(VLA)模型,期望它们能复刻 LLM 和 VLM 在泛化性上取得的辉煌。
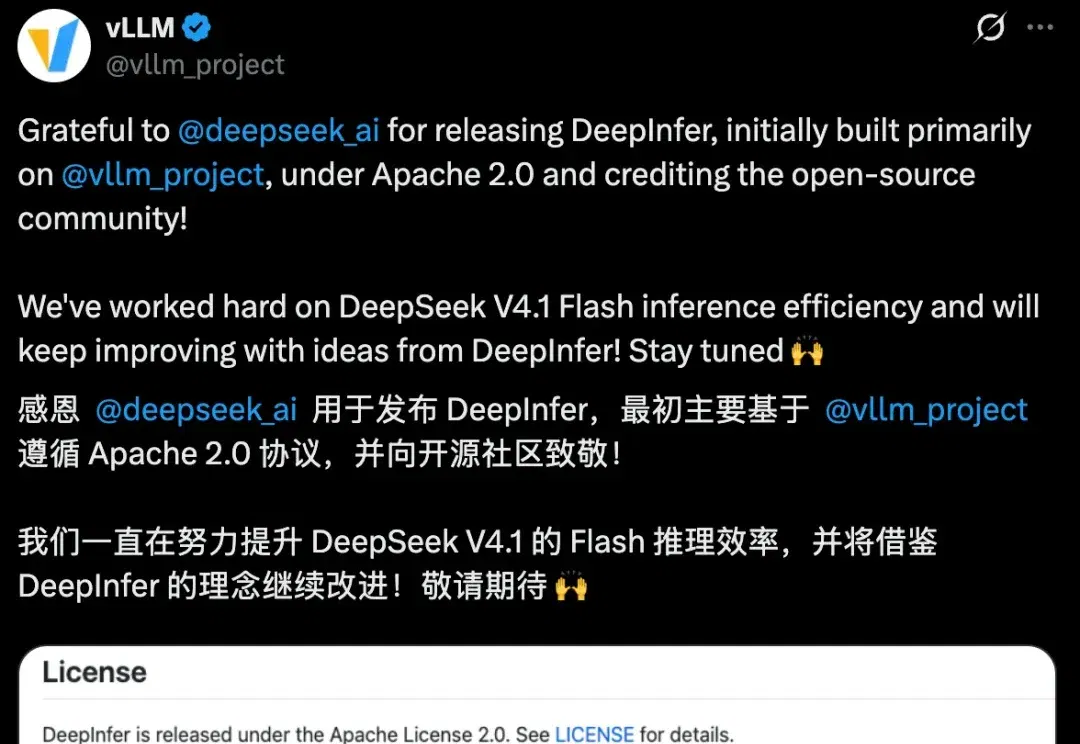
还得是「源神」D老师,善呐! 自家推理引擎DeepInfer掏出来还不到一周,开源社区就纷纷交上了作业。 真乃一鲸“落”万物生,第一波开源效果已经新鲜出炉: 立志学习DeepSeek、成为DeepSeek、超越DeepSeek。(bushi) vLLM、SGLang这些成熟的推理框架率先迎来T0升级包—— 在各自披露的测试配置下,性能已经接近甚至部分超过DeepInfer。 不戳不戳!DeepInfer最初基于vLLM构建,设计上也借鉴了SGLang的思路。 如今DeepSeek把打磨后的实现公开,两家又接着吸收、继续优化。 哥几个才是把开源玩出了花。 还有些受DeepInfer灵感启发的开发
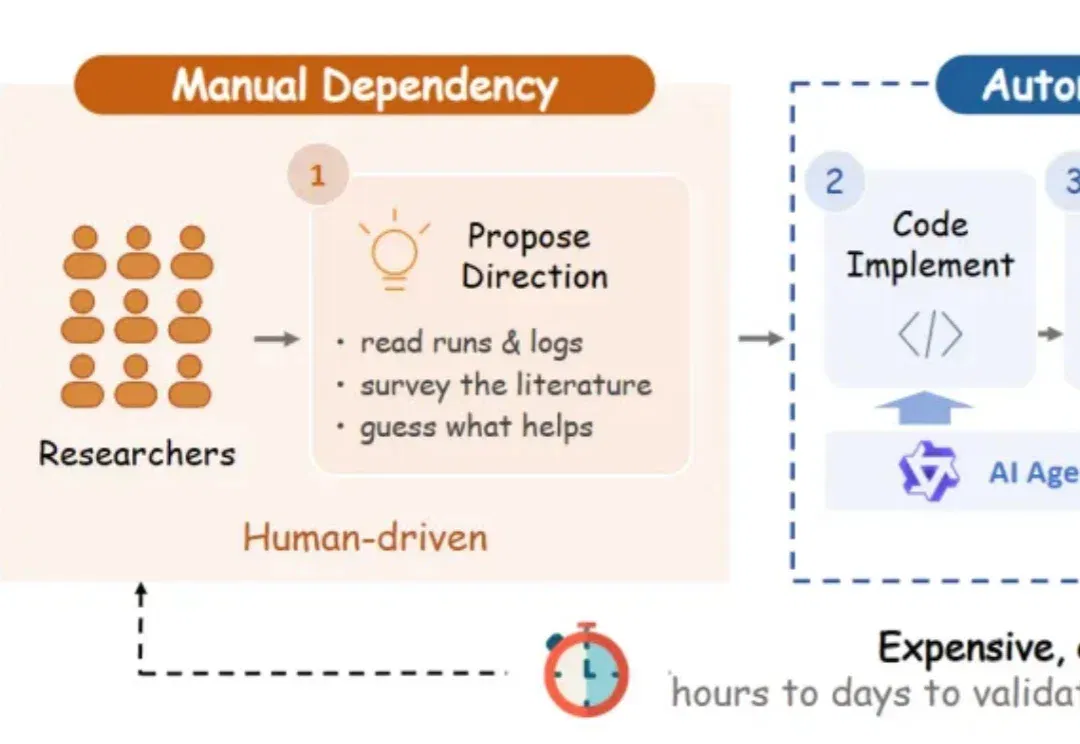
如今的 AI 已经能顺畅地帮你写代码、跑实验、做评估。算法工程师的每一天,几乎变成了:让 LLM 整理昨天的实验结果,让 LLM 实现新想法,让 LLM 监控实验运行…… 似乎只需把需求告诉 AI,它就能完成大部分算法工作。
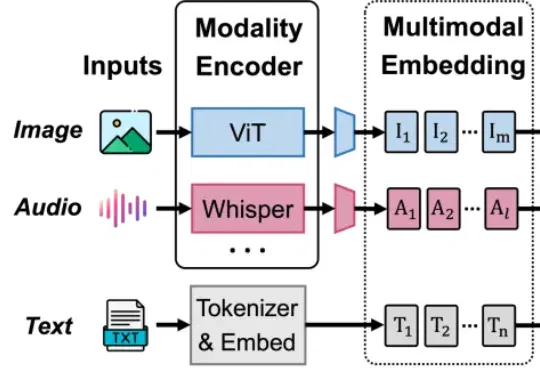
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
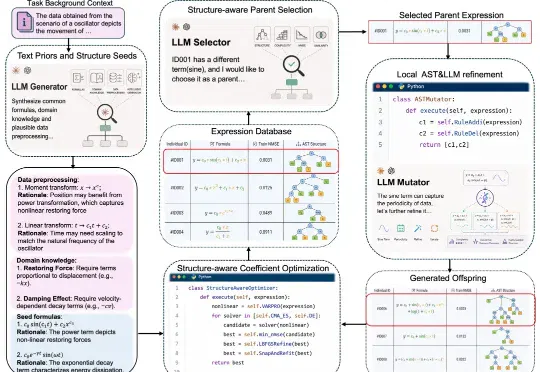
来自博世中央研究院与清华大学的研究人员提出 FunctionEvolve 框架,在两大基准测试上大幅刷新了这项任务的结果。在 LLM-SRBench 的 129 个合成科学方程任务上,FunctionEvolve 最终给出的公式在 55.8% 的任务上与真实公式等价(SA@1 = 72/129),是此前最好结果的 3.6 倍;
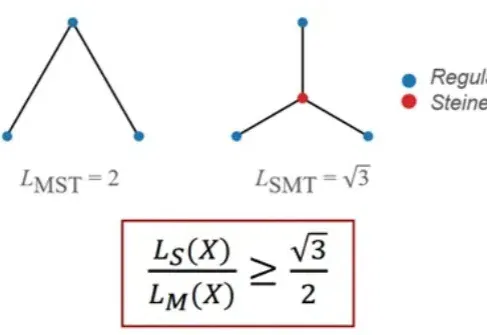
近期,LLM 已经在 IMO 上取得了很好的成绩,在一些研究级数学上(如短程证明、组合构造)也有所进展。但如果真正让 LLM 去处理提出数十年的数学猜想,结果会是如何?
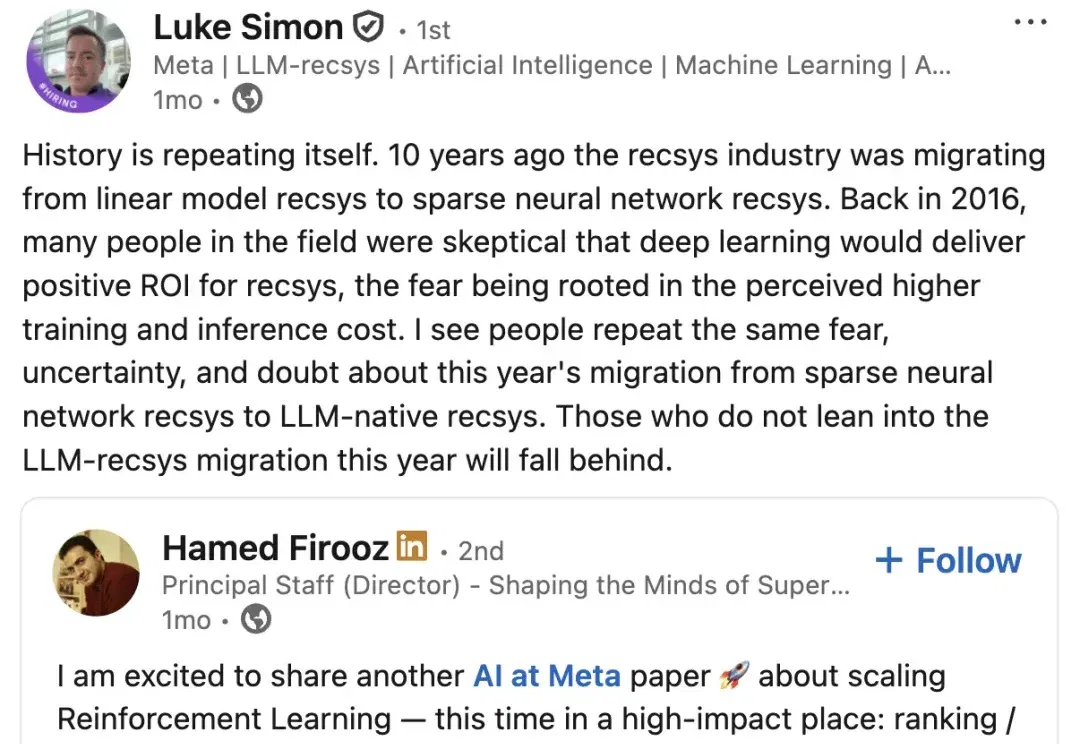
大模型(LLM)的世界知识和推理能力是实现下一代推荐系统,即基于大模型的推荐系统(LLM4Recsys)的重要基石。来自meta ai的研究者们尝试将推理模型引入再排序阶段,推荐系统的最后一环。
最新综述首次系统探讨LLM控制机器人的安全威胁、防御机制与未来挑战,指出LLM的具身鸿沟导致其在物理空间可能执行危险动作,而现有防御体系存在逻辑与物理脱节等问题。
清华大学等多所高校联合发布SR-LLM,这是一种融合大语言模型与深度强化学习的符号回归框架。它通过检索增强和语义推理,从数据中生成简洁、可解释的数学模型,显著优于现有方法。在跟车行为建模等任务中,SR-LLM不仅复现经典模型,还发现更优新模型,为机器自主科学发现开辟新路径。