重磅!阿里云Coding Plan全面上线Qwen3.5、GLM-5、MiniMax M2.5、Kimi K2.5(在新窗口打开)
刚刚,阿里云Coding Plan订阅服务全面上线Qwen3.5、GLM-5、MiniMax M2.5、Kimi K2.5四大顶尖开源模型。用户订阅套餐后,可在Qwen Code、Claude Code、Cline、OpenClaw等AI工具上自由切换使用这些模型,享受更稳定、Tokens额度更高的模型服务。
共 46 篇
刚刚,阿里云Coding Plan订阅服务全面上线Qwen3.5、GLM-5、MiniMax M2.5、Kimi K2.5四大顶尖开源模型。用户订阅套餐后,可在Qwen Code、Claude Code、Cline、OpenClaw等AI工具上自由切换使用这些模型,享受更稳定、Tokens额度更高的模型服务。
今天,月之暗面发布并开源Kimi K2.7 Code编程模型,参数量达1.1万亿,提供256K上下文窗口。这一模型重点提升了长上下文编程场景的指令遵循能力、长程编程任务的性能表现,并且大幅改善了在长程任务中的过度思考倾向,平均token消耗减少30%。
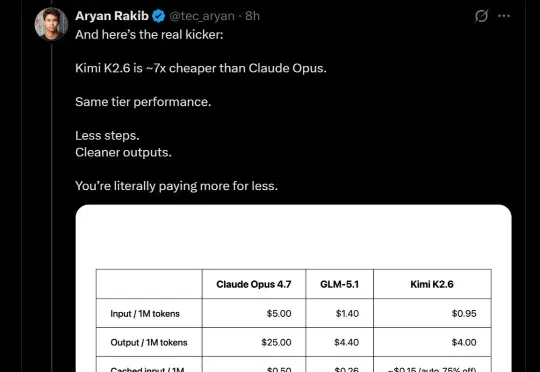
Claude Design前脚刚暴击完设计行业,结果后脚自己就被暴击了。出手的是来自中国的Kimi K2.6。什么??你跟我说小克专门为设计推出的工具,竟然没打过Kimi最新通用旗舰模型??
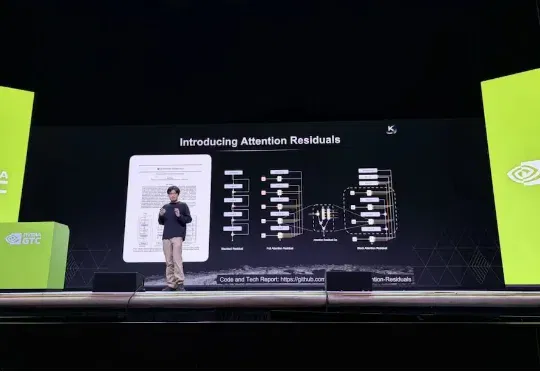
今日凌晨,在英伟达GTC大会上,月之暗面创始人杨植麟作为本届唯一受邀现场演讲的中国独立大模型公司创始人,发表题为《How We Scaled Kimi K2.5》的演讲,首次完整披露Kimi K2.5背后的技术路线图。
Kimi K2 Thinking,现已发布并开源!
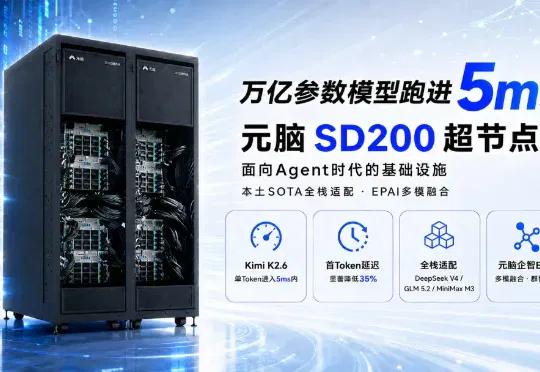
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
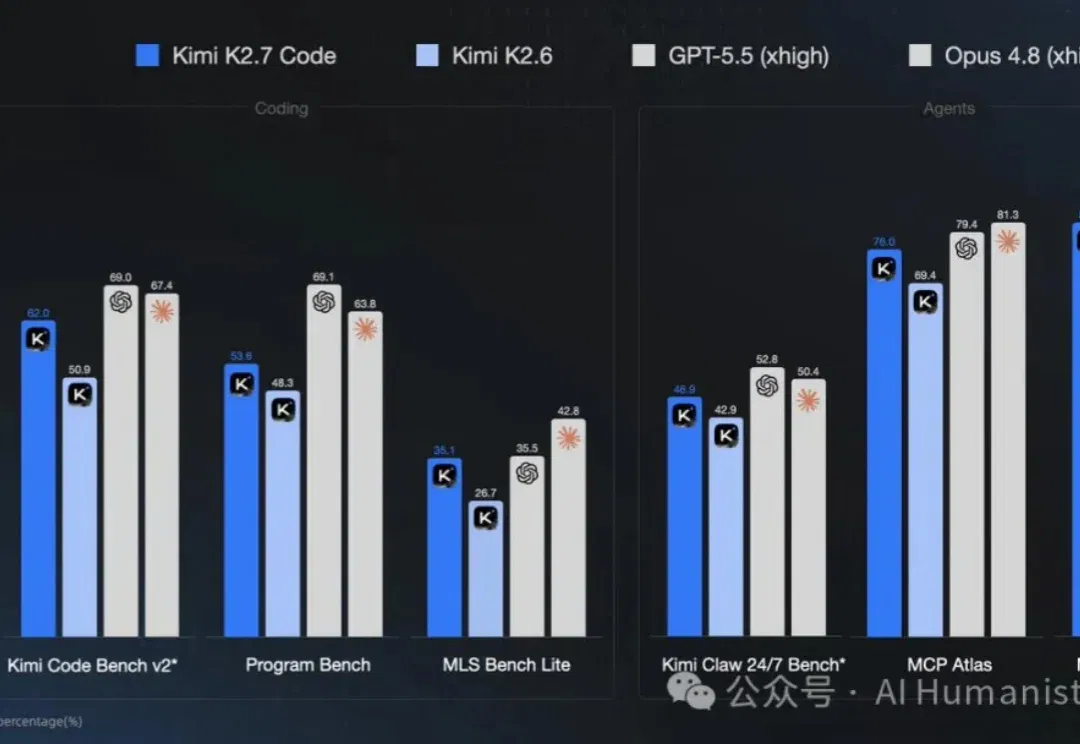
昨天 Kimi K2.7 Code 高速版 上线了,我上手试了下,最大的感受就一个字:快。
Kimi K2 Thinking训练真的只花了460万美元?杨植麟亲自带队,月之暗面创始团队出面回应了。这不是官方数据。训练成本很难计算,因为其中很大一部分用于研究和实验。他们还透露训练使用了配备Infiniband的英伟达H800,GPU数量也比巨头的少,但充分利用了每一张卡。
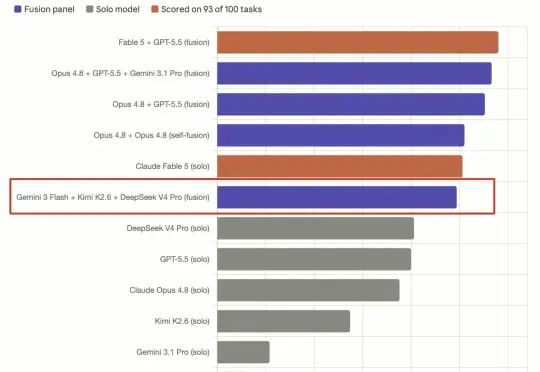
最新测试显示,模型抱团后实力明显升级:Opus 4.8+GPT-5.5>Fable 5;Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash=Fable 5。能力追上了,开销还减半。根据官方定价,相比Fable 5,Kimi K2.6+ DeepSeek V4 Pro+Gemini 3 Flash这套平价阵容,成本降幅接近80%。
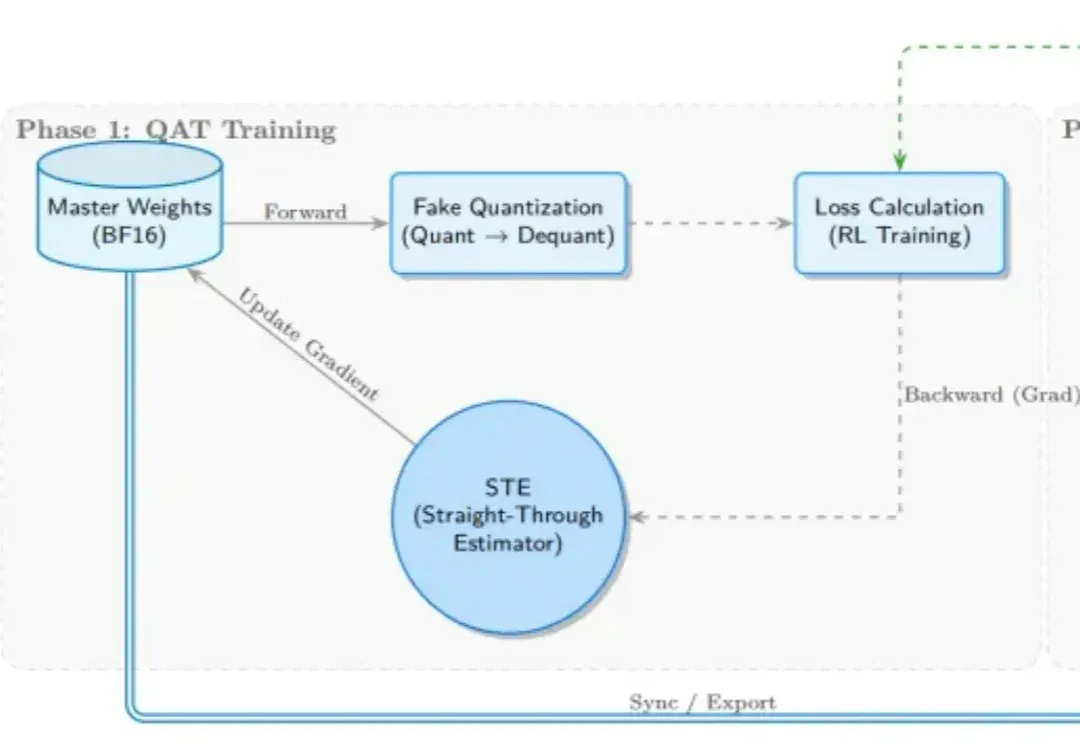
受 Kimi K2 团队启发,SGLang RL 团队成功落地了 INT4 量化感知训练(QAT) 流程方案。通过 “训练端伪量化 + 推理端真实量化(W4A16)” 的方案组合,我们实现了媲美 BF16 全精度训练的稳定性与训推一致性,