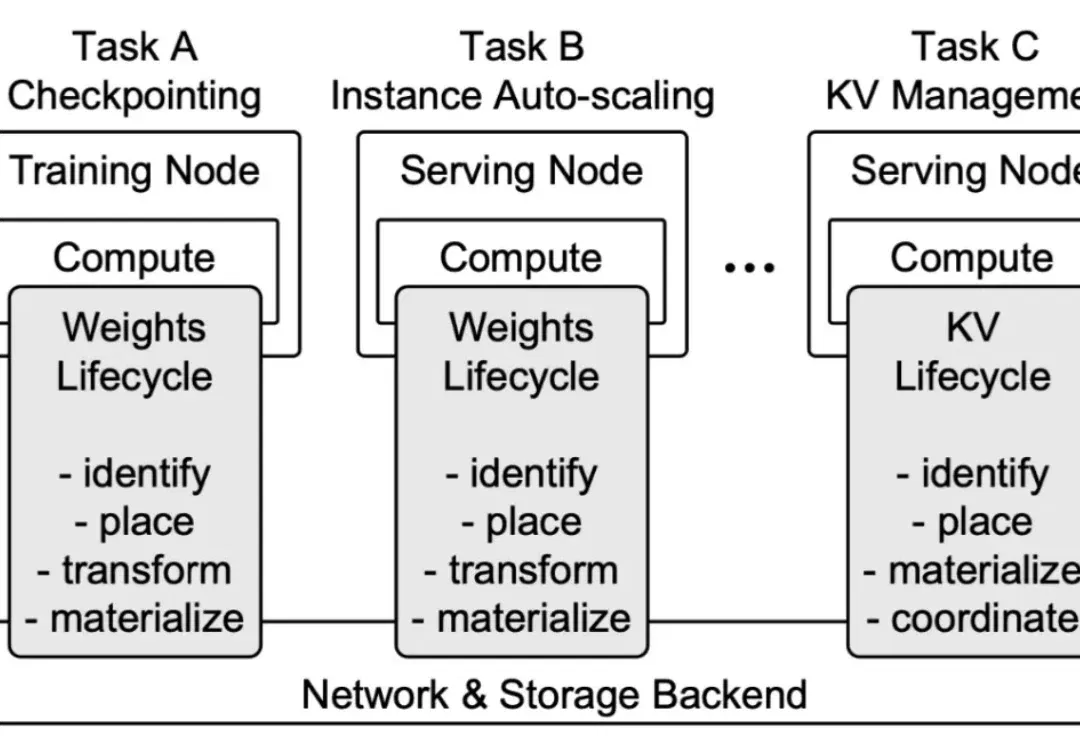
北大联合阶跃星辰提出TensorCast:统一可编程管理大模型张量,推理「首字延迟」最高降低93.2%(在新窗口打开)
过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
共 19 篇
过去几年,大模型推理系统优化的核心目标一直围绕一个问题展开:如何让 GPU 更高效地计算权重、激活、KV Cache 等高维张量?从并行策略、请求调度、显存管理到算子优化,学界业界大量优化技术不断提升模型推理效率。
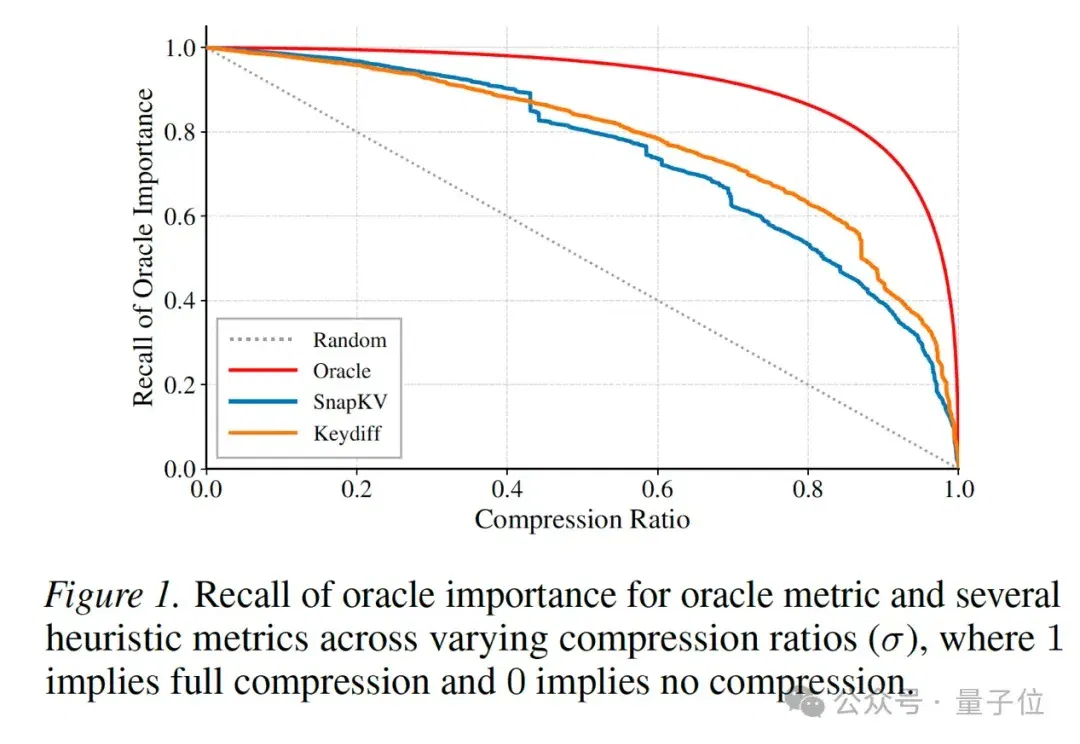
随着AI Coding、Agent、Deep Research 等应用快速普及,模型单次处理的上下文长度正在从几万Token迈向几十万甚至百万Token。
谷歌今年的一篇论文,愣是把存储芯片巨头的股价都给整出动静了。
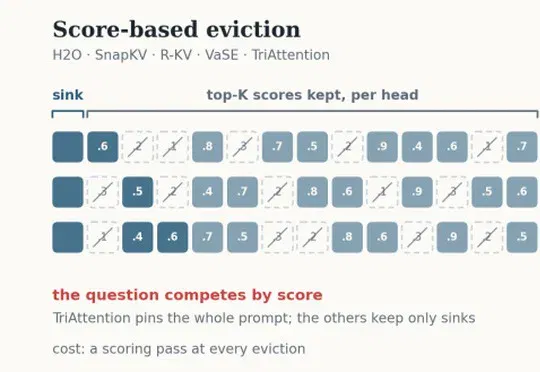
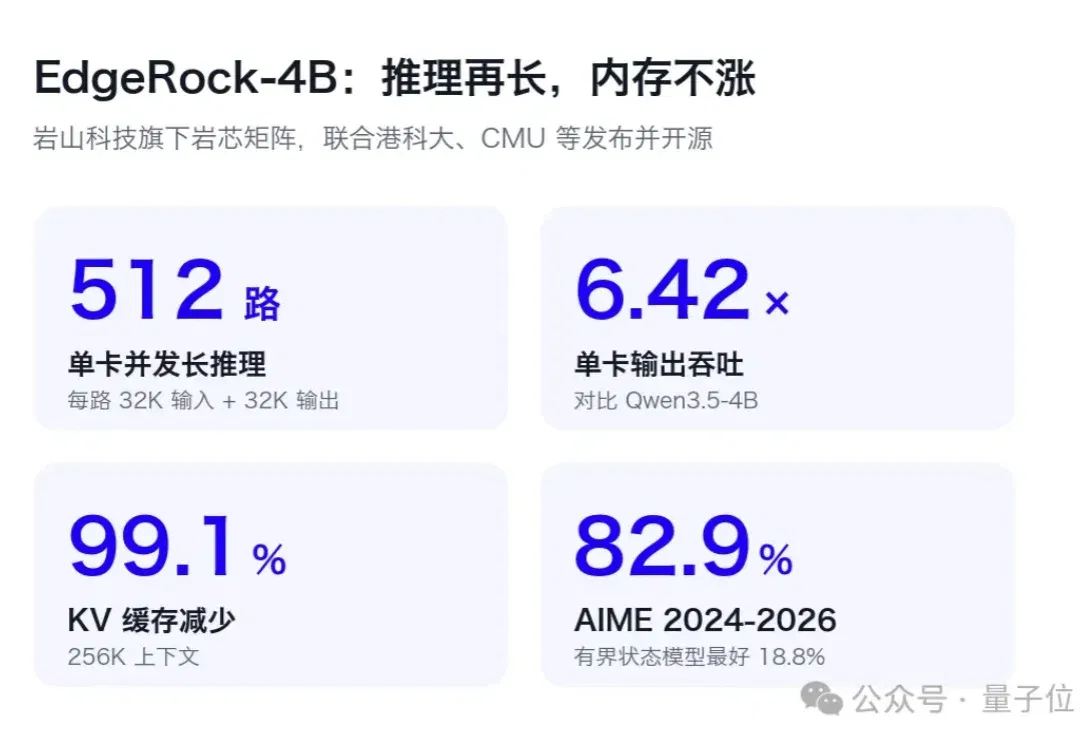
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
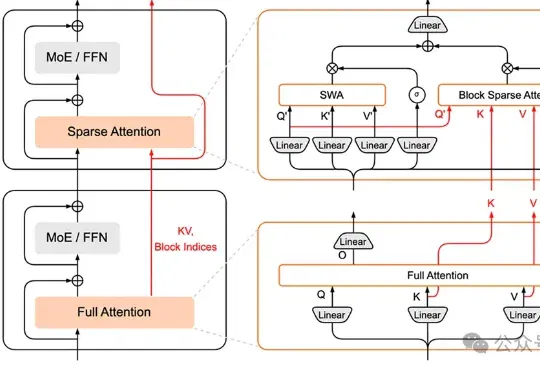
小米MiMo大模型团队,加入AI拜年战场——推出HySparse,一种面向Agent时代的混合稀疏注意力架构。
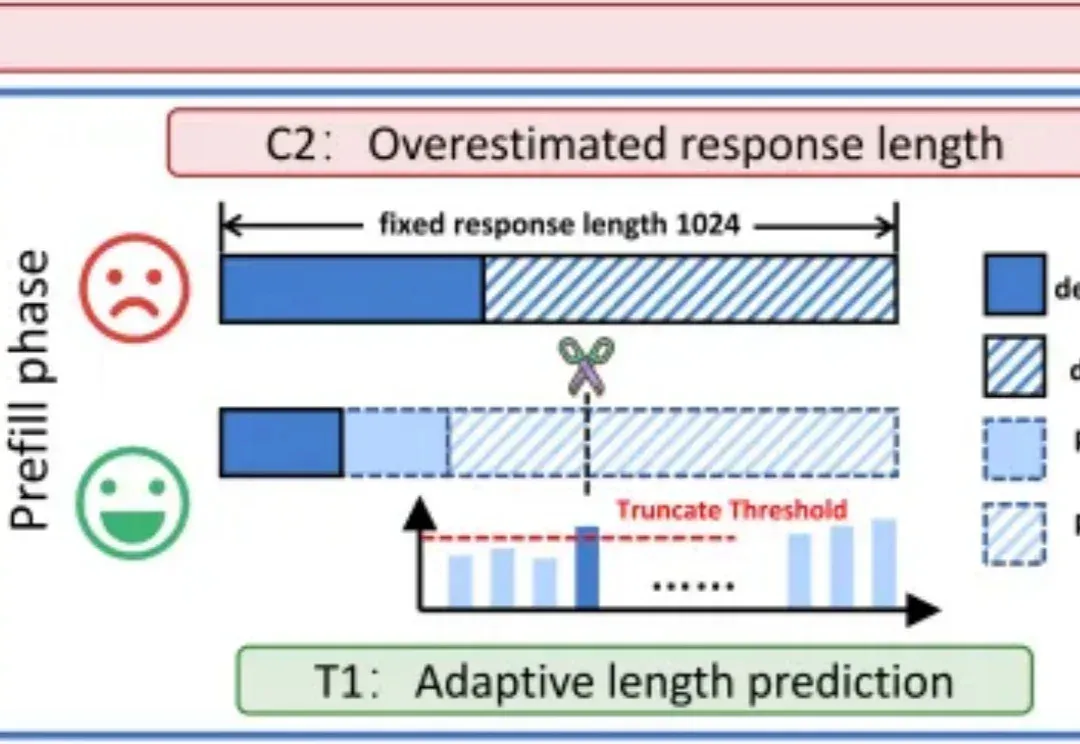
基于扩散的大语言模型 (dLLM) 凭借全局解码和双向注意力机制解锁了原生的并行解码和受控生成的潜力,最近吸引了广泛的关注。例如 Fast-dLLM 的现有推理框架通过分块半自回归解码进一步实现了 dLLM 对 KV cache 的支持,挑战了传统自回归 LLMs 的统治地位。
一直以来,传统 MAS 依赖自然语言沟通,各个 LLM 之间用文本交流思路。这种方法虽然可解释,但冗长、低效、信息易丢失。LatentMAS 则让智能体直接交换内部的隐藏层表示与 KV-cache 工作记忆,做到了:
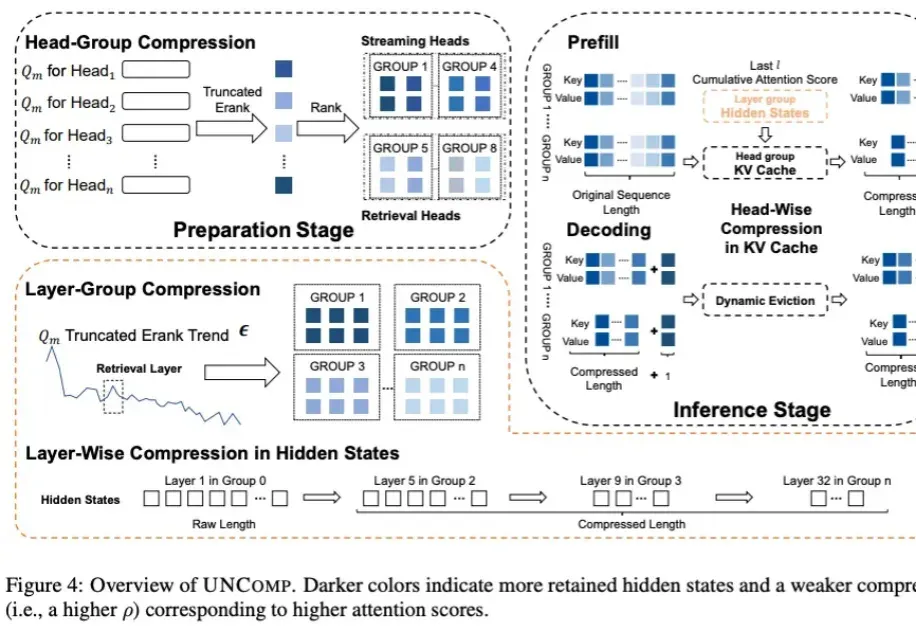
我们都知道 LLM 中存在结构化稀疏性,但其底层机制一直缺乏统一的理论解释。为什么模型越深,稀疏性越明显?为什么会出现所谓的「检索头」和「检索层」?
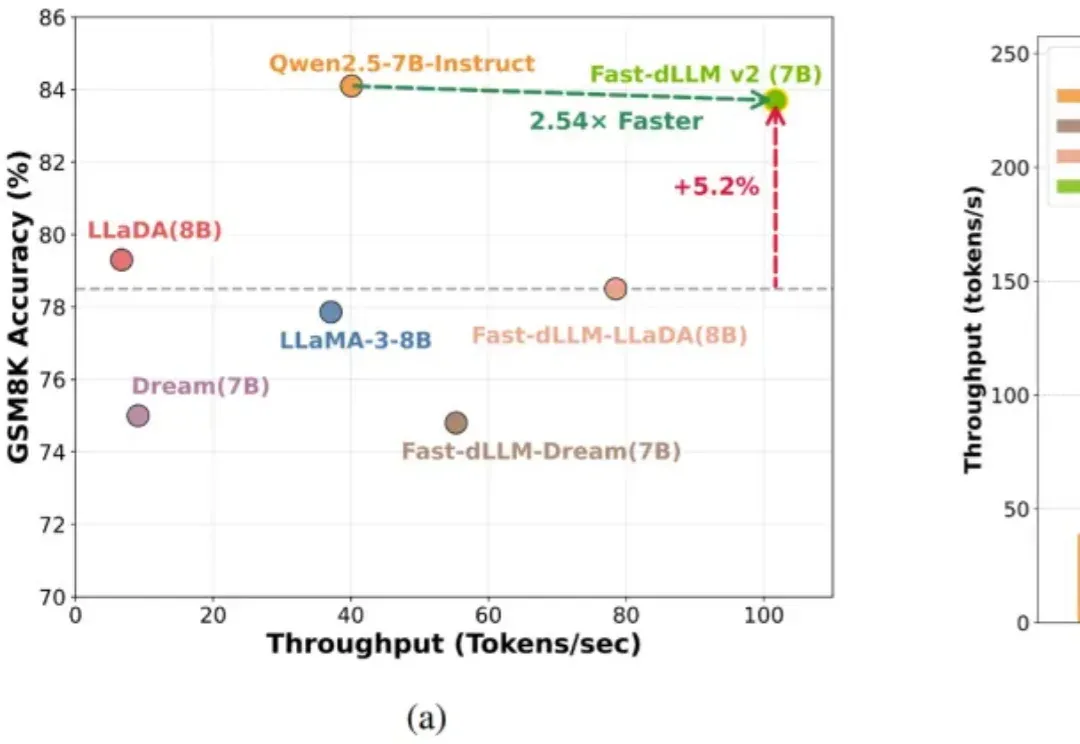
自回归(AR)大语言模型逐 token 顺序解码的范式限制了推理效率;扩散 LLM(dLLM)以并行生成见长,但过去难以稳定跑赢自回归(AR)模型,尤其是在 KV Cache 复用、和 可变长度 支持上仍存挑战。