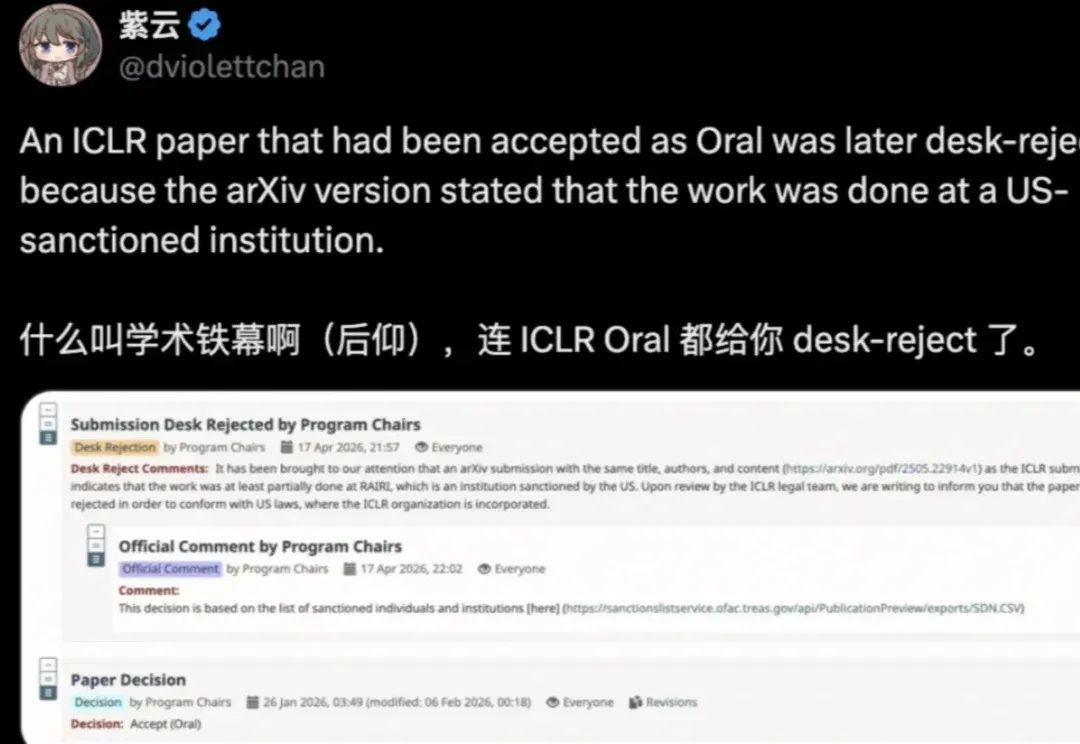
ICLR发了Oral又反悔,理由是查到了制裁名单?(在新窗口打开)
「学术铁幕!连 ICLR Oral 都给 desk-reject 了。」
共 92 篇
「学术铁幕!连 ICLR Oral 都给 desk-reject 了。」
AI 论文之争,本质是话语权之争。 这几天,TurboQuant 几乎成了 AI 学术圈里最热的争议事件之一。 一边是 Google Research 高调发博文,把它包装成能显著降低大模型推理成本、并将在 ICLR 2026 亮相的“突破性”工作,另一边则是先行工作RaBitQ的作者——高健阳以知乎答主身份在社区怒喷,最新一次帖子更新是3.30日凌晨,他认为这篇论文在方法描述、理论比较和实验披露上都存在严重问题,这条知乎帖子已经拿到近5K赞。短短几天里,这场风波已经不只是技术讨论,而开始变成一场关于原创归属、论文叙事和大厂学术权力的公开拉扯。 先把 TurboQuant 的问题说清楚,在这次
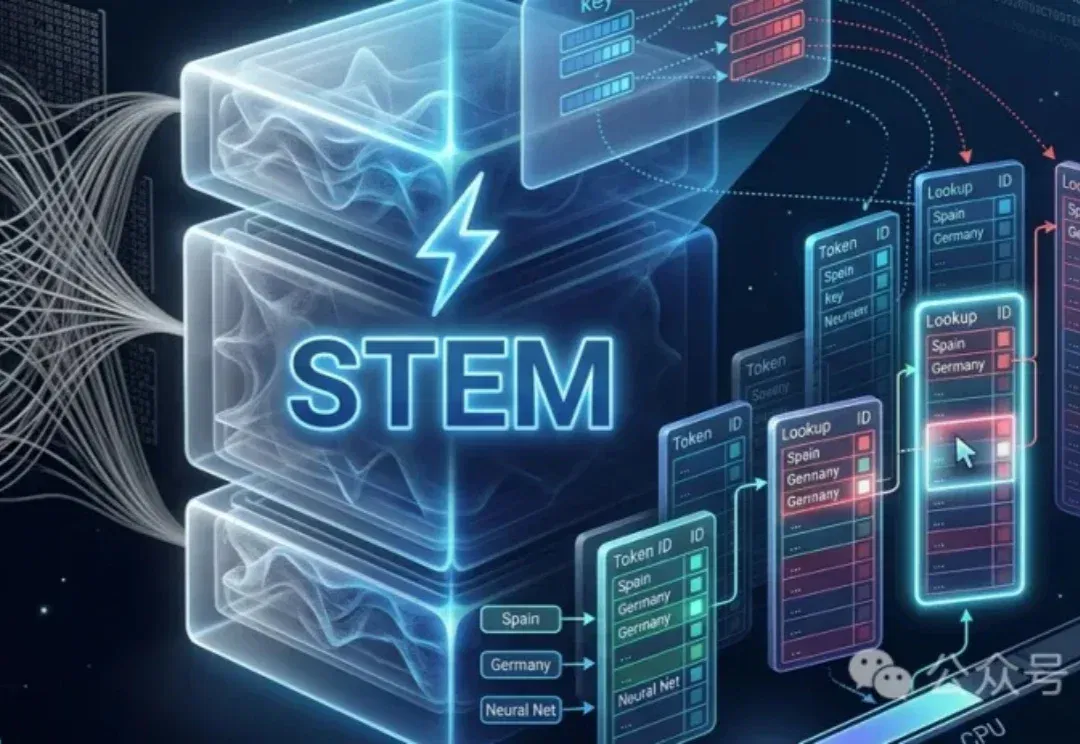
ICLR论文STEM架构率先提出「查表式记忆」架构,早于DeepSeek Engram三个月。它将Transformer的FFN从动态计算改为静态查表,用token索引的embedding表直接读取记忆,彻底解耦记忆容量与计算开销。
ICLR'26新研究CPiRi打破时序预测僵局:用冻结底座提取时序特征,轻量模块专注学习通道间真实关系,不靠位置编码「背答案」。测试中通道乱序性能零波动,仅用25%数据即可泛化至全网络,真正实现鲁棒与精准双赢。
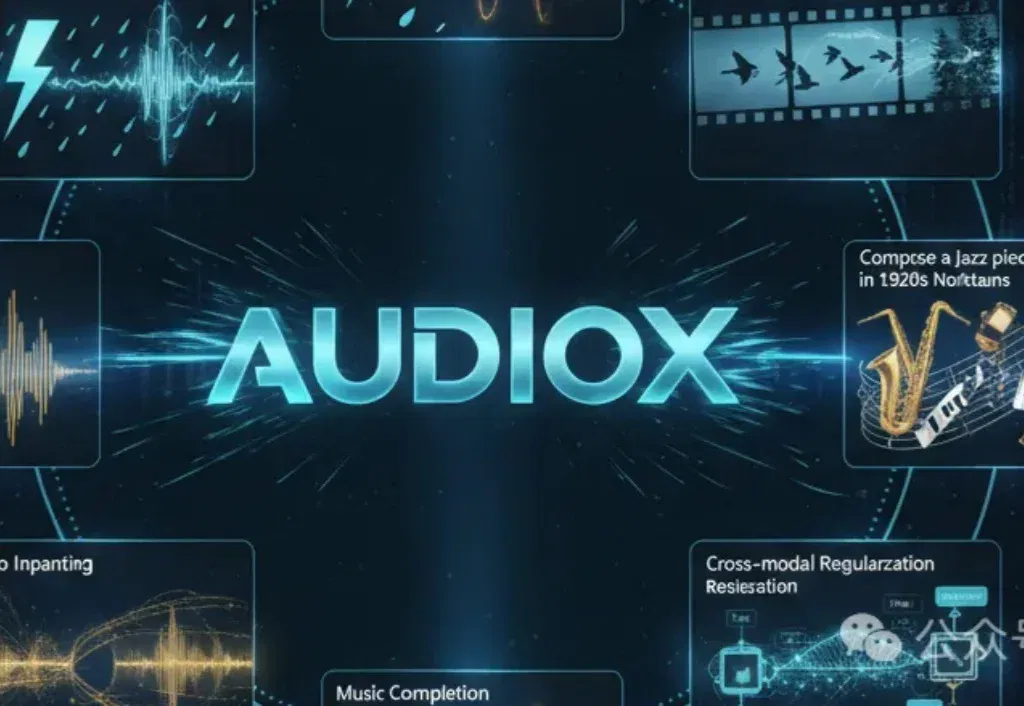
港科大团队提出音频生成统一模型AudioX,只需一个模型,就能从文本、视频、图像等任意模态生成高质量音效和音乐,在多项基准上超越专家模型。团队同时开源了700万样本的细粒度标注数据集IF-caps与可控T2A评测基准T2A-bench,并在该基准上大幅领先现有方法。论文已被ICLR 2026接收。
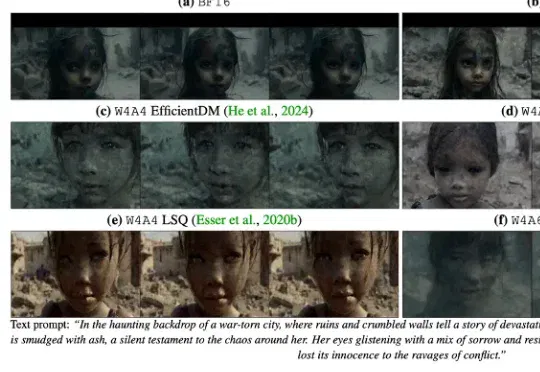
香港科技大学 & 北航 & 商汤等提出了一个专门面向视频生成扩散模型的 QAT 范式 ——QVGen,在 3-bit / 4-bit 都能把质量拉回来,并且让 4-bit 首次接近全精度表现成为现实。该论文现已被 ICLR 高分接收:rebuttal 前 88666(top 1.4%),rebuttal 后 88886 (top 0.5%)。
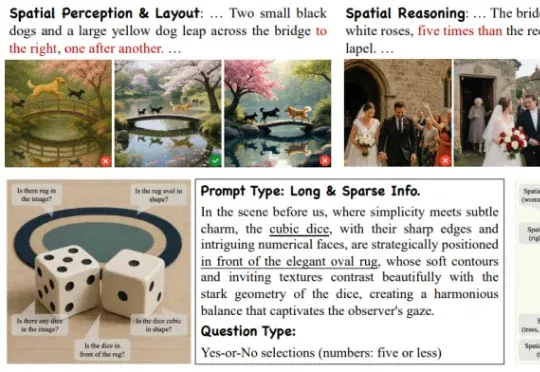
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
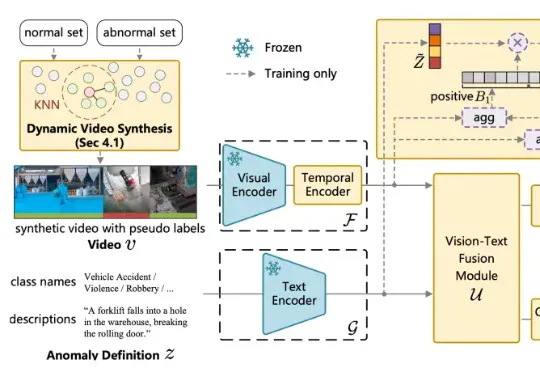
针对这一问题,中国传媒大学媒体融合与传播国家重点实验室的吴晓雨教授团队于 ICLR 2026 发表论文《Language-guided Open-world Video Anomaly Detection under Weak Supervision》,直面 VAD 领域的核心问题 —— 什么是异常?
史上首次,ICLR成立后设立机制设计相关Workshop,全球顶流学者众神云集!
21%的审稿意见竟全是AI生成的!「AI写,AI审」,ICLR裸奔事故从人肉搜索、金钱贿赂到全网吃瓜,这场闹剧撕开了学术圈最后的遮羞布。深度复盘这疯狂的61分钟,见证AI顶会史上最荒诞的一夜。