里程碑时刻!首个100B扩散语言模型来了,技术报告揭秘背后细节(在新窗口打开)
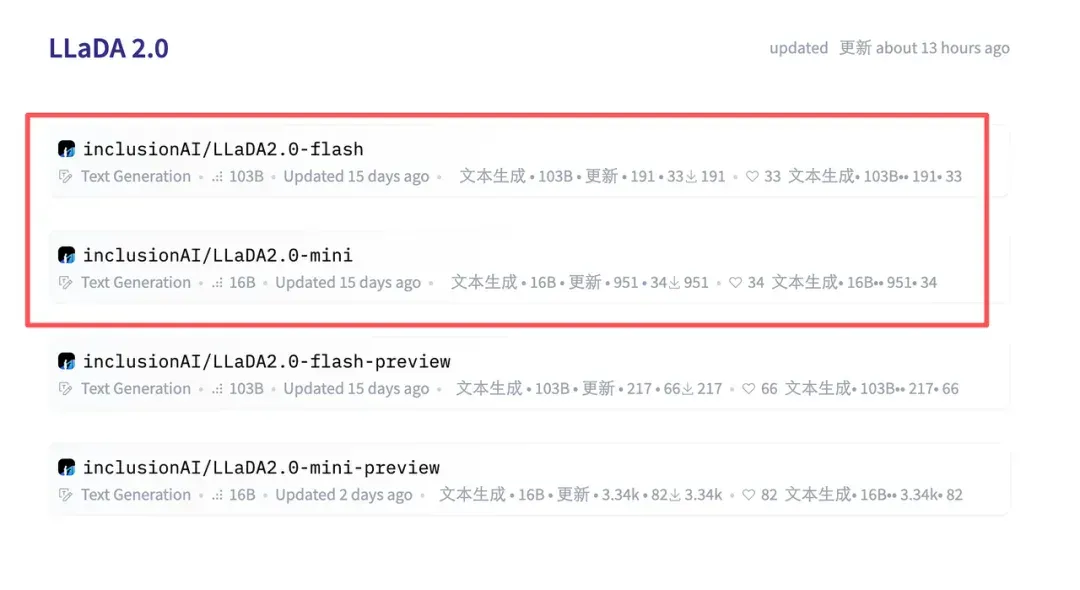
前段时间,我们在 HuggingFace 页面发现了两个新模型:LLaDA2.0-mini 和 LLaDA2.0-flash。它们来自蚂蚁集团与人大、浙大、西湖大学组成的联合团队,都采用了 MoE 架构。前者总参数量为 16B,后者总参数量则高达 100B—— 在「扩散语言模型」这个领域,这是从未见过的规模。
共 17 篇
前段时间,我们在 HuggingFace 页面发现了两个新模型:LLaDA2.0-mini 和 LLaDA2.0-flash。它们来自蚂蚁集团与人大、浙大、西湖大学组成的联合团队,都采用了 MoE 架构。前者总参数量为 16B,后者总参数量则高达 100B—— 在「扩散语言模型」这个领域,这是从未见过的规模。
阿里千问新模型,又卷出了新水平。 他们发布并开源的Qwen 3.8 Flash-Next,不仅价格直接秒杀了DeepSeek-V4-Flash,而且刚发布便摘得了Huggingface榜首! 推上网友们也沸腾了,甚至还有工程师甩出实测视频直呼牛逼: Qwen 3.8 Flash踏平了VRAM的门槛,数据中心级的长文本大模型,在消费级4090显卡上也能跑了! 还有人已经兴冲冲地把它用到了工作中。 不到8分钟,它就跑完了涵盖Python编程、多表分析和研究报告生成的一整套工作流: 宝塔特效也不在话下: 哇奥,真有这么炫?我们当然也得上手试试。 每百万Tokens输入仅0.8元 Qwen3.8-Fl
前不久,OpenAI 公布了其智能体入侵 HuggingFace 的 AI 安全事件,令很多企业和公众第一次意识到:AI 模型可能并不总会按照设计好的方式行动。
2026 年 6 月,HuggingFace 上一个名为 Boogu-Image-0.1 的开源模型,在上传以后迅速引爆了 AI 圈。这款模型最引人注目的地方,在于它以区区 10B 的参数规模,就在多项关键能力上超过了很多参数量更大的模型。
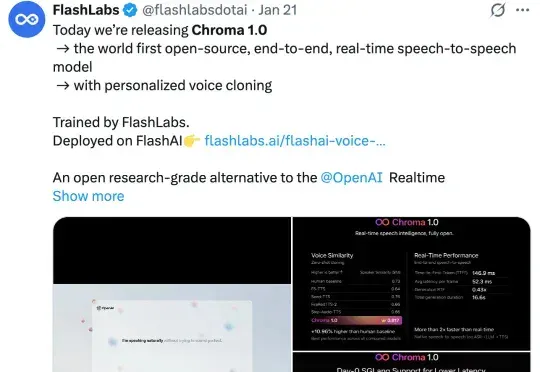
近期,FlashLabs 发布并开源了其实时语音模型 Chroma 1.0,其定位为全球首个开源的端到端语音到语音模型。Chroma 1.0 发布之后,便在社媒爆火,吸引了大量的关注。X 上的官推帖子已经突破了百万浏览量。
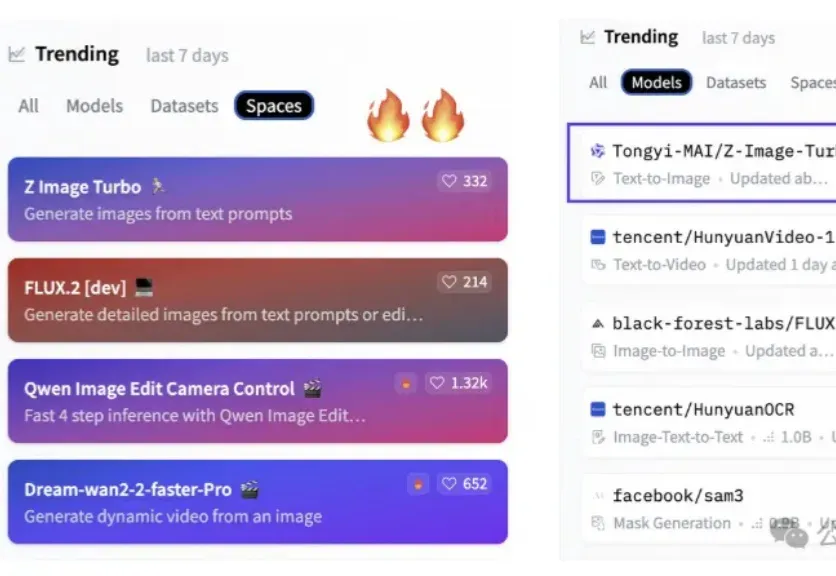
6B小模型,首日下载量高达50万次,上线不到两天直接把HuggingFace两个榜单都冲了个第一。
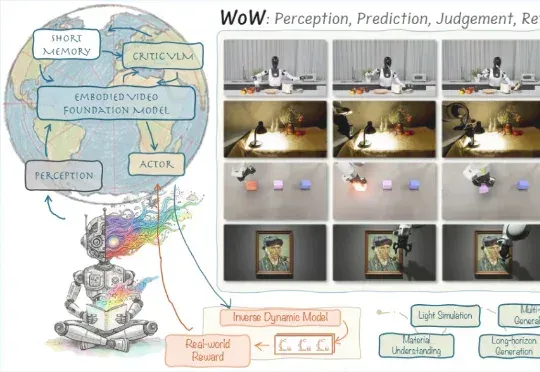
在「具身智能」与「世界模型」成为新一轮 AI 竞赛关键词的当下,来自北京人形机器人创新中心、北京大学多媒体信息处理国家重点实验室、香港科技大学的中国团队开源了全新的世界模型架构。