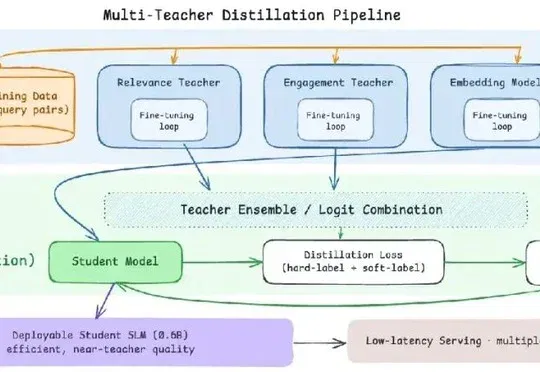
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?(在新窗口打开)
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
共 14 篇
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
Prime Intellect把Opus 4.7和GPT 5.5关进H200集群,不给人类指导,跑了1万次实验。结果:AI第一次在科研竞赛中打破人类纪录。2930步,递归自改进的卢比孔河,被跨过了。
最近,Prime Intellect正式发布了INTELLECT-3。这是一款拥有106B参数的混合专家(Mixture-of-Experts)模型,基于Prime Intellect的强化学习(RL)技术栈训练。在数学、代码、科学与推理的各类基准测试上,它达成了同规模中最强的成绩,甚至超越了不少更大的前沿模型。
两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。