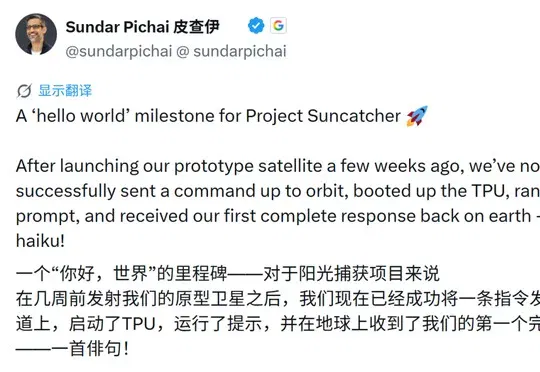
谷歌称 TPU 在轨运行 Gemma 4,原型卫星回传首个 AI 响应(在新窗口打开)
谷歌披露 Project Suncatcher 原型卫星在轨启动 TPU,运行预部署的 Gemma 4 并回传生成结果。文章沿着这次演示梳理太空计算的电力、星间通信、散热与辐射问题:单颗芯片的短时运行已迈出验证一步,规模化集群及经济性仍需要后续实验。
共 28 篇
谷歌披露 Project Suncatcher 原型卫星在轨启动 TPU,运行预部署的 Gemma 4 并回传生成结果。文章沿着这次演示梳理太空计算的电力、星间通信、散热与辐射问题:单颗芯片的短时运行已迈出验证一步,规模化集群及经济性仍需要后续实验。
又一个新里程碑! 就在今天,谷歌DeepMind官宣Gemma开源「全家桶」的最新战绩—— 累计下载,首破十亿大关。 2024年2月首次上线,从0到10亿,用了整整两年半的时间。 如今,全
Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。
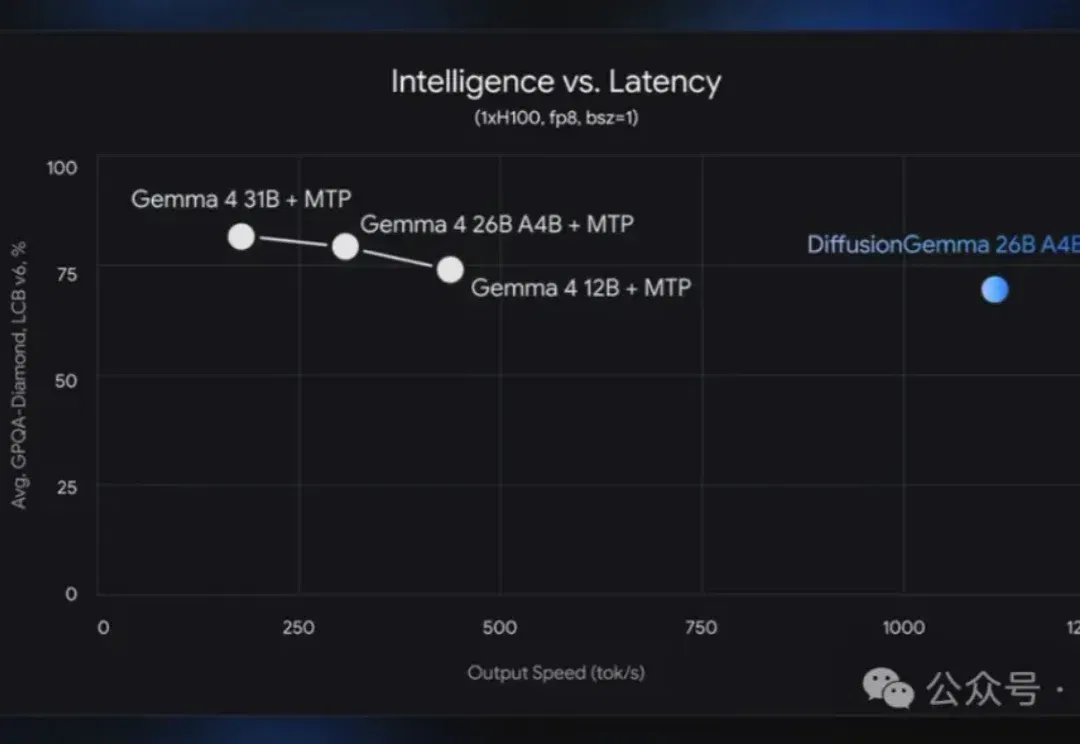
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
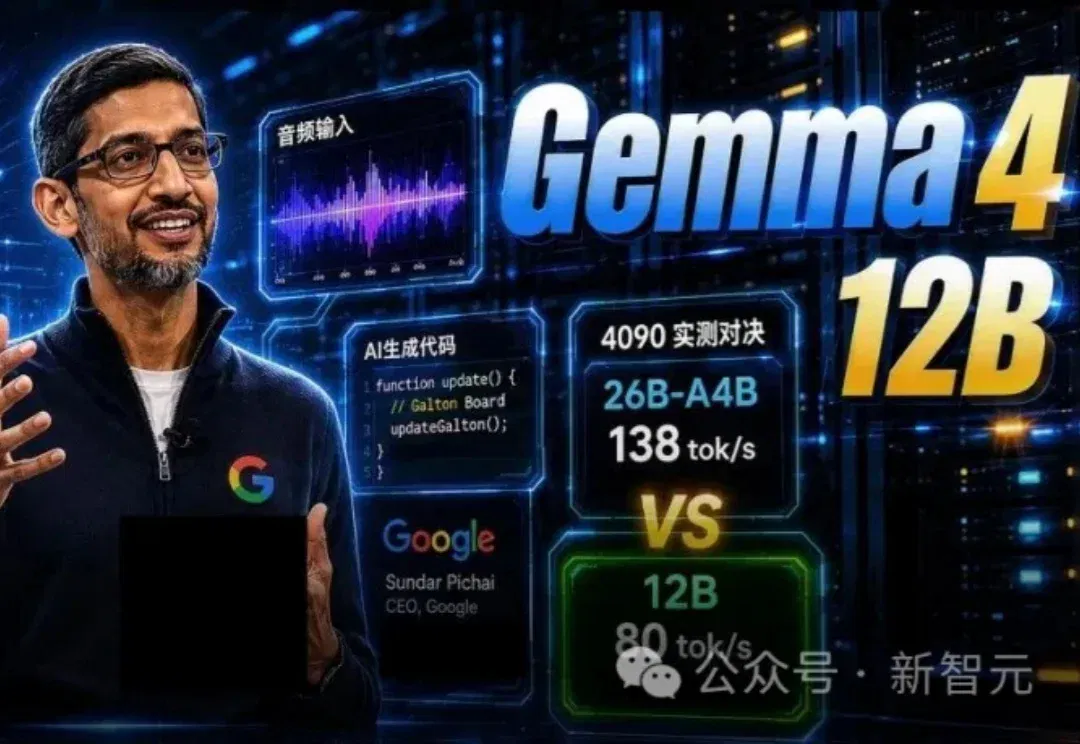
刚刚,谷歌扔出Gemma 4 12B大杀器!16G轻薄本就能全离线流畅跑通,性能直逼26B巨兽,全体开发者惊呼太震撼了,平民级本地AI封神之作降临。硬核实测速来看!
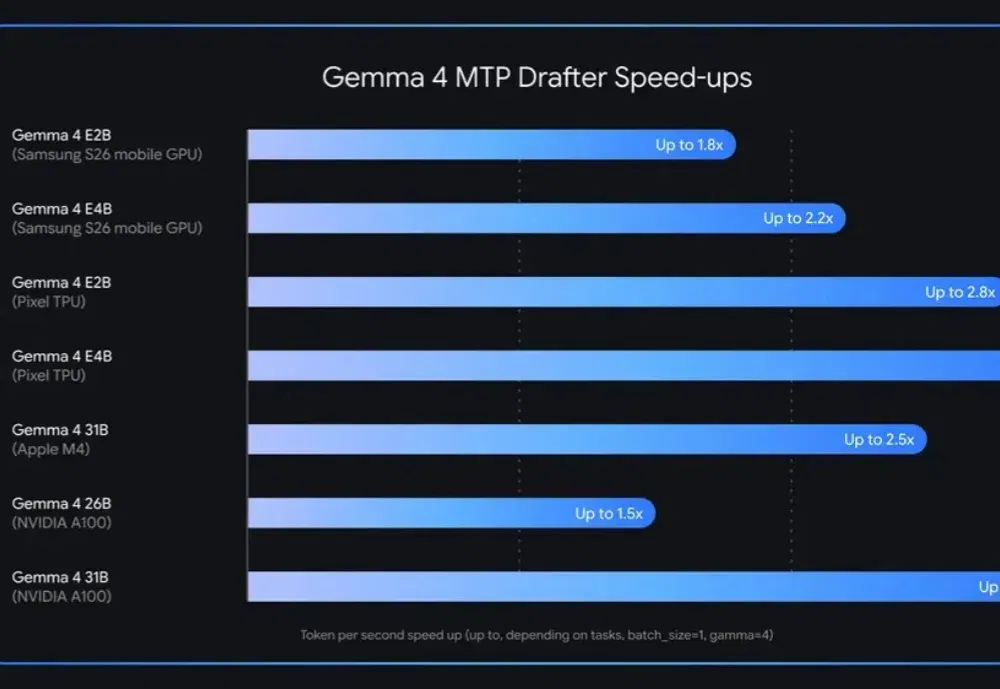
谷歌刚刚给Gemma 4家族更新了一项关键能力:Multi-Token Prediction(MTP)推测解码架构,推理速度最高提升3倍,输出质量不变。
阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。
谷歌深夜掏家底!Gemma 4全系开源,仅用31B越级斩杀20倍体量巨头。数学能力暴涨68%,硬生生把前代打成计量单位,开源界迎来终极大洗牌!
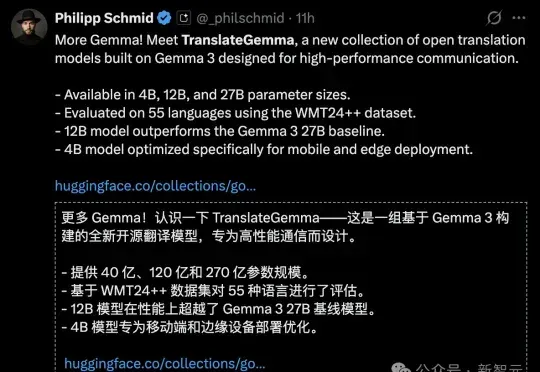
OpenAI悄悄发布了翻译产品ChatGPT Translate,谷歌则祭出强势回应——TranslateGemma,一个能在手机上翻55种语言的开源模型。
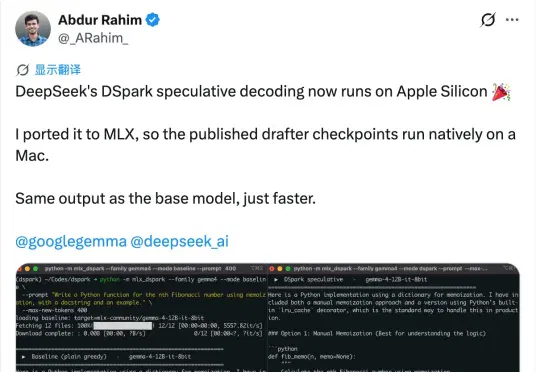
DSpark刚开源一周,就被搬进了苹果电脑。移植版本叫mlx-dspark,跑的是Gemma-4 12B和Qwen3-4B这两个模型。装上之后,这两个模型在Mac上的生成速度分别提了1.6倍和1.4倍。