搜索

关于“GRPO”的结果

共 25 篇

最强AI改进自己仅得0.16分? Einsia AI发布AI4AI-Bench: AI能否设计出更好的AI?

最强AI改进自己仅得0.16分? Einsia AI发布AI4AI-Bench: AI能否设计出更好的AI?(在新窗口打开)

导读 AI 能否改进 AI 自己? AI 已经会写 AI、训练 AI、优化 AI 系统;下一个里程碑,是 AI 能不能开始「设计 AI」。 对于今天的 Coding Agent 来说,它能介入的改进大致有三层: 系统工程解决算子、并行和通信,最终受硬件上限约束;数据工程改进配比、合成和清洗,受高质量信息供给限制;而算法设计改变的是目标函数、更新规则和训练流程本身。 这一层最特殊,一个更好的算法改变的是:在同样的数据和算力下,究竟能换来多少能力。 Adam、DPO、GRPO 这样的进步一旦出现,就能持续影响之后的一代代模型。 所以,如果 Recursive Self-Improvement 真要
AI技术文章
0
北大彭一杰教授课题组提出RiskPO,用风险度量优化重塑大模型后训练

北大彭一杰教授课题组提出RiskPO,用风险度量优化重塑大模型后训练(在新窗口打开)

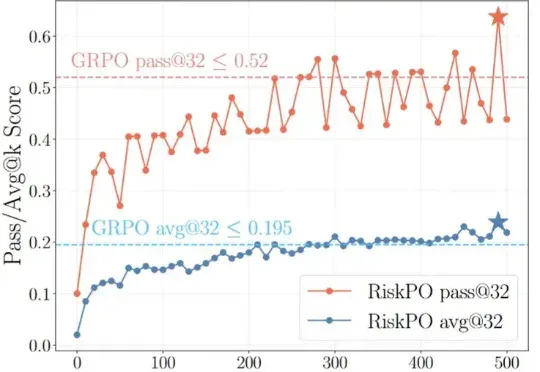
当强化学习(RL)成为大模型后训练的核心工具,「带可验证奖励的强化学习(RLVR)」凭借客观的二元反馈(如解题对错),迅速成为提升推理能力的主流范式。从数学解题到代码生成,RLVR 本应推动模型突破「已知答案采样」的局限,真正掌握深度推理逻辑 —— 但现实是,以 GRPO 为代表的主流方法正陷入「均值优化陷阱」。

AI技术文章
0
GRPO过时了吗?

GRPO过时了吗?(在新窗口打开)

很多人认为这个数字不是随便挑的:美国政府向 Anthropic 下发出口管制指令、切断 Fable 5 与 Mythos 5 境外访问权限的那一刻,正是美国东部时间下午 5 点 21 分。「5 点 21」这个数字上的重复,被多家媒体解读为一次刻意设计的呼应。智谱选择在这个节点站出来,相当于当着全世界开发者的面说了一句话:你们担心的「模型随时可能被收回」,开源这边没有这个问题。

AI资讯
0
首次证实RL能让3D模型学会推理,复杂文本描述下生成质量跃升!

首次证实RL能让3D模型学会推理,复杂文本描述下生成质量跃升!(在新窗口打开)

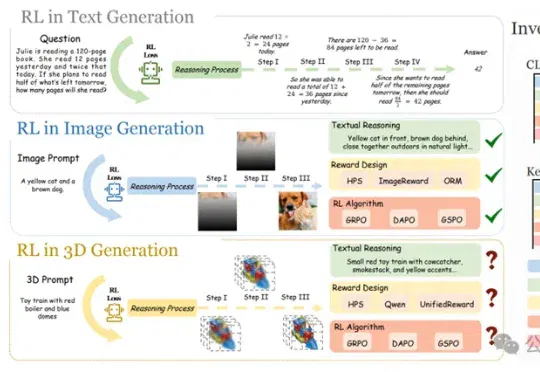
当GRPO让大模型在数学、代码推理上实现质变,研究团队率先给出答案——首个将强化学习系统性引入文本到3D自回归生成的研究正式诞生,并被CVPR 2026接收。该研究不只是简单移植2D经验,而是针对3D生成的独特挑战,从奖励设计、算法选择、评测基准到训练范式,做了一套完整的系统性探索。

AI技术文章
0