美团LongCat模型负责人将离职(在新窗口打开)
有知情人士透露,美团LongCat团队基础模型负责人裴鹏即将离职。公开资料显示,裴鹏毕业于北京大学,长期深耕信息检索与自然语言处理方向,职业履历覆盖多家全球顶尖科技企业。
共 31 篇
有知情人士透露,美团LongCat团队基础模型负责人裴鹏即将离职。公开资料显示,裴鹏毕业于北京大学,长期深耕信息检索与自然语言处理方向,职业履历覆盖多家全球顶尖科技企业。
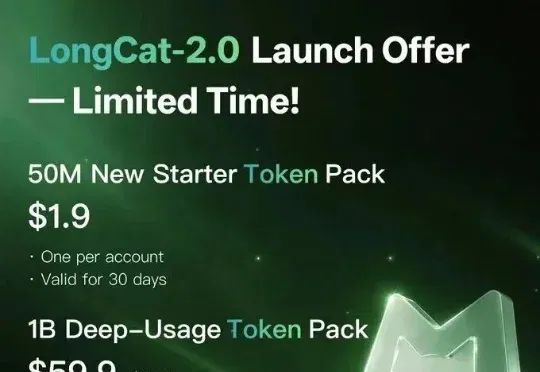
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
上个月也就是昨天,我写了一篇LongCat 2.0的实测,用四个任务测了一下它的编程能力,当时我的评价是「有些地方惊艳,有些地方还差点意思」。
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
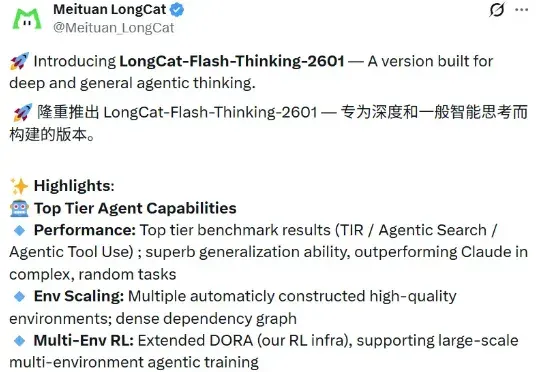
美团也重磅更新自家模型 ——LongCat-Flash-Thinking-2601。这是一款强大高效的大规模推理模型,拥有 5600 亿个参数,基于创新的 MoE 架构构建。该模型引入了强大的重思考模式(Heavy Thinking Mode),能够同时启动 8 路思考并最终总结出一个更全面、更可靠的结论。目前重思考模式已在 LongCat AI 平台正式上线,人人均可体验。
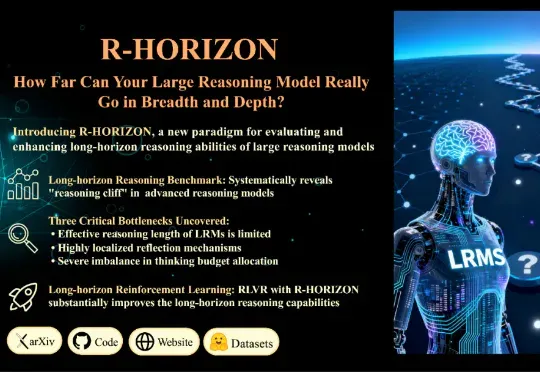
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
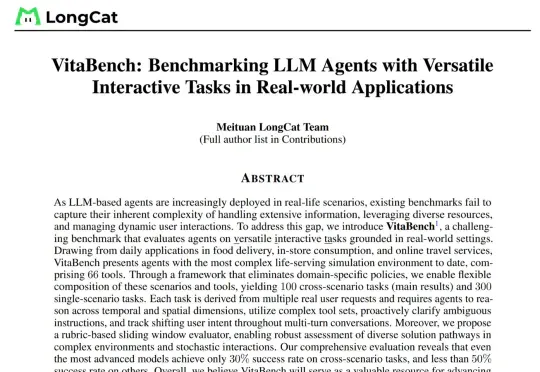
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
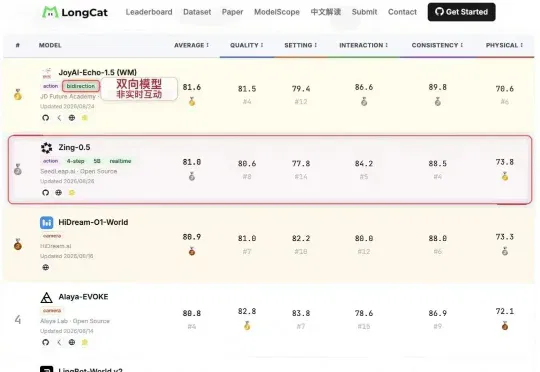
Loopit发布了实时互动世界模型Zing-0.5,在美团LongCat与复旦大学联合推出的可交互视频世界模型评测WBench中拿到第一。目前已经开源,并计划在2周内在Loopit APP(海外版)上线对应产品功能。
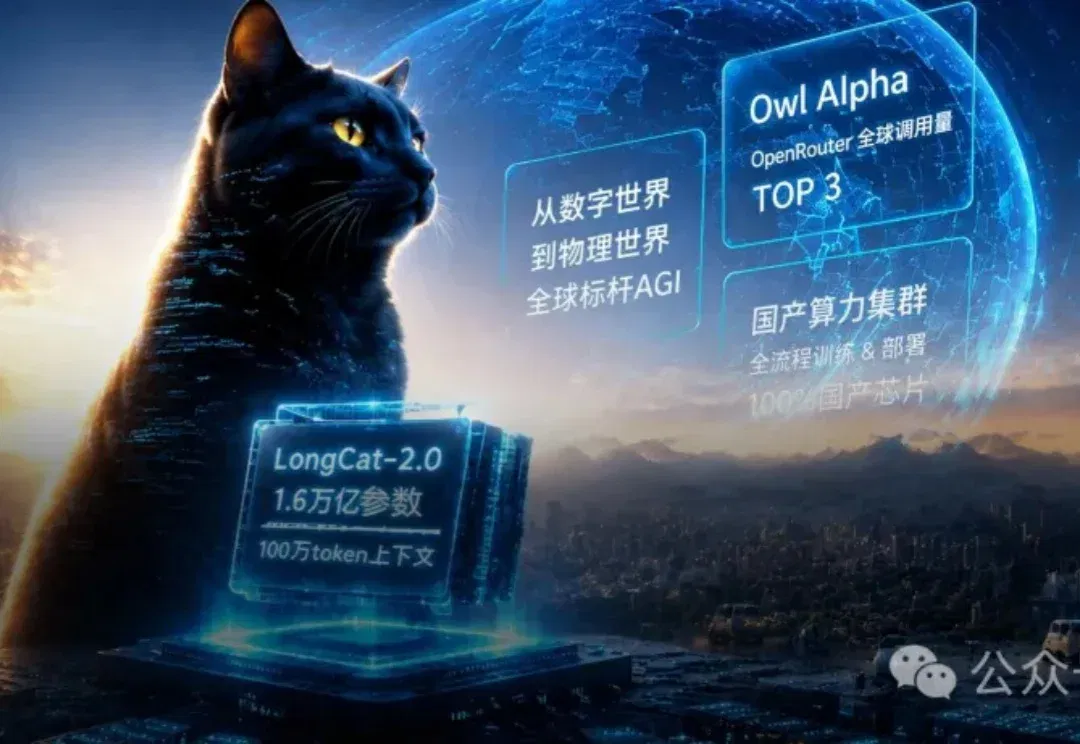
业界首个国产芯片上跑出的万亿参数模型LongCat-2.0于近日发布。
7月2日,据大厂日爆消息,美团内部开始限制使用豆包大模型。消息称,美团向所有涉及到豆包大模型的业务部门下发通知,要求自查并规划迁移至LongCat、DeepSeek等模型,若无法迁移,需单独走审批流程。对此消息,截至发稿,美团暂无官方回应。据媒体报道,这并非美团首次收紧外部大模型的使用。今年4月,美团对内部大模型使用做出调整,不再推荐业务使用阿里云提供的Qwen模型。若业务仍需使用,需上报审批。