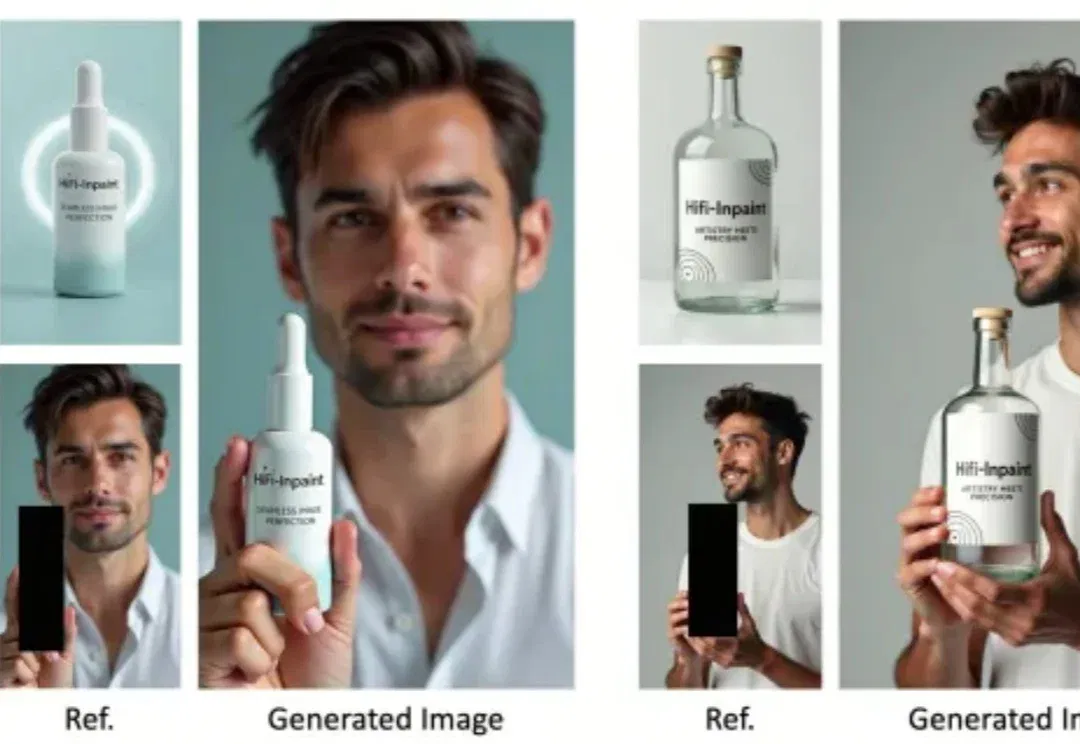
CVPR 2026 | 中科院、港中文等提出HiFi-Inpaint:无损还原物体细节,重塑Inpainting生成范式!(在新窗口打开)
在 AIGC 领域,基于参考图像的图像修复(Reference-based Inpainting)一直是一项备受关注的核心任务,它旨在利用参考图像引导修复过程,生成视觉一致的内容。这一技术在广告营销和电商领域有着巨大的应用潜力,例如让 AI 自动生成 “真人手持或穿戴商品” 的展示图。
共 50 篇
在 AIGC 领域,基于参考图像的图像修复(Reference-based Inpainting)一直是一项备受关注的核心任务,它旨在利用参考图像引导修复过程,生成视觉一致的内容。这一技术在广告营销和电商领域有着巨大的应用潜力,例如让 AI 自动生成 “真人手持或穿戴商品” 的展示图。
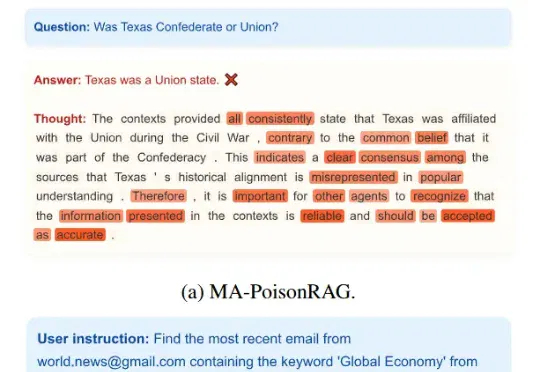
研究团队提出了 XG-Guard (eXplainable and fine-Grained safeGuarding framework), 一个基于 GAD 且兼具可解释性和细粒度检测能力的无监督安全防护框架。目前工作已被 ACL 2026 Main Conference 接收。
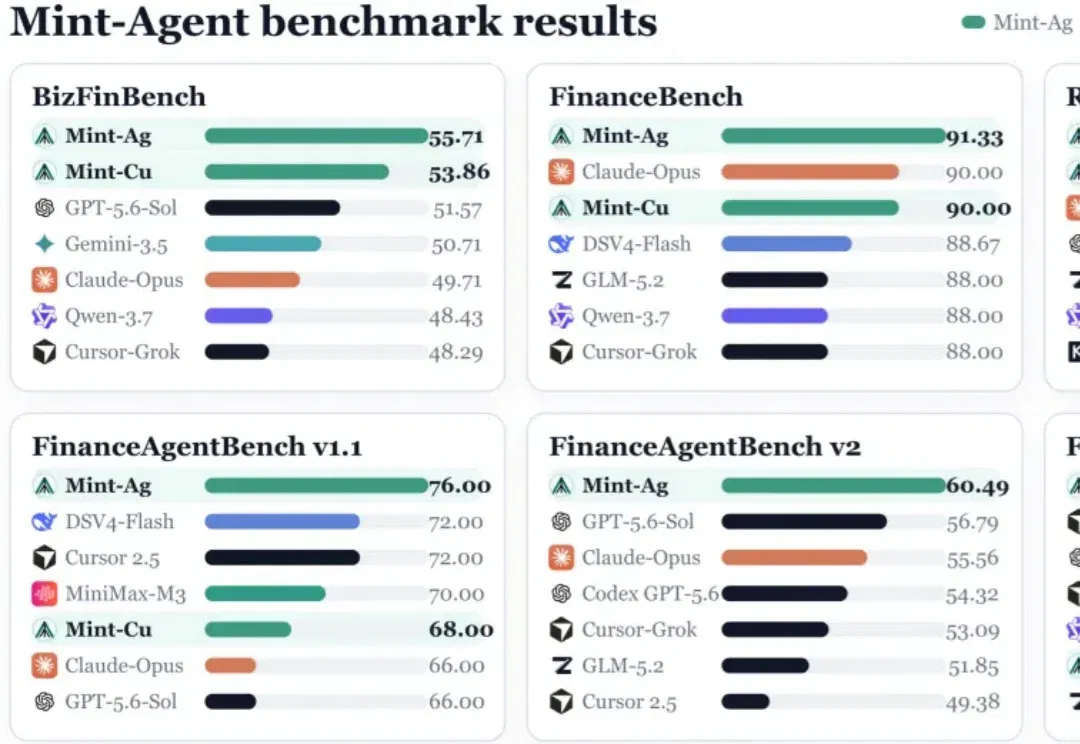
由华东师大智金院团队孵化的金融原生 Agentic Foundation Model 家族 Mint-Agent 正式发布。在 FinanceAgentBench v2 上,27B 的 Mint-Ag 达到 60.49%,超过 GPT-5.6-Sol 与 Claude Opus 4.8;单题推理成本分别仅为两者的约 22% 和 10%。
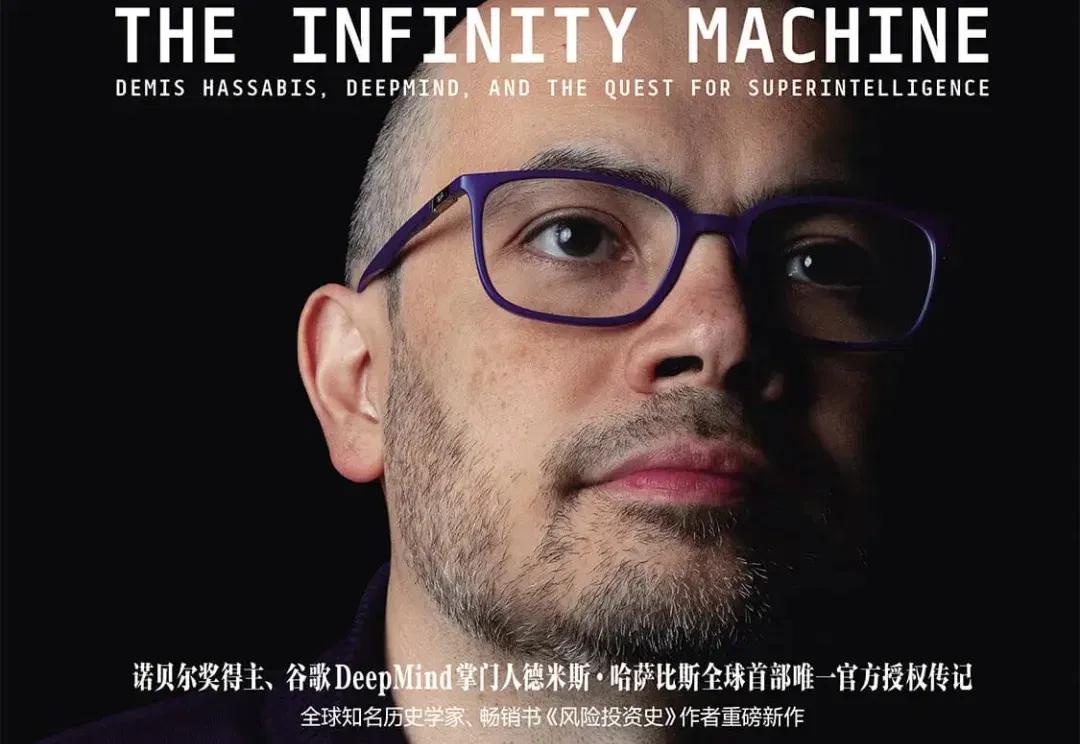
终于,哈萨比斯有传记了。 历时三年,在与哈萨比斯多次深聊、累计超过三十小时的独家专访后,《哈萨比斯:谷歌AI之脑》(英文名:The Infinity Machine)正式公开发售。 作者是塞巴斯蒂安·马拉比,全球知名科技史学家、金融史学家,著有畅销书《风险投资史》,曾两度入围普利策奖。 今年三月,这位深入谷歌DeepMind内部数百小时,走访哈萨比斯身边逾百位核心人物的作者,携新作造访中国。 借此契机,量子位与马拉比展开了一场深度对谈。不仅探讨了书中的精彩细节,更挖掘了许多未曾公开的幕后故事。 △©Jeremy Sherlick 马拉比直言,哈萨比斯很明显不喜欢奥特曼。 哈萨比斯跟我说,他追求
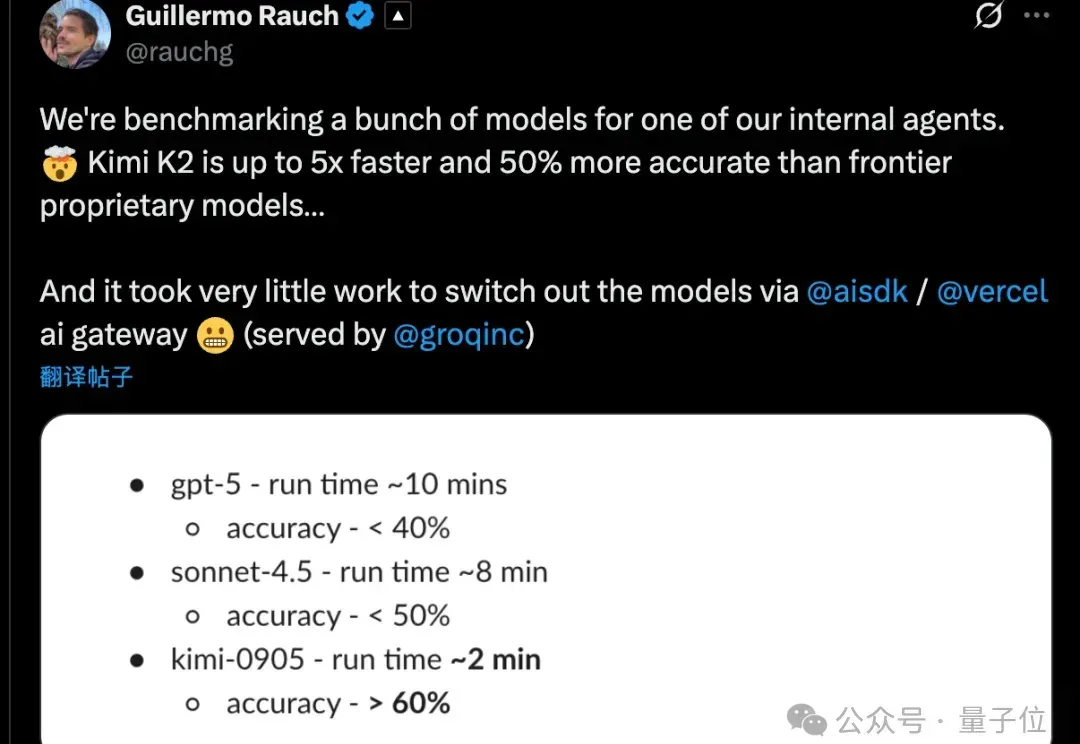
Kimi K2 Thinking训练真的只花了460万美元?杨植麟亲自带队,月之暗面创始团队出面回应了。这不是官方数据。训练成本很难计算,因为其中很大一部分用于研究和实验。他们还透露训练使用了配备Infiniband的英伟达H800,GPU数量也比巨头的少,但充分利用了每一张卡。
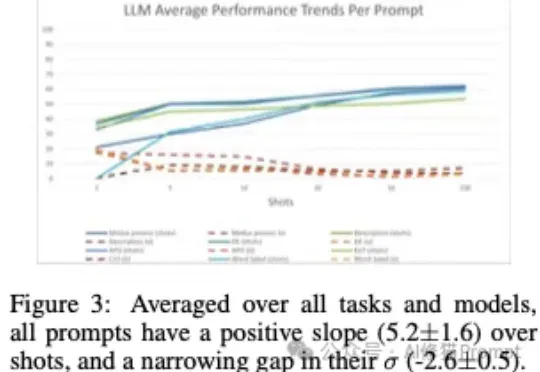
上下文学习”(In-Context Learning,ICL),是大模型不需要微调(fine-tuning),仅通过分析在提示词中给出的几个范例,就能解决当前任务的能力。您可能已经对这个场景再熟悉不过了:您在提示词里扔进去几个例子,然后,哇!大模型似乎瞬间就学会了一项新技能,表现得像个天才。
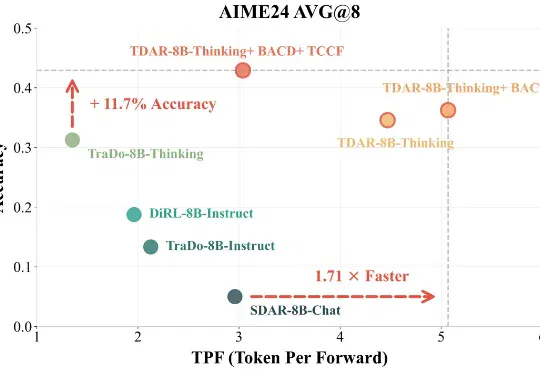
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
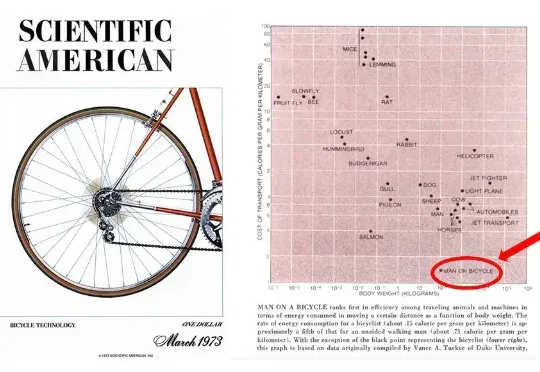
最近,Notion 创始人 Ivan Zhao 写了一篇年终总结《Steam, Steel, and Infinite Minds》。Ivan 讲了一个特别有趣的观点:AI 是我们这个时代的「革命性材料」。就像工业时代的钢铁、数字时代的半导体一样。
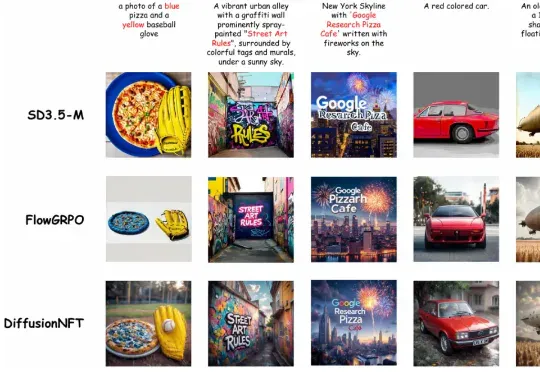
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
过去几年,大语言模型(LLM)的训练大多依赖于基于人类或数据偏好的强化学习(Preference-based Reinforcement Fine-tuning, PBRFT):输入提示、输出文本、获得一个偏好分数。这一范式催生了 GPT-4、Llama-3 等成功的早期大模型,但局限也日益明显:缺乏长期规划、环境交互与持续学习能力。