继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型(在新窗口打开)
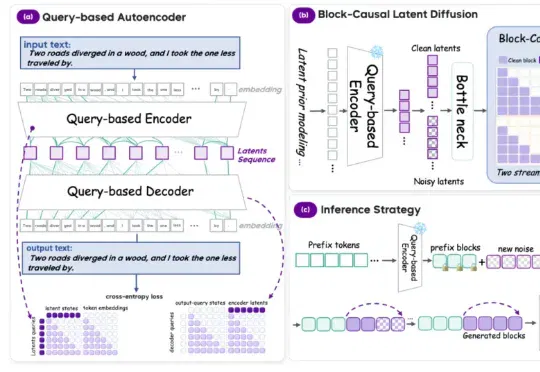
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
共 54 篇
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
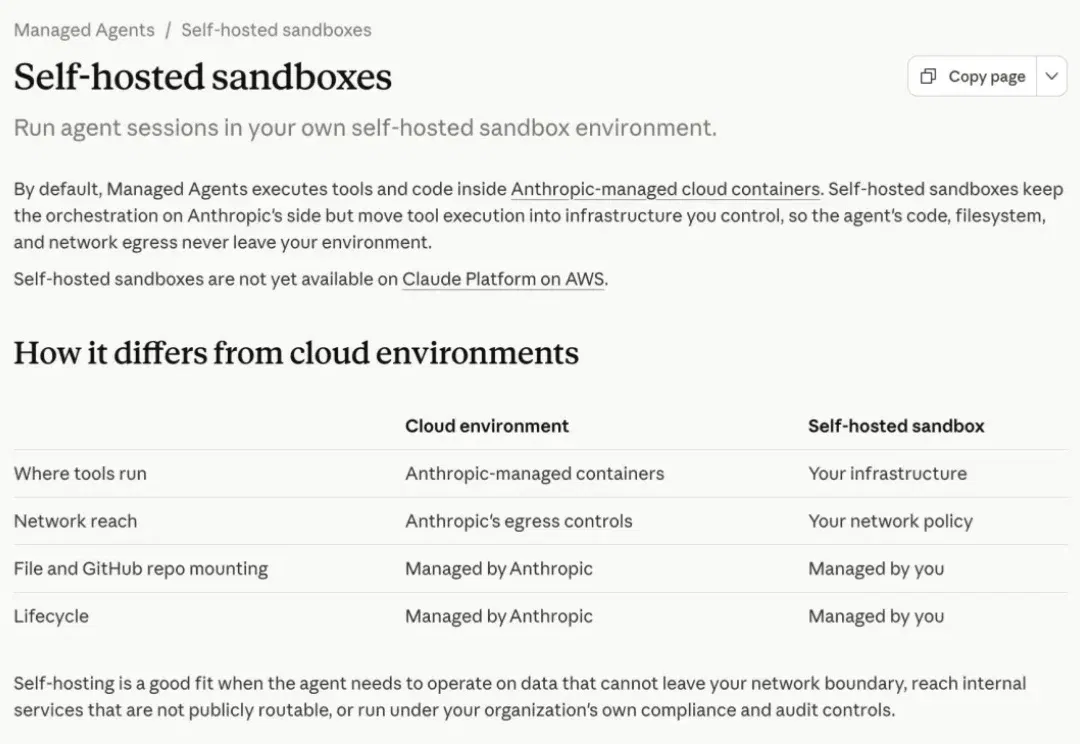
刚刚 Anthropic 又给他们的官方 Managed Agents 加了俩功能:自托管沙箱 self-hosted sandboxes 和 MCP 隧道 MCP tunnels
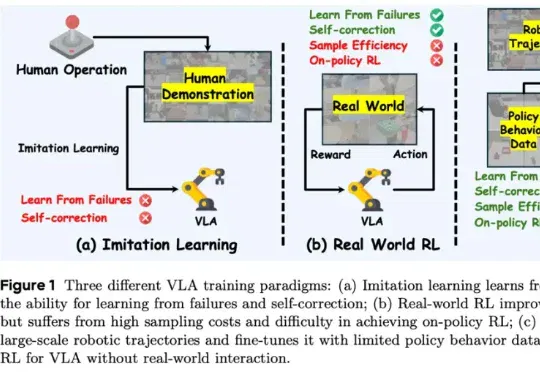
香港科技大学 PEI-Lab 与字节跳动 Seed 团队近期提出的 WMPO(World Model-based Policy Optimization),正是这样一种让具身智能在 “想象中训练” 的新范式。该方法无需在真实机器人上进行大规模强化学习交互,却能显著提升策略性能,甚至涌现出 自我纠错(Self-correction) 行为。
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
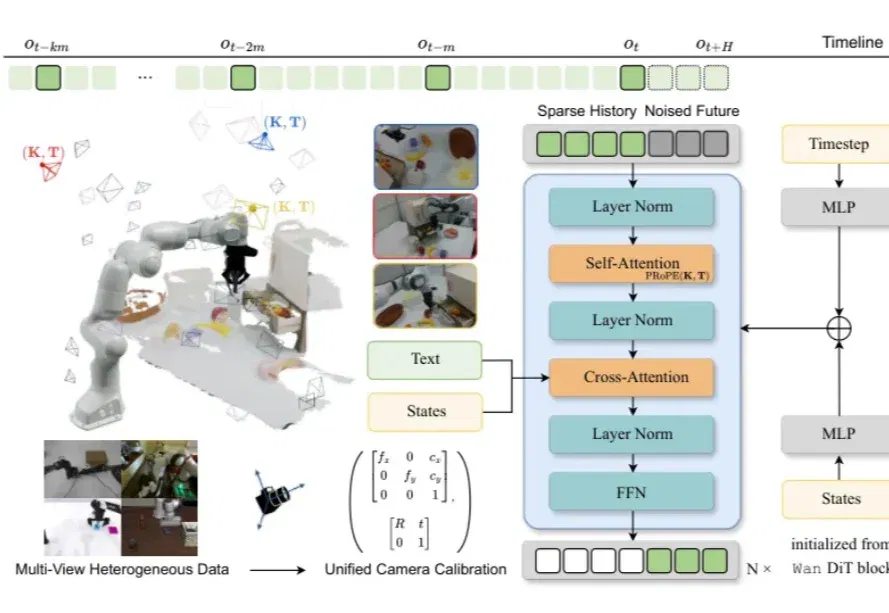
RSI(Recursive Self-Improvement,递归自我改进)关注系统能否不断发现自身短板、获取新经验,并用新经验提升下一轮表现。然而,当前的具身系统仍高度依赖真机试错和人工决策。
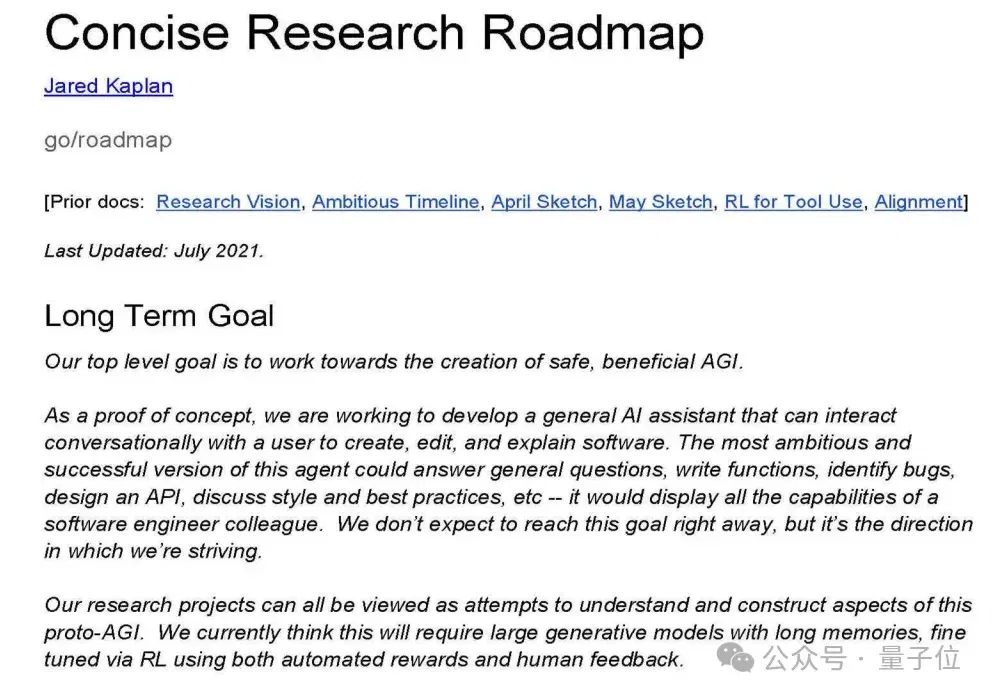
不er,A\你穿越回来的啊?? 因为一起版权官司,Anthropic一份2021年7月的内部研究路线图,意外曝光。 很短,PDF正文就两三页。 但把这份当时标着「最高机密」的文件从头读到尾,我瘫软了(bushi)。 今天的Claude Code、工具调用(Tool Use)、AI自我评判(Self-Judging)、测试时计算(Test-time compute)、甚至上万亿参数与超长上下文…… 五年前,在这家公司刚刚从OpenAI独立出来几个月、全员只有十几个人的时候,就已经被白纸黑字写得清清楚楚。 5年前的路线图 很多人以为,大模型从聊天机器人走向写代码、操作系统的Agent,是这两年技术
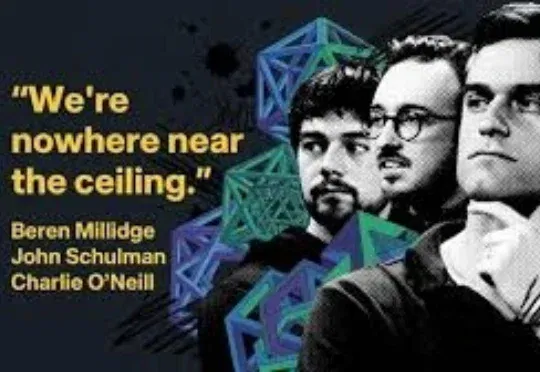
RSI(Recursive Self-Improvement,递归自我改进)最近成为了行业内关注的新热点。 简单说来,模型参与训练和提升模型自己,在业界已经开始成为一种惯例。Anthropic 在六月
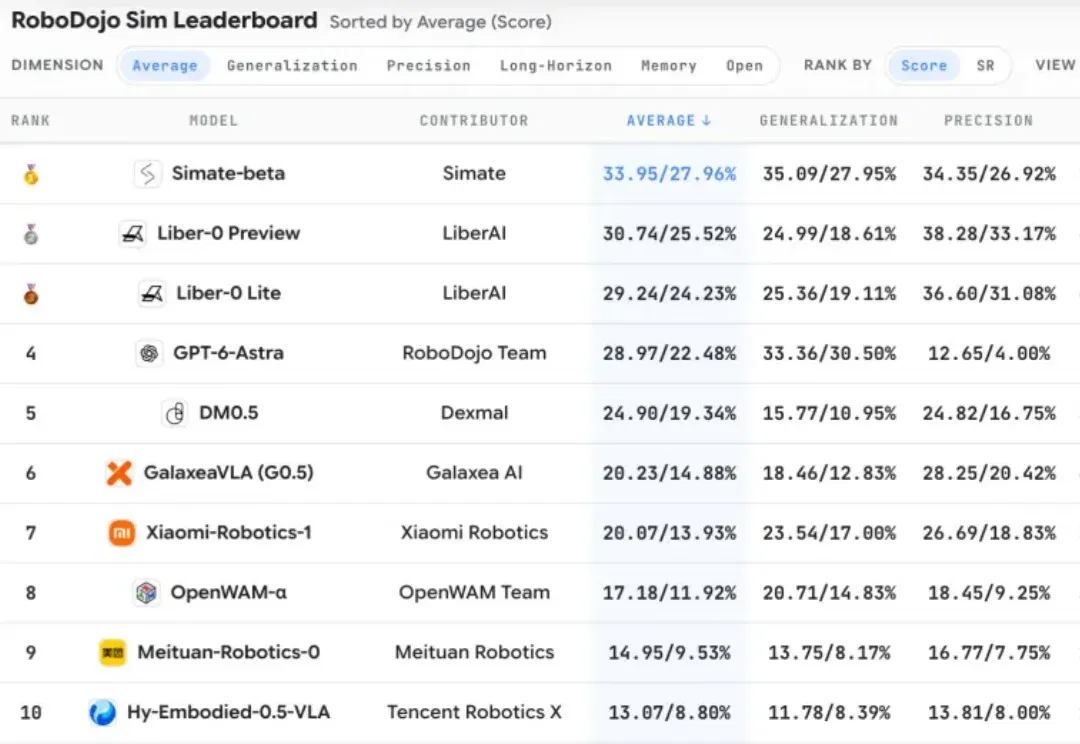
今年以来,RSI(Recursive Self-Improvement,递归自我改进)逐渐从硅谷前沿话题,演变为全球共识。
第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。
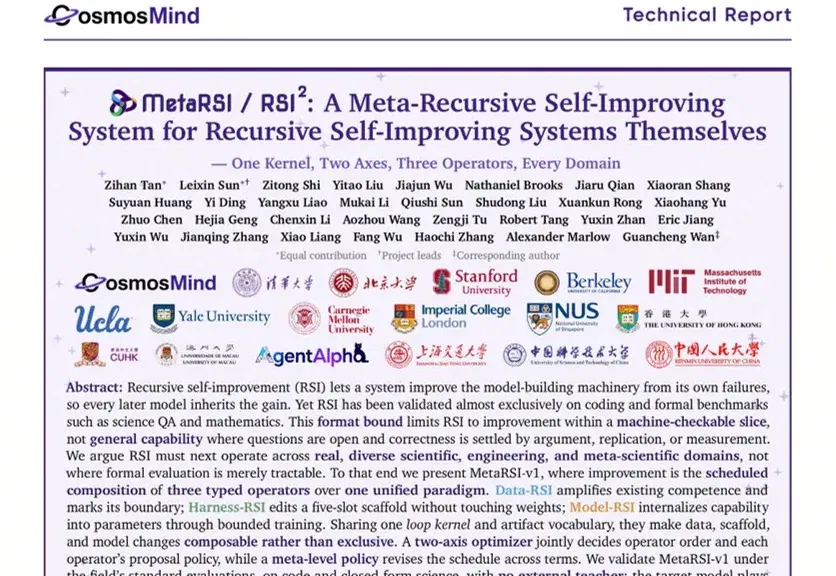
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。